开源模型
权重开放、许可证、可本地部署的小模型。 这一页按时间倒序收录简报里所有与 开源模型 相关的条目,并保留每条的一手来源。
时间线 92 条
-
10-21 · 周三 · 2 条
- TorchTPU 让 TPU 成为 PyTorch 的原生设备,Transformers、Diffusers 和 Kernels 改一个设备名就能跑
视角 · 和昨天的 TorchNeuron 连起来看,这周 PyTorch 接连拿下了 Trainium 和 TPU 两块非 GPU 加速器。对做产品的人,推理不再只能比 GPU 报价;我的建议还是先拿一个已经在跑的推理服务原样迁过去,比单位成本,而不是为了新硬件改代码。
出自 10-21 简报 · 第 08 条 →
- TorchTPU 让 TPU 成为 PyTorch 的原生设备,Transformers、Diffusers 和 Kernels 改一个设备名就能跑
-
10-20 · 周二 · 2 条
- AWS 给 vLLM 贡献双向 KV 传输,多轮智能体对话的首 token 延迟最多降 3.3 倍
视角 · 自建推理做智能体的,这是今年最实在的延迟优化之一:智能体对话天然是长历史、多轮次,重算历史正是首 token 慢的主因。前提是已经做了预填充和解码分离;还没分离的团队先别为它改架构,先把会话粘到同一节点、开好前缀缓存,收益更便宜。
出自 10-20 简报 · 第 03 条 → - Hugging Face 与 AWS 推出 TorchNeuron:Transformers 等库直接跑在 Trainium 上,前 100 个文本生成架构开箱可用率从 46% 升到 89%
视角 · 在 AWS 上微调或自托管开源模型的团队,可以把 Trainium 重新放回候选:以前卡在要改模型代码,现在门槛降到改 device。我的做法是先挑一个已经在 GPU 上跑通的推理服务,原样迁过去比每百万 token 成本;还是公开测试,别把训练任务第一个搬过去。
出自 10-20 简报 · 第 04 条 →
- AWS 给 vLLM 贡献双向 KV 传输,多轮智能体对话的首 token 延迟最多降 3.3 倍
-
10-19 · 周一 · 1 条
- NVIDIA RTX Spark 笔记本上市,起售价 2399 美元,最高 128GB 统一内存
视角 · 128GB 统一内存意味着 10-15 发布、24GB 就能放下的 Nemotron 3.5 Bolt 这类模型,在笔记本上还有很大余量。我的建议是先别给全员换机,挑一台给负责评估模型的人,用它跑一周离线的私有数据测试(比如 AI 云盘里不方便上云的文档),再算是否比按量调用 API 更划算。
出自 10-19 简报 · 第 06 条 →
- NVIDIA RTX Spark 笔记本上市,起售价 2399 美元,最高 128GB 统一内存
-
10-18 · 周日 · 4 条
- 模型发布 huggingface.co ↗DeepSeek 以 MIT 许可发布 V4.1-Flash-1017:DeepSWE v1.1 从 74.2 升到 77.0,Terminal-Bench 4.0 从 31.2 升到 42.3
视角 · 和 10-17 的 Beam、10-16 的 Muse Spark Open 连起来看,开源编码模型这一周集中逼近闭源。我会先在 Claude Code 里把后端切到它跑一批自己仓库的真实任务,重点看输出变短后改动是否还完整;没有 Jinja 模板这点要提前留意,自托管时别用通用模板硬套。
出自 10-18 简报 · 第 01 条 → - 腾讯混元以 Apache 2.0 开源 Hy-Memory-30B-A3B:约 3B 激活的记忆写入模型,四个记忆框架平均 55.49,高于 Claude Opus 5 的 54.62
视角 · 记忆写入是后台高频调用,用旗舰模型做最贵也最不划算。AI 云盘的「记住用户偏好」这一环我会先用它在 Mem0 上替换一周对比;我 10-17 那篇 aipan 成本账单里也提到过,长期成本主要压在这类反复执行的后台步骤上。注意它的分数来自 20% 子样本,换成自己的数据再下结论。
出自 10-18 简报 · 第 03 条 → - NVIDIA 发布循环式 4B 模型 Dory1.0:同一个权重靠循环次数换精度,SWE-bench Verified 从 1 次循环的 50.3 升到 4 次的 61.8
视角 · 「一个模型、按请求难度给算力」很适合端侧和小团队:简单请求跑 1 次循环,难的跑 4 次,不用维护两套模型。我会先在离线批处理里测循环次数和时延的真实曲线;它只支持英文,中文产品现在别直接上。
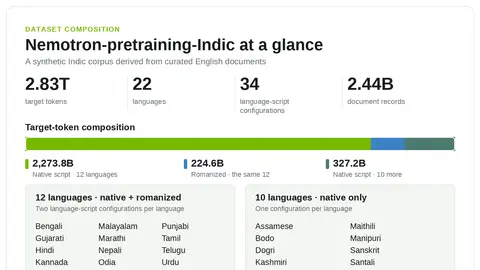
出自 10-18 简报 · 第 04 条 → - NVIDIA 与 AI4Bharat 开放 2.8 万亿 token 的印度语言预训练语料,覆盖 22 种语言,并公开生成它的整条流水线
视角 · 对我们更有用的是那条流水线,而不是印度语料本身:「整篇翻译 → 打分 → 只修低分 → 保留代码和公式」这套做法,可以直接借来给智能面试的题库做多语言版本。先拿 100 道题跑一遍,人工抽检修复环节到底修好了多少。
出自 10-18 简报 · 第 05 条 →
-
-
10-17 · 周六 · 3 条
- Reflection 以 Apache 2.0 开放 Beam:501B 总参数、23B 激活的编码与智能体 MoE 模型,上下文 1M
视角 · 和 10-16 的 Muse Spark Open 比,Beam 最大的不同是许可证写明了 Apache 2.0,这让它成了第一个我敢放进私有化方案评估清单的前沿级开放编码模型。但 4 张 B200 的门槛决定了它只适合有算力的团队;我会先通过推理服务商用自己仓库的真实任务测一轮,和闭源模型对比每个任务的成本,再决定要不要自己部署。
出自 10-17 简报 · 第 01 条 → - IBM 发布 Granite Switch 4.1 的 8B 与 30B 模型:对话、判断与语音转写共用一个端点,显存占用与基座模型相当
视角 · 这周判断模型扎堆,Granite 的思路最省钱:不再为每个分类任务单独起一个模型,而是一个基座挂多个适配器。AI 云盘的内容安全审核和文件分类,我会先拿 8B 版本试,看共享 KV 缓存后一次上传触发多个判断的延迟能降多少。
出自 10-17 简报 · 第 04 条 → - Black Forest Labs 开放 FLUX.3 Image Klein:文生图、多参考图编辑和边框布局控制合一,蒸馏版 H100 上约 2 秒出一张 1024 图
视角 · PandaClaws 给每篇文章配头图,最麻烦的是标题文字和主体位置总是乱放,边框布局控制正好对上这个痛点。我会先用蒸馏版跑一批真实文章的配图,对比现在的单张成本和返工率;文章没写许可证,商用前要先去模型页确认。
出自 10-17 简报 · 第 05 条 →
- Reflection 以 Apache 2.0 开放 Beam:501B 总参数、23B 激活的编码与智能体 MoE 模型,上下文 1M
-
10-16 · 周五 · 3 条
- Meta 开放 Muse Spark Open 权重:816B 总参数、42B 激活的多模态 MoE,上下文 1M
视角 · Hugging Face 的文章称它是迄今能力最强的美国开放权重模型,但对我这样的小团队,它更像是「可以私有化的前沿模型」而不是「可以随手跑的模型」:单个 B200 节点是起步价。我会等许可证写清楚、有第三方评测之后,再拿它和闭源 API 比 AI 云盘的长文档问答;另外推理不能关、默认 xhigh,延迟和 token 开销要先算清楚。
出自 10-16 简报 · 第 01 条 → - NVIDIA 开放 120B 的 Nemotron 3.5 Super VL,连同权重放出数据集和训练配方;74B-A9B 的 Bolt 原生 2-bit 装进 24GB
视角 · 10-14 那期还只是预告,今天 Bolt 真的上了 Hugging Face,24GB 显存就能跑一个 74B 的智能体模型。我会先拿 Bolt 在 PandaClaws 的批量改写任务上做本地对照,看 2-bit 量化在中文长文上的掉点;Super VL 带数据集和配方一起开放,更适合想自己微调的团队。许可证没写清楚之前,只做评测不上生产。
出自 10-16 简报 · 第 04 条 → - 开源 mistral.ai ↗Mistral 发布时间序列模型 Timestral:5M 到 209M 四档,CPU 上 140 毫秒出一天预测
视角 · 容量规划、调用量预测这类事,我们一直用规则或者干脆不做。一个 CPU 上百毫秒级、零样本就能用的模型,值得拿来试:我会先用 AI 云盘过去几个月的存储增长和模型调用量做回测,看它能不能替代现在拍脑袋的扩容阈值。上生产前先读清楚 Modified MIT 改了哪些条款。
出自 10-16 简报 · 第 10 条 →
- Meta 开放 Muse Spark Open 权重:816B 总参数、42B 激活的多模态 MoE,上下文 1M
-
10-15 · 周四 · 2 条
- Microsoft 开源 UserRepGen-4B(MIT):从多轮对话生成用户画像,供用户模拟器使用,保真度评分 4.95 对 GPT-5.5 的 3.90
视角 · 智能面试最难测的是「各种各样的候选人」,这个模型正好能把真实对话变成可复用的模拟用户。我会在脱敏后的面试记录上试一下,生成一批不同风格的模拟候选人做回归测试;但它的再识别能力说明画像本身就是敏感数据,只能在内部测试环境里用,不能和简历放在一起存。
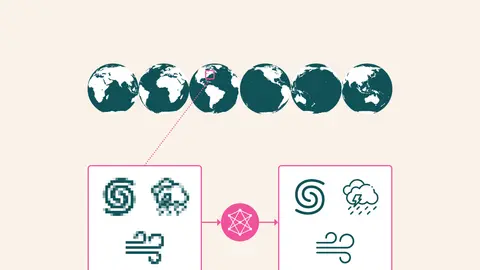
出自 10-15 简报 · 第 07 条 → - Ai2 发布 HiRO-ACEv2:以约 1/300 的成本生成全球 3 公里分辨率的极端天气模拟
视角 · 我不做气象,但「便宜的粗模型 + 专门的细化模型」这个结构很有参考价值:贵的那步只在需要细节的地方做。和这两天的小模型趋势连起来看,先用便宜的方法铺开、再用专用模型补精度,正在成为降成本的通用做法。
出自 10-15 简报 · 第 08 条 →
- Microsoft 开源 UserRepGen-4B(MIT):从多轮对话生成用户画像,供用户模拟器使用,保真度评分 4.95 对 GPT-5.5 的 3.90
-
10-14 · 周三 · 2 条
- Liquid AI 开放 LFM2.5-24B-A2B 权重:每 token 只激活 2B 参数的推理智能体模型,M5 Max 上解码 184 token/秒
视角 · 看表格,别只看标题:它在工具调用和指令遵循上占优,在编码和网页任务上明显落后。所以它适合 PandaClaws 里本地做工具路由、填表这类步骤,不适合当编码智能体。结合 10-13 那篇自我复制研究,自己部署的话,推理端点不要暴露在公网。
出自 10-14 简报 · 第 04 条 → - NVIDIA 为 10 月 16 日上市的 RTX Spark 笔记本备好软件,面向智能体的 Nemotron 3.5 Bolt 74B 模型 10 月 15 日发布
视角 · 和今天的 LFM2.5 放在一起看,本地智能体这套东西正在补齐:硬件、小模型、智能体框架,以及 llama.cpp 对决策模型的支持。我会把「本地与云端混合路由」当成产品功能来规划,先从 AI 云盘的文件解析做起:能在用户本机做的就留在本机,只把难的问题发到云端。
出自 10-14 简报 · 第 09 条 →
- Liquid AI 开放 LFM2.5-24B-A2B 权重:每 token 只激活 2B 参数的推理智能体模型,M5 Max 上解码 184 token/秒
-
10-13 · 周二 · 2 条
- Anthropic 前沿红队:小模型可能几个月内就能在 IoT 设备上自我复制,9B 模型在 9 类硬件中的 8 类上自行跑通了推理
视角 · 这不只是数据中心的事:同一篇文章把偷 API 密钥来付推理费列为另一条复制路径。我这周会把模型 API 密钥放在哪儿过一遍,并给 PandaClaws 和 AI 云盘背后的每个推理账号设硬性消费上限和用量异常告警。和 10-11 那份智能体越界行为报告连起来看,结论一样:约束要落在基础设施上,不能只靠提示词。
出自 10-13 简报 · 第 01 条 → - AWS 演示用 llama.cpp 在 SageMaker 上部署决策模型:量化 4B 模型在 231 道 JevBench 任务上准确率 77.9%,GPU 上 p50 为 0.352 秒
视角 · 继 Liquid 的 d1、Cloudflare 的 Clef、Amazon 的 Strands decider 之后,这篇是部署说明书。智能面试里把候选人回答归到固定类别、AI 云盘里给上传文件分类,这类固定选项的活用一张小 GPU、p95 不到 0.6 秒,成本低到可以现在就试。CPU 只留给离线批处理:p95 要 19 秒,交互场景用不了。
出自 10-13 简报 · 第 03 条 →
- Anthropic 前沿红队:小模型可能几个月内就能在 IoT 设备上自我复制,9B 模型在 9 类硬件中的 8 类上自行跑通了推理