开源模型
权重开放、许可证、可本地部署的小模型。 这一页按时间倒序收录简报里所有与 开源模型 相关的条目,并保留每条的一手来源。
时间线 92 条
-
10-12 · 周一 · 3 条
- Qwen 开放 Qwen-Image-2.1-Turbo 权重:7B 图像模型,8 步出图,研究许可
视角 · 8 步意味着同一张卡上出图快得多,PandaClaws 这类要批量出封面、改图的后台很适合先拿它做速度和质量测试。但它是研究许可,不是 Apache 2.0,进生产前先让法务读条款,别因为权重能下载就默认能商用。
出自 10-12 简报 · 第 01 条 → - 腾讯开放 5B 全模态解析模型 Youtu-Parsing-Omni,OmniDocBench v1.6 总分 96.96
视角 · AI 云盘的文件理解现在是按格式分几条管线走的,一个 5B 模型同时吃 PDF、截图和音视频,值得拿真实用户文件做一轮对比,和 10-09 那条 LightOnOCR-3 放在一起测。注意它是自定许可证,先确认能否商用。
出自 10-12 简报 · 第 02 条 → - Amazon 开放 Strands decider 决策模型:2B、12B、26B-A4B 三档,Apache 2.0
视角 · 一周之内 Liquid AI、Cloudflare、Amazon 先后放出决策模型,这个品类已经成形。智能体里「该调哪个工具、参数对不对、要不要拦」这类判断,我会先用 2B 版接在智能面试的路由上试,按模型页的提醒拿自己的流量定置信度阈值;本地服务没有鉴权,别直接暴露到内网之外。
出自 10-12 简报 · 第 03 条 →
- Qwen 开放 Qwen-Image-2.1-Turbo 权重:7B 图像模型,8 步出图,研究许可
-
10-11 · 周日 · 1 条
- Cloudflare 开源多模态决策模型 Clef-omni,Clef-flash 输入价从每百万 0.09 美元降到 0.038 美元
视角 · 和 10-09 那条 Liquid AI 的 d1 连起来看,「决策模型」正在成为一个独立品类:审核、分类、路由这类只需要选一个答案的活,不必再用生成模型。PandaClaws 里图片和视频的内容审核,我会先拿 Clef-omni 做一轮对比测试;用 Clef-flash 的要注意上下文降到了 24k。
出自 10-11 简报 · 第 05 条 →
- Cloudflare 开源多模态决策模型 Clef-omni,Clef-flash 输入价从每百万 0.09 美元降到 0.038 美元
-
10-10 · 周六 · 1 条
- Google 以 Apache 2.0 开源端侧 GPU 推理引擎 ML Drift,Gemma 内存开销最多低 12%
视角 · 和 10-07 的 EmbeddingGemma 2 放在一起看,端侧语义检索的模型和引擎都齐了。AI 云盘这类产品可以先在网页端用 WebGPU 试一版本地向量化,把隐私敏感文件留在用户设备上;还在用 TFLite GPU delegate 的项目,该排迁移计划了。
出自 10-10 简报 · 第 06 条 →
- Google 以 Apache 2.0 开源端侧 GPU 推理引擎 ML Drift,Gemma 内存开销最多低 12%
-
10-09 · 周五 · 3 条
- LightOn 开源 LightOnOCR-3:0.8B 到 4B 三个尺寸,Apache 2.0,olmOCR-Bench 最高 86.3
视角 · 0.8B 只比 4B 低不到 1 分,这对 AI 云盘的文档解析很有吸引力:我会先拿用户上传最多的扫描件和带表格的 PDF 做一轮对比,看能不能把一部分解析从云端 API 挪到自己的机器上。
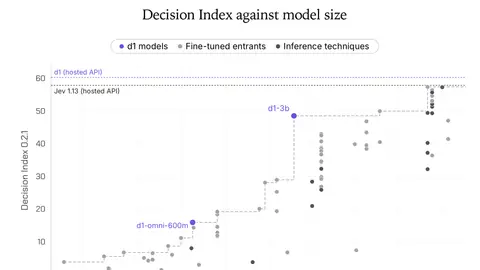
出自 10-09 简报 · 第 06 条 → - Liquid AI 开放 d1 决策模型:d1-3B 一次前向给出判断,RTX 4090 上单题 8 毫秒
视角 · 内容审核、路由、是否需要转人工这类「是或否」的判断,没必要每次都调生成式大模型。我会把 PandaClaws 里的发布前合规判断拿来试 d1-3B,但许可证没写清之前只做评估、不上线。
出自 10-09 简报 · 第 07 条 → - NVIDIA 微调 Nemotron 拿下 IOI 2026 535.4/600、IMO 2026 30/42 金牌线成绩,并开放权重与训练数据
视角 · 550B 的模型多数团队用不上,真正值得拿走的是方法:Nano(30B 总参、3B 激活)在 IOI 2025 上从 SFT 后的 280 分靠 GenCorrect 这类测试时策略提到 468 分。做代码类产品的,可以先在自家评测集上试「生成后再自我纠错」这一层。
出自 10-09 简报 · 第 08 条 →
- LightOn 开源 LightOnOCR-3:0.8B 到 4B 三个尺寸,Apache 2.0,olmOCR-Bench 最高 86.3
-
10-07 · 周三 · 2 条
- 模型发布 mistral.ai ↗Mistral Large 4 公开预览:1T 总参数、49B 激活,API 每百万 token 输入 1.36 美元,权重月底开放
视角 · 输入 1.36 美元、输出 4.18 美元,这个价位已经值得把 PandaClaws 的长文生成和多语种改写拿去比一轮。但现在只是预览,权重和许可证都还没出,我会先用 API 跑自己的评测集,等月底权重和许可条款落地再决定要不要考虑自部署。
出自 10-07 简报 · 第 01 条 → - Google 开源 EmbeddingGemma 2:270M 到 740M 的多模态向量模型,代码检索比上一代高 14%,Apache 2.0
视角 · 这条和 AI 云盘最直接相关:图片、视频、录音和文档进同一个向量空间,就能用一句话跨类型搜文件,不用再为每种格式各接一套模型。我会先拿 270M 的文本版替换现有向量模型做对比,再按需加载视觉模块;128 维截断能把索引存储压下来,但要先在自己的检索集上测召回掉多少。
出自 10-07 简报 · 第 02 条 →
-
-
10-06 · 周二 · 1 条
- Aleph Alpha 开源 Kolibri:78B MoE 每 token 激活 3.46B,验证到 100 万 token 上下文,Apache 2.0
视角 · 每 token 只激活 3B 多、单卡能跑,又是 Apache 2.0,这类模型很适合 AI 云盘这种要私有化部署的长文档问答。不过它只做德英两种语言,中文场景别直接上;我更想拿它验证的是「滑窗注意力 + 长上下文」在自己硬件上的真实吞吐,再决定下一个自部署模型怎么选。
出自 10-06 简报 · 第 01 条 →
- Aleph Alpha 开源 Kolibri:78B MoE 每 token 激活 3.46B,验证到 100 万 token 上下文,Apache 2.0
-
10-05 · 周一 · 1 条
- Ai2 开源 AstaBrief 8B:一次生成带引用的研究报告,比 Claude 驱动的模式快约 3.5 倍
视角 · 「检索后写成带引用的长文」是 AI 云盘文档问答最常见的需求,8B 小模型能在一次调用里做完,意味着可以私有化部署、把成本压下来。我会先拿自己的文档集对比引用准确率,再决定是否替掉现有的大模型调用。
出自 10-05 简报 · 第 02 条 →
- Ai2 开源 AstaBrief 8B:一次生成带引用的研究报告,比 Claude 驱动的模式快约 3.5 倍