2026-11-18 · 周三 · 10 条 OpenAI 发布 GPT-6.2 Astra 与 Sol、微软 Ignite 推出 MAI Code 2、GitHub 与微软用 AI 帮 6 个开源项目修掉 55 个漏洞
今天的主线是编码智能体的瓶颈从「写」转到「验」:一天之内 Copilot 多了 GPT-6.2 和 MAI Code 2 两组新模型,GitHub 同时补上了按风险分配的代码审查、技能与 MCP 工具的评测,以及只送核实结果的漏洞修复流程。模型换得越快,能不能用自己的数据判断好坏就越重要。
-
- 11 月 17 日 OpenAI 发布 GPT-6.2 Astra 与 GPT-6.2 Sol 两个型号。
- 官方列出的改进:专业产出更好,编码与电脑操作(computer use)更强,效率更高,成本更低。
- 两个型号同时覆盖 ChatGPT Work、Codex 与 API。
开发者视角官方 RSS 只给了方向,没给价格和分数,我不会凭这个就切。好在同一天 GitHub Copilot 和 Amazon Bedrock 都上了这两个型号,GitHub 称 6.2 Sol 在代码审查里找出的真实问题接近 6.1 Sol 的两倍。我的做法是:先把代码审查这一环换到 6.2 Sol,用自己仓库最近 20 个 PR 回放,看找到的问题和误报各多少,再决定主力编码模型要不要动。
-
- 新一代旗舰编码模型 MAI Code 2 面向上线、深度调试、多文件实现、全仓推理和 UI,微软称成本只是前沿模型的一小部分;Code 2 Flash 面向解释代码、定点修改等高频轻任务。两者当天在 GitHub Copilot(模型选择器与 Copilot Fusion)和 Foundry 正式可用。
- 宣布 MAI Licensed Weights:受信任的客户可通过 Frontier Co 获得微软 AI 模型的权重。
- Microsoft-Decision-1.1 正式可用并加入多模态,已有 4,000 多家客户用过;GPT 6.2 与 Meta 最新模型将进入 Foundry。
- Agent 365 中已有超过 5,000 万个智能体,新推出统计 AI 支出与产出的 Agent 365 Business Analytics;智能体安全系统 Perception 正式可用,并发布安全模型 Cyber 2 Flash。
开发者视角MAI Code 2 进了 Copilot 的模型选择器,在用 Copilot 的团队今天就能同题对比,不用另接 API。我会把它放在 Code 2 Flash 跑 PandaClaws 后台的日常小修小改,用一周的返工率和单任务成本说话。权重授权这一条暂时离我们很远,但对有数据驻留要求的大客户是个新选项,值得记下。
-
- Adaptive(公开预览)根据每个 PR 的复杂度与风险在 Lite、Balanced、Max 三档中选择,并在审查中标明选了哪档;不会超过企业、组织或仓库设定的最高档,默认档仍是 Balanced。
- 跨仓库上下文(公开预览,限公开仓库):审查时能读取相关公开仓库,找出依赖本次改动的代码以及其他仓库里的文档、自定义指令和技能。
- 密钥检测(公开预览):用正则识别来自 150 多家合作方的 500 多种已知格式密钥,再用 LLM 和 GitHub 自研模型找没有固定格式的密钥。
- 以上功能面向 Copilot Pro、Pro+、Max、Business 与 Enterprise;每个仓库的 Insights 里可以看审查意见被处理和采纳的情况。
开发者视角我会先把 Adaptive 设成仓库默认,同时把最高档限在 Balanced 跑两周,看它把多少 PR 判成 Lite,再决定要不要放开 Max,避免成本悄悄上去。密钥检测建议直接打开,AI 智能体写代码时顺手把测试用的 key 写进配置是很常见的事,和 11-13 那条 AI Scan 接口放在一起,代码安全这块 GitHub 在补得很快。
-
- 在 Copilot 里用自然语言或 /eval 命令,为项目中的技能、自定义智能体或 MCP 工具创建评测;评测会检查结果,也检查智能体完成任务的过程。
- 每次运行前需要用户批准;可以看到哪些检查通过、哪些失败及原因,并对比改动前后两次运行。
- 评测引擎是可扩展的本地评测工具 Vally。
- 可在 VS Code 扩展、Copilot CLI 插件和 Copilot app(添加 github/evals 市场)中安装,面向 Copilot Individual、Business 与 Enterprise 公开预览。
开发者视角这是我最想要的一条。我们给编码智能体写了一堆技能,改了之后基本靠感觉判断效果,模型一换更说不清。我会先给最常用的三个技能各写 5 个评测用例,每次改技能或换模型(比如今天的 GPT-6.2、MAI Code 2)就跑一遍,把结果留档。
-
- 微软的多模型智能体扫描系统 Codename MDASH 用 MAI Cyber 模型扫描 AutoGPT、Caddy、Express、FastMCP、ImageMagick、Netty 六个项目,均为 GitHub Secure Open Source Fund 成员,扫描前征得维护者同意。
- 流程:MDASH 标出数千条疑似问题并给出修复建议,GitHub Security Lab 的 AI 分诊智能体去重、验证,再由 7 名微软 FORGE Lab 研究员逐条人工核实,最后通过私密漏洞报告附带 PoC 和修复建议发给维护者。
- 维护者共收到 99 份报告,截至 11 月 15 日已修复 55 个,其中 14 个已进入正式版本。
- 首批修复在初次扫描约一周后发布;Caddy 收到 22 份报告,全部在一周内修完。
开发者视角数千条到 99 条,这个漏斗本身就是结论:AI 扫描的价值在过滤和核实,不在数量。我们自己接 AI 安全扫描时,也要求它只出带复现步骤和补丁的结果,否则宁可不出。FastMCP 在名单里,用它搭 MCP 服务的团队可以去看看最近的版本说明,确认自己已经升级。
-
- Agent Host Protocol(AHP)是先在 VS Code 构建、再在 GitHub 各产品采用的开放标准,让智能体会话在一处开始、在另一处继续,不再随编辑器窗口关闭而结束。
- 协议以 URI 标识的 channel 为单位:每个服务端必须实现 root、session、chat 三个 channel,可选终端、MCP、OTel 等扩展;每个 channel 内是 reducer 式状态,服务端裁决状态,客户端发送动作,断线重连和回放因此简单。
- 已有 Rust、TypeScript、Kotlin、Swift、.NET 与 Go 的库;可在 Copilot app(Experimental > Direct Connections)和 VS Code 中连接自己实现的 agent host,用 code agent host 可启动独立的 VS Code agent host。
开发者视角我们后台智能体的状态现在散在日志和数据库里,这套「服务端是唯一状态、客户端只发动作」的设计值得直接抄。哪怕不打算接 Copilot,我也会让 PandaClaws 的发布智能体把会话状态整理成 reducer 式结构,以后接手机端或看板都省事。和 11-13 那条常驻智能体架构一起看,智能体正在从一次请求变成一个可接入的长期会话。
-
- Linked billing 以测试版上线,需带 user-profiles-billing-2026-10-01 测试头。
- 客户关联自己的 Claude 组织后,可在每个 /v1/messages 或 /v1/chat/completions 请求上设置 billing_policy,决定这次由谁付费。
- 客户可在 Claude Console 为某个应用设置支出上限,或解除关联。
- 仅适用于直接向 Anthropic 支付 API 费用的客户组织。
开发者视角这对 PandaClaws 这种按用量波动很大的产品很实用:大客户用自己的 Claude 合同付模型费,我们只收平台费,毛利不再被重度用户拖垮。按请求设 billing_policy 也意味着可以混用,试用期我们付、正式使用客户付。要注意的是只对直接付费给 Anthropic 的组织有效,走云市场采购的客户暂时用不上。
-
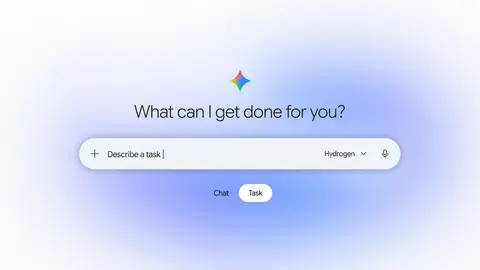
- 入口:在 Gemini app 里把 Chat 切到 Task,或在 Android、iOS 上用短信(RCS)发给 Gemini,或把邮件转发到 gemini@google.com;可同时致电多家商户预约(通话时声明自己是 AI,商户可选择退出)。
- 基于 Gemini 4 Hydrogen,免费向美国、日本、韩国、加拿大、澳大利亚和印度的数亿用户推出,部分高级功能先在美国上线。
- 购物通过 Agent Payments Protocol(AP2)完成,与 Mastercard、Visa 合作(American Express 即将加入),使用数字令牌;可预先设定硬性支出上限,收据进 Google Wallet,之后会接入 Universal Commerce Protocol。目前连接 60 多款应用,开发者可申请加入 Connected Apps Platform。
- 每个任务在 Google Cloud Agent Compute Engine 上、专属于该账户的硬件隔离虚拟机里执行,另有提示注入过滤和 Safe Browsing 限制可打开的链接。
开发者视角和 11-13 那条 ChatGPT Wallet 连起来看,两家都把「智能体花钱」做成了默认能力,而且都靠额度和审批兜底。我们的产品如果有付费或预约环节,现在就该想清楚怎么对接 AP2 这类协议,以及被智能体访问时页面能不能用。另外每个任务一台隔离虚拟机的做法,可以作为我们后台智能体处理用户凭据时的参照线。
-
- AgentCore gateway 中的 Web Search Tool 与 Web Search API 每月共有 5,000 次免费查询,无需设置,自动生效。
- 额度在支持的区域之间、并由组织内所有账户共享,每月重置;超出部分按标准价计费,不中断智能体运行。
- 覆盖区域:美国东部(弗吉尼亚北部、俄亥俄)、美国西部(俄勒冈)、欧洲(爱尔兰)、亚太(悉尼、东京)。
开发者视角按 11-11 那条每千次 7 美元算,这相当于每月 35 美元的额度,不大,但足够覆盖开发、测试和小流量的内部工具。要注意额度是整个组织共享的,生产流量一上来,测试账户会和线上抢同一份额度,最好在预算里单独给搜索设告警。
-
- 稠密注意力的单 query 成本随上下文长度增长,在 128K token 时可占一层预填充时间的大部分;模型级稀疏注意力让每个 query 只关注一小部分 key,但打分全部 key 的工作转移到仍处理完整上下文的 indexer。
- 设计建议:indexer 用单个 key head 并做跨头归约;indexer 的 head 维度取 128 或 256;epilogue 与累加用 FP16;通过压缩、分层索引或索引共享减少需打分的 key。
- Guess-Verify-Refine 把上一步解码的选择当作猜测、一次扫描验证,在 DeepSeek V3.2 与 V4 解码中比标准 radix select 快 2.1 到 2.4 倍;融合实现已在 TensorRT LLM,FlashInfer 有开源的融合 indexer 与 Top-k。
开发者视角我们不训练模型,但这篇解释了为什么 DeepSeek 这类稀疏注意力模型在长上下文上便宜。AI 云盘做整份文档问答时,我会优先挑用了稀疏注意力的开源模型,并确认推理框架用的是 TensorRT LLM 或 FlashInfer 的融合实现,否则长文本的成本优势会被吃掉一大半。
本期由 AI 辅助检索与起草,选题标准与观点由 Darius 设定。
每周一,一封邮件看完 AI 大事
每周一早上,把过去 7 天最值得关注的 6 件 AI 大事和我的解读发到你邮箱。
邮箱只用于发送周报,不会提供给任何第三方;每封邮件底部都可以一键退订。 看看最近一期 →