2026-11-19 · 周四 · 10 条 Google 发布 Gemini 4 Neon、Cloudflare 开放 Clairic 抽取模型权重、Airbnb 公开按单任务成本选编码模型的方法
今天的主线是「按单任务成本选模型」:Google 用 Neon 在 Carbon 和 Hydrogen 之间补了一档,直接拿单任务成本比 Carbon 低 32% 做卖点;Airbnb 公开了五周八个新模型怎么靠自有任务和单任务成本来定默认;Cloudflare、Rumble 则把抽取和转写这类窄任务交给更小的开源模型。模型越多,越要把每类任务配到够用又最便宜的那一个。
-
- 定价:每百万输入 token 3 美元,缓存输入 0.15 美元(比未缓存便宜 95%),输出 15 美元;上下文 100 万 token。
- xhigh 思考档在 Artificial Analysis Intelligence Index 上得 61 分,总排名第 3;默认 high 档单任务成本比 Gemini 4 Carbon 低 32%。
- 当天在 Gemini API(AI Studio 付费层)、Antigravity 与 Gemini 应用(AI Pro 和 Ultra 订阅)上线。
- 同日 GitHub Copilot 宣布 Gemini 4 Neon 正式可用,面向 Pro+、Max、Business 与 Enterprise,按服务商标价计费。
开发者视角Neon 的价格正好夹在 Hydrogen(11-13 那条,1.50 / 7.50 美元)和 Carbon 之间,又赶在 Carbon 12 月涨价之前,意图很明显:把原本跑在 Carbon 上的日常智能体任务接过来。我的做法是把正在用 Carbon 的任务按 high 档复跑一遍,比的是单任务成本和成功率,而不是单价;长上下文场景记得把缓存用上,0.15 美元的缓存价才是真正省钱的地方。
-
- 新版 Clairic 改用并行槽位自回归生成,每个字段各自生成并在自己的结束符处停止;仍返回置信度、字符位置与概率。
- 新增 PDF 读取,一次请求最多 4 张图片或 PDF 页;内部基准上图片读取错误从 207 个降到 0 个,响应时间在 1 秒以内。
- 27B 的 Clairic 每百万输入 token 0.24 美元,9B 的 Clairic-flash 0.10 美元,不收输出费用;12 月 1 日前两者都按 0.10 美元。
- 两个模型的完整权重都已发布在 Hugging Face。
开发者视角AI 云盘上传文件后要抽标题、日期、金额这类字段,这种活用通用大模型既贵又不稳,Clairic 这种「只做抽取、带置信度」的专用小模型正好对口。我会先用 12 月 1 日前的优惠价拿 27B 版跑一批真实票据和 PDF,把低置信度的字段转给大模型兜底;它的评测是 Cloudflare 自测,要用自己的样本验证。
-
- Airbnb 每周有数千名工程师及相关人员用内部工具 AirChat 跑编码智能体,请求经过跑在 Amazon Bedrock 上的模型网关。
- 约五周内出了 8 个新模型;到 10 月中,约三分之二的编码智能体请求已转向这些新模型。
- 某个模型推理力度从 low 调到 high,分数只升 0.8 分,单任务成本却是 2.5 倍;网关据此强制执行每个模型的力度上限。
- 有个新模型在同一套任务和评分器上分数更高,单任务成本只有原模型的约六分之一,团队靠改一条配置就把用户迁了过去。
开发者视角这篇和昨天 GitHub 那几条连起来看是同一个结论:模型换得太快,只有「自己的任务 + 单任务成本」这把尺子靠得住。我会照抄它的两件事:新模型发布当天就在自有任务上按每个力度档跑一遍;在网关上设力度上限,默认 low 或 medium。0.8 分换 2.5 倍成本,大多数日常改动不值得。
-
- 通过 GitHub 与 180 多个集成、自定义 MCP 服务器或本地 CLI 上传接入日志、用户行为与反馈等产品上下文。
- 每个循环分四步:建议、方案、构建(在隔离的云端沙箱写代码并开 GitHub PR)、复盘(盯住线上数据,目标达成后继续监控)。
- 自带安全、延迟、无障碍三个默认循环,安全循环结合 Gemini 4 Carbon 与 DeepMind 的 CodeMender;可自建循环,如提升结账转化。
- 目前开放全球候补名单,Google AI Ultra 用户优先;其他编码智能体可通过 Stitch CLI 与 MCP 读取它的产品上下文。
开发者视角我一个人维护三款产品,最缺的正是上线后的这一段:看指标、找回退、修小问题。Stitch Loop 的思路值得抄:以可度量的目标驱动、只开 PR 不自动合并。在它排上队之前,我会先自己搭个最小版:每天让编码智能体读一次错误日志和转化漏斗,只允许开 PR,并在 PR 里附上证据。
-
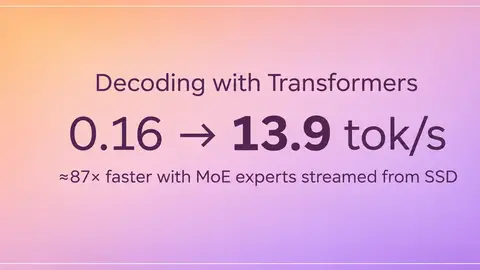
- 专家占 MoE 模型权重的 90% 以上;方案把专家放在磁盘,设备上只保留一个所有层共享的专家缓存「槽位池」,让 grouped_mm 原样运行。
- 缓存全命中时速度从第一版的 10.1 tok/s 提到 34.6 tok/s(原生 38.1);预取下两层的专家,预填充从 68 提到约 228 tok/s。
- 在 32 GB 的 M5 MacBook 上跑 Qwen3.8-Flash-Next,短解码比 Strata 慢约 6%,预填充略快;加载后占用约 18 GiB。
- 代码在 PR huggingface/transformers#50717,API 仍在与维护者讨论;作者说全部代码由 AI 编写。
开发者视角14 tok/s 作者自己都说不够跑编码智能体,所以它的价值不在「笔记本跑 180B」,而在 Transformers 原生支持按专家卸载之后,评测和离线批处理可以不换框架就用上大 MoE 模型。我会等 PR 合入后再用;现在要本地跑,还是 llama.cpp 或 Strata 更现实。
-
- GPU 加速的 Event Functions 运行在 EC2 G 系列实例上,按 GPU、CPU 利用率与并发扩缩,每个执行环境并发处理多个调用。
- 提供预装 vLLM、SGLang、PyTorch 的 GPU 基础镜像;容器镜像与 NVMe 临时存储各最大 32 GB,支持 SOCI 延迟加载与从 S3 流式读取。
- 计费:EC2 按需价(可用 Savings Plans 与预留实例)加 9.75% 的 Lambda 管理费,再加每百万次请求 0.20 美元。
- 已在所有同时提供 Lambda Managed Instances 与 G 系列实例的商业区域上线。
开发者视角PandaClaws 这类内容后台,转写、抽帧、小模型打分都是一阵一阵的,常驻 GPU 大部分时间空着。Lambda 这个形态让「上传触发 → GPU 处理」可以直接接到事件源上。我会先把一个自部署的小模型(比如开源语音转写)搬上去,算清 9.75% 管理费与空闲 GPU 的差额再决定要不要扩大。
-
- Microsoft Copilot harness 公开预览:微软运行智能体循环与沙箱,开发者提供知识、技能与工具,智能体定义可放进源码仓库。
- 语音智能体正式可用,支持打断与原生电话接入;电脑操作与浏览器自动化正式可用,带实时查看、人工接管与存进客户自有存储的会话录像。
- 托管智能体的网络出站控制正式可用,在沙箱外执行;默认配额为每订阅每区域 1,000 到 2,000 个并发会话。
- 内存快照进入公开预览,通过恢复已初始化的智能体状态减少冷启动。
开发者视角和 11-12 Anthropic 的自托管 Managed Agents、AgentCore 的新运行时放在一起看,三家都在卖同一样东西:你只写智能体的「本事」,循环、沙箱和出站管控归平台。我的建议是先把出站白名单这件事做起来,它在任何平台上都该是默认项;harness 还是预览,正式业务先别绑死。
-
- 0.5B 参数,40 多种语言自动识别;用 Qwen3-ASR 架构,Transformers 与 vLLM 原生支持,不需要自定义代码。
- Open ASR Leaderboard 多语种赛道(含中文、德语、法语、印地语等 9 种)平均错误率 6.96%,好于参数多 15 倍的 Meta omniASR-LLM 7B 与 Whisper large-v3;英语赛道 WER 6.6%。
- 满批次吞吐超过 7,000 RTFx,约半秒转写一小时音频;在 302 小时的呼叫中心基准上与 30B 的 NVIDIA Nemotron 3.5 Transcribe 相当。
- 由更大的 Rumble-2 用在线策略蒸馏得到,借 GOLD 方法解决师生模型分词器不同的问题。
开发者视角智能面试要把候选人的回答转成文字再分析,0.5B、Apache 2.0、还能直接上 vLLM,正好可以替掉按分钟计费的云端转写。我会拿一批真实的中文面试录音测字错率,重点看口音和中英夹杂;它的电话音频成绩是英文基准,中文表现要自己验。
-
- 基于 Qwen3.8-27B,用 Miles 做强化学习;144 张 H200 训练 18 天,单个会话最长 100 万 token,Apache 2.0 发布。
- Terminal-Bench 4.1 pass@1 从 5.6% 提到 12.0%,在官方列出的各项基准上都高于原模型。
- 约 1,200 个任务从数千个候选中筛出:每个任务针对原模型会犯的错设计,单次尝试最长 1.5 小时、超过 100 次工具调用。
- 保留原模型的架构、分词器、对话模板、图像理解与 256K 上下文,推荐用 SGLang 加 DSpark 投机解码部署。
开发者视角12% 离闭源前沿模型还很远,这个模型本身我不会拿来当主力;真正值得看的是它的选题方法:只挑「原模型会犯错、又不能投机取巧」的任务,1,200 个就够出效果。想给自己的智能体做后训练的,先像这样从失败案例里攒任务集,比堆数据量更划算。
-
- 团队维护者与组织所有者可在团队页面的 Customize Copilot 标签里,从内置、企业或团队自加的插件市场挑选插件设为团队默认。
- 选中的插件对团队直属成员在 VS Code、Copilot 应用与 Copilot CLI 中默认启用,子团队成员不继承;成员可在策略允许时自行关闭。
- 企业与组织策略优先于团队选择,允许的市场和必装、禁用插件仍由客户端强制执行。
- 面向 Copilot Business 与 Copilot Enterprise。
开发者视角昨天那条 Copilot Evals 管的是「插件好不好」,这条管的是「插件怎么发下去」,两件事合起来,团队级的技能就能像代码一样评测、发布。我的建议是先建一个团队自己的插件市场仓库,只放跑过评测的插件,再把它设为团队默认,别让每个人各装一套。
本期由 AI 辅助检索与起草,选题标准与观点由 Darius 设定。
每周一,一封邮件看完 AI 大事
每周一早上,把过去 7 天最值得关注的 6 件 AI 大事和我的解读发到你邮箱。
邮箱只用于发送周报,不会提供给任何第三方;每封邮件底部都可以一键退订。 看看最近一期 →