NVIDIA 用两台 DGX Station 跑 753B 参数的 GLM-5.3:并发 16 时输出吞吐峰值 607.8 token/s
前沿规模的开放模型已经装不进一台机器。这一条讲两台工作站怎么拼成一个推理端点,以及负载下的实测数字。
// 要点
- GLM-5.3 NVFP4 是 Z.ai MoE 模型的量化版:7,530 亿参数、每 token 激活 400 亿,约 464 GB,超过单张 GB300 的 252 GB HBM3e。
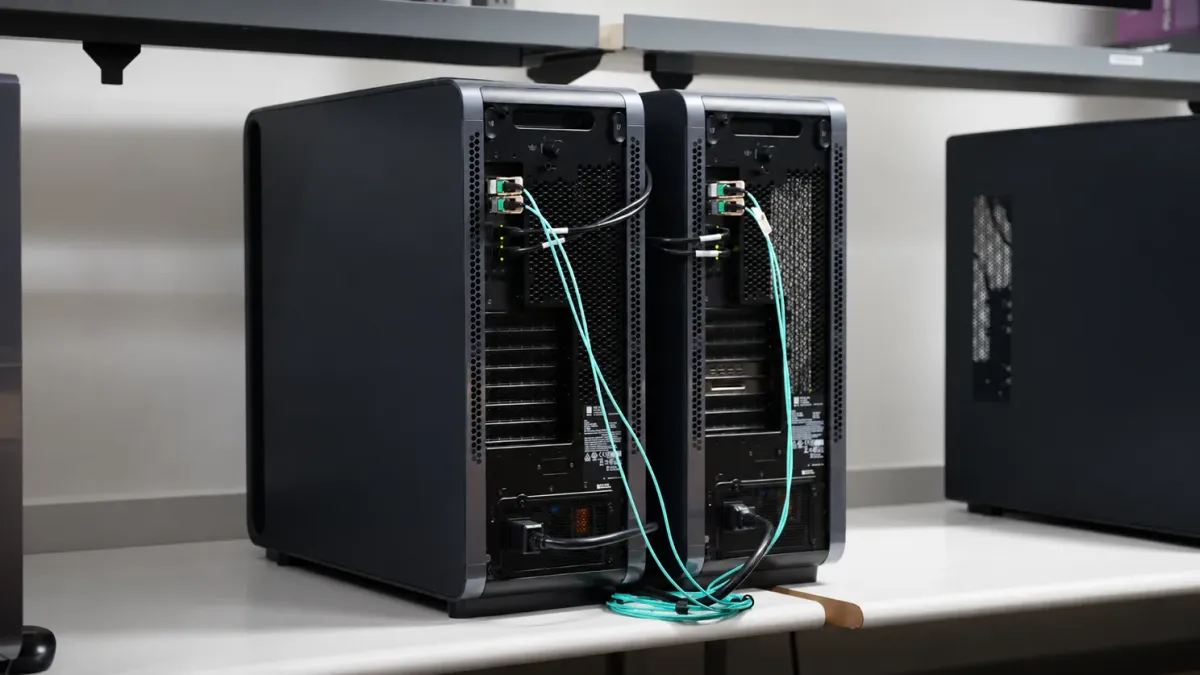
- 两台 DGX Station 经 ConnectX-8 RDMA 互联,用张量并行(TP=2)各存约一半权重,通过一个兼容 OpenAI 的端点对外服务;vLLM 开启多 token 预测、FP8 KV 缓存和前缀缓存。
- 在 SPEED-Bench Coding 数据集上,并发 16 时总输出吞吐达到峰值 607.8 token/s;并发 32 时降到 385.0 token/s,平均请求延迟 453.5 秒。
开发者视角最有用的数字是并发 32 时吞吐反而下降、平均延迟 453.5 秒:本地跑前沿开放模型可行,但只适合小团队内部、低并发的场景。想为了数据不出门而自建的团队,先按这篇的方法在自己的提示词上测出最佳并发,再算每 token 成本和云上按量调用比。