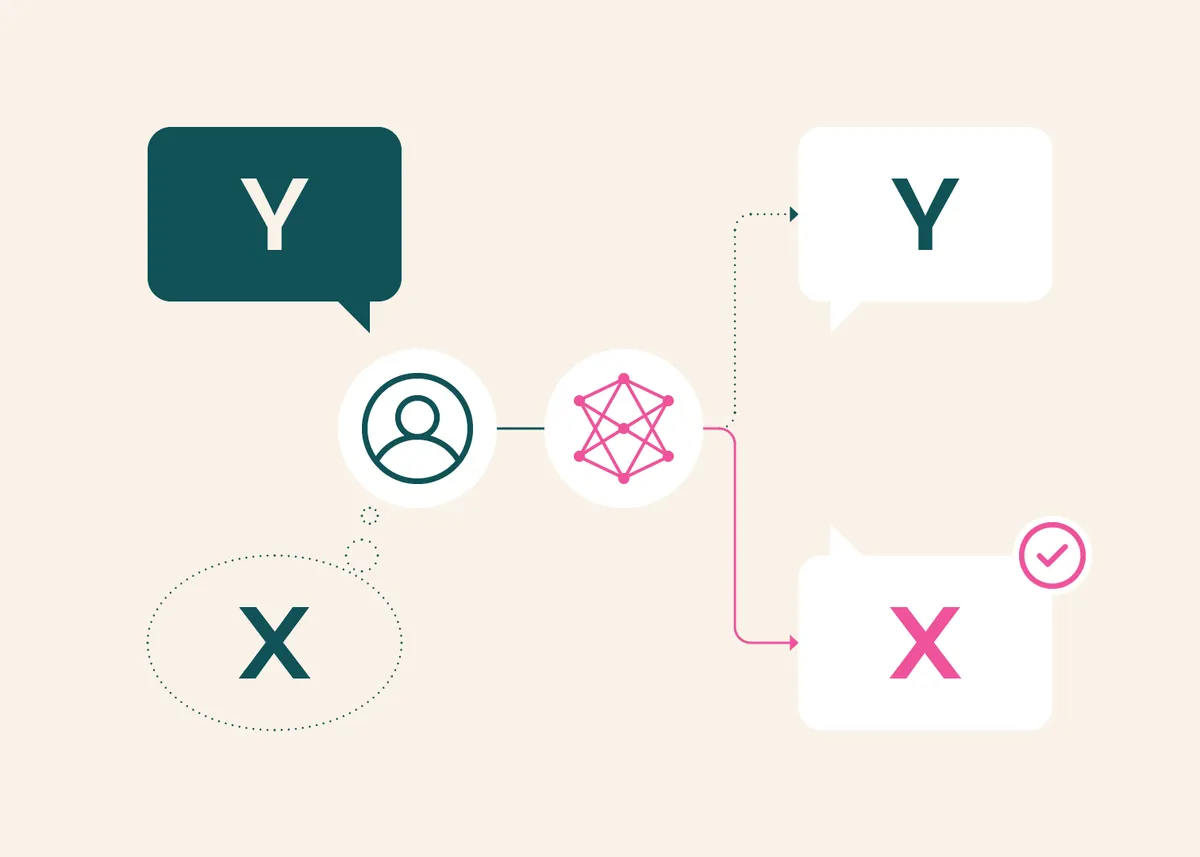
Ai2 发布 XYBench:8,115 个「问错了问题」的提问,模型只在 35% 到 41% 的回答里把重点放在用户真正的目标上
用户常常问的是自己想到的办法,而不是真正的问题。这个基准测模型能不能识别这种误解并把人引回正路,获 EMNLP 2026 最佳资源论文奖。
// 要点
- 共 8,115 个问题:Stack Overflow 1,557 个、Stack Exchange 184 个、人工整理 102 个、根据 WikiHow 指南生成 6,272 个;与卡内基梅隆大学、NVIDIA、约翰霍普金斯大学合作。
- 评测了 Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro:在 Stack Overflow 题上,模型只有 35% 到 41% 的回答主要聚焦用户的真实目标,47% 到 57% 聚焦字面请求。
- 同一批题上,针对字面请求的方案出现在 75% 到 86% 的回答里,针对真实目标的方案只有 59% 到 71%;人类参考答案更倾向于把用户引离错误的思路。
开发者视角这正是做助手类产品最容易忽视的一点:用户问得具体,不代表问得对。智能面试里常见的就是「这道题怎么答得更漂亮」,而真正的问题是岗位理解不到位。我会在系统提示里加一步「先判断用户的目标是什么、当前思路是否走得通」,再拿 XYBench 的编程子集做回归。