2026-11-14 · 周六 · 10 条 llama.cpp 发布 1.0、ChatGPT Wallet 让智能体能付款、AI 渗透框架请求量一个月涨 30 倍
今天的主线是智能体的「边界」:能花钱了(ChatGPT Wallet)、能代用户拿权限了(Cognito 令牌交换),攻击方也在用同样的智能体批量找漏洞。对做产品的人,批准、权限和消费上限这三件事要先于功能上线。
-
- libllama(llama.cpp)与 libggml(ggml)同时发布 v1.0.0;今后 API 与 ABI 不兼容的改动都通过主版本号体现。
- 版本规则:./include 下公开 C API 的破坏性变更升 MAJOR;向后兼容的新功能、后端更新与新模型支持升 MINOR;不改 API 的修复升 PATCH。
- 目前支持 150 多种模型架构变体以及所有主流的投机解码方法。
- 分发渠道包括 Docker、Debian、Homebrew、conda-forge、MacPorts、Winget 和 iOS / macOS 的 XCFramework;CI 有 NVIDIA、AMD、Qualcomm、Arm、IBM、Intel 提供的自托管硬件。
开发者视角这件事的意义不在新功能,而在「可以放心依赖」:以前把 libllama 打进桌面或移动应用,每次升级都要重新对接口。我的做法是锁定 1.x、放开 MINOR 自动升级,像 AI 云盘这类想在本地做文件理解的场景,现在可以认真评估离线方案了。
-
- ChatGPT Wallet 让 ChatGPT Work、Codex 和 dots 中的智能体完成购买。
- 每笔购买需要用户批准,并沿用现有银行卡的保护机制。
开发者视角智能体能花钱之后,「谁批准、批准什么」就是产品设计的核心。我会先把自己产品里所有会产生费用的动作列出来,标清哪些必须人确认、哪些可以设额度自动过,等 OpenAI 公布是否对第三方开放再决定接不接。
-
- 开源自主渗透系统 ARTEX 的作者 10 月 8 日下架了它,但此后已有超过 12,000 个仓库、数百个带改动的分叉,另有数百个类似的编排框架出现。
- 最近 3 天有 50 多个框架家族尝试扫描 Cloudflare 客户,运行这些框架的 IP 已达数千个;AI 渗透与利用工具的日请求量自 10 月 1 日起增长 30 倍。
- 部分较复杂的攻击已开始串联窃取的凭据,在环境内横向移动;这些框架可以接入 MCP,由多个并行智能体完成枚举、验证和攻击。
- Cloudflare 建议的六项措施:带限流的 WAF、Web 应用异常检测、Bot 防御、高风险应用的身份门控访问、强制校验 schema、威胁情报。
开发者视角以前觉得小产品不值得被盯上,现在攻击成本接近推理成本,小站一样会被系统性地扫一遍。我会先做两件最省事的:把所有管理后台放到身份网关后面,给公开 API 加限流和 schema 校验;凭据轮换也要提前,因为这些框架会拿泄露的凭据往里走。
-
- 12 月 14 日起在 Copilot Chat、内联编辑、ask 与 agent 模式及代码补全中下线:Claude Fable 5(替代 Fable 5.2)、Claude Haiku 4.5(替代 Haiku 5.5)、Gemini 3.8 Flash(替代 Gemini 4 Hydrogen)、Gemini 4 Argon(替代 Gemini 4 Carbon)、Grok 4.6(替代 Grok 4.7)、Kimi K3(替代待公布)。
- Claude Haiku 4.5 对年付的个人订阅用户继续保留。
- 在默认模型启用规则下,Business 与 Enterprise 会自动启用建议的替代模型,除非管理员关闭了全局默认或单独禁用该模型。
开发者视角Argon 两个月前才正式可用,现在就被 Carbon 顶替,模型生命周期已经短到按月算。同日 Hydrogen 也在 Copilot 正式可用。我的建议是不要在脚本或团队规范里写死模型名,改用「档位」描述,并在 12-14 之前用替代模型把常用任务跑一遍;注意 Carbon 在 11-30 之后的价格变化,Argon 换 Carbon 不一定是平价替换。
-
- Kitesurf 完全运行在 Cloudflare Workers 上,能解析 HTML、应用 CSS、执行页面 JavaScript 并渲染截图,不需要浏览器容器;支持 Chrome DevTools Protocol,可接 Puppeteer。
- 由 Rust 编译到 WebAssembly 的开源组件构成:Blitz(DOM、布局与绘制)、Stylo(CSS)、Boa(仅在无法用 Dynamic Workers 执行 JS 时兜底)、Linebender(文字与 2D 图形)、Krilla(PDF 输出)。
- 分为 Engine(会话与连接)、PageScript(运行页面与脚本)、PageRenderer(绘制)三部分;可本地运行,也可部署到自己的账户,但需要 Workers 付费计划。
开发者视角大部分智能体浏览网页只是读内容、截个图,用完整的 Chromium 太重。我会把「读页面、核对发布后的排版」这类任务先切到 Kitesurf 试,复杂交互继续留在 Chromium;开源之后至少不用担心被单一托管服务锁住。
-
- 服务或智能体可以用用户的令牌换取一个只针对特定下游服务的新令牌:权限比原令牌更窄、只绑定一个受众、不带刷新令牌。
- 带上 actor token 时,Cognito 会加入 act 声明标明中间方,下游可以区分请求是智能体代发还是用户直接发起;官方举例 MCP 服务器换取窄权限令牌调用后端 API。
- 可通过 token 端点或新的 GetDerivedToken API 使用,适用于 Essentials 与 Plus 功能计划,覆盖所有提供 Cognito 的区域。
开发者视角很多 MCP 服务器现在的做法是把用户的原始令牌一路往下传,出事时既查不清是谁干的,权限也过大。用 Cognito 的团队可以直接改成令牌交换;不用的,也值得照着 RFC 8693 的思路改:每跳换一次窄令牌,日志里留下 act 声明。
-
- 面向所有按量付费客户,先支持 Workers 和 Durable Objects,其他产品随后跟进;可设上限、通知邮箱和多个提醒阈值。
- 达到上限后自动执行阻断策略:只暂停会产生费用的客户代码调用(如 Workers 的 Cron Triggers 与队列消费),静态资源照常提供。
- 控制台近实时(10 分钟内)显示本计费周期各产品花费并保留审计日志;也可用 cf CLI 和 REST API 配置。
- 可与 AI Gateway 已有的按用户、按模型预算配合,同时管住计算与 AI 推理成本。
开发者视角对独立开发者来说,「智能体循环失控一晚上烧掉一个月预算」是真实风险,硬上限比提醒有用得多。我会给定时任务和队列消费这类无人值守的部分先设上限,阈值按平时花费的两到三倍定;和昨天 AWS 按身份封顶 Bedrock 花费的思路一样,成本控制正在变成平台默认能力。
-
- GLM-5.3 NVFP4 是 Z.ai MoE 模型的量化版:7,530 亿参数、每 token 激活 400 亿,约 464 GB,超过单张 GB300 的 252 GB HBM3e。
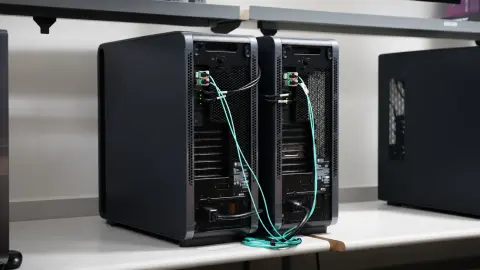
- 两台 DGX Station 经 ConnectX-8 RDMA 互联,用张量并行(TP=2)各存约一半权重,通过一个兼容 OpenAI 的端点对外服务;vLLM 开启多 token 预测、FP8 KV 缓存和前缀缓存。
- 在 SPEED-Bench Coding 数据集上,并发 16 时总输出吞吐达到峰值 607.8 token/s;并发 32 时降到 385.0 token/s,平均请求延迟 453.5 秒。
开发者视角最有用的数字是并发 32 时吞吐反而下降、平均延迟 453.5 秒:本地跑前沿开放模型可行,但只适合小团队内部、低并发的场景。想为了数据不出门而自建的团队,先按这篇的方法在自己的提示词上测出最佳并发,再算每 token 成本和云上按量调用比。
-
- 共 8,115 个问题:Stack Overflow 1,557 个、Stack Exchange 184 个、人工整理 102 个、根据 WikiHow 指南生成 6,272 个;与卡内基梅隆大学、NVIDIA、约翰霍普金斯大学合作。
- 评测了 Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro:在 Stack Overflow 题上,模型只有 35% 到 41% 的回答主要聚焦用户的真实目标,47% 到 57% 聚焦字面请求。
- 同一批题上,针对字面请求的方案出现在 75% 到 86% 的回答里,针对真实目标的方案只有 59% 到 71%;人类参考答案更倾向于把用户引离错误的思路。
开发者视角这正是做助手类产品最容易忽视的一点:用户问得具体,不代表问得对。智能面试里常见的就是「这道题怎么答得更漂亮」,而真正的问题是岗位理解不到位。我会在系统提示里加一步「先判断用户的目标是什么、当前思路是否走得通」,再拿 XYBench 的编程子集做回归。
-
- 评价路由的指标是每个解决任务的成本:所有运行的总花费除以测试通过的运行数,失败和未完成的尝试同样计费。
- Switchyard 的 LiteLLM 集成有两种策略:stage 读取请求历史中最近的工具调用与结果,在两个候选模型中选一个,因此智能体必须发送完整对话历史;random 按权重随机选择,用于分流和 A/B 对比;两者都不调用评审模型。
- 样例用 AWS CDK 把 LiteLLM 加 Switchyard 插件部署在 ECS Fargate 私有子网,前置 ALB 与 WAF;使用的 switchyard-server 0.3.0 被 NVIDIA 标为演示与评估组件,官方提示不要用于生产。
开发者视角和前天 Hydrogen 的 Orchestrator 是同一个方向:按任务难度换模型。Switchyard 还只是演示组件,我不会直接上生产,但它的评测方法值得马上用起来:拿自己的 20 个真实任务,分别测单模型和路由组合的「每个解决任务的成本」,比只看每百万 token 单价靠谱得多。
本期由 AI 辅助检索与起草,选题标准与观点由 Darius 设定。
每周一,一封邮件看完 AI 大事
每周一早上,把过去 7 天最值得关注的 6 件 AI 大事和我的解读发到你邮箱。
邮箱只用于发送周报,不会提供给任何第三方;每封邮件底部都可以一键退订。 看看最近一期 →