2026-11-07 · 周六 · 9 条 Claude Code 跑成 AgentCore 上的远程智能体、Anthropic 拆解智能体记忆、Cloudflare 与 Okta 给智能体加身份层
今天的主线是智能体无人值守干活之后的「可追责」:远程编码以草稿 PR 收尾,令牌同时写明用户和智能体,网站能看到智能体背后的用户,审查指标只算真正被处理的意见。Anthropic 的记忆研究对智能体自身也给出同样的结论:少记,多验证。
-
- 每个登记的仓库有自己的 AgentCore 运行时;每个任务在 VPC 内独立的 microVM 里跑,经私有端点访问 Amazon Bedrock,容器里没有其他 AWS 凭证
- Claude Code 用 Claude Opus 做规划、用 Claude Sonnet 写改动,跑仓库自带的验证命令,再用 Opus 审查,不通过可退回重新规划,最多 3 次
- 智能体不持有长期 GitHub 凭证:AgentCore Identity 发放 8 小时过期的用户到服务器令牌;任务提示词先过一道 Bedrock Guardrails 筛查
- PR 里写明验证命令、退出码和用了几次尝试;验证没过就以草稿打开,智能体从不自己合并
开发者视角大模型规划、便宜模型写、再用大模型审,这套分工就算不用 AgentCore 也值得照搬。PandaClaws 后台我会先落实两条硬规矩:仓库令牌短期有效、「验证不过只开草稿」,沙箱放在哪是后面的事。
-
- 用 Opus 5 智能体把约 35 万份内部文件(约 4.2 亿 token)整理成 wiki,「做梦」从 2 轮加到 128 轮,只靠 wiki 回答 25 个问题的得分从 13% 升到 48%
- wiki 加搜索时,得分随 wiki 扩充从 54% 升到 61%,只用搜索为 53%,且每题省约 2 万 token;24 个并购问题上用 wiki 得 87%,只用搜索得 73%
- 玩宝可梦时,Sonnet 3.7 在 225 个文件夹里写了 413 个记忆文件,只拿到 1 枚徽章;Fable 5 只记策略和验证过的规则,走得远得多
- 规定 Opus 5 和 Opus 4.7「只记录失败」,记忆带来的提升大半没了;提示 Sonnet 4.6 先读记忆再验证猜想,得分接近翻倍
开发者视角最有用的结论是「记什么」比「记多少」重要:Sonnet 3.7 那 413 个文件让它更慢而不是更聪明。AI 云盘那边,我会停掉一切能从文件本身重新读到的记忆,改成每晚对当天日志做一次整理,而不是在任务中途写记忆。
-
- 托管智能体可以用技能、跑代码的沙箱、子智能体和钩子,运行时与每周支撑数百万次 Mistral Vibe 会话的是同一套
- 工作流支持中断后续跑、企业系统事件触发和可视化流程图;团队可以在 Mistral Vibe 里描述流程,生成、测试并部署
- 新的 Mistral MCP 服务让开发者用 Mistral Vibe 或自己的编码智能体开发,一条命令部署到 Studio;OpenTelemetry 追踪覆盖模型调用、工具使用和审批
- 模型和平台可以跑在 Mistral 云、自有云或 VPC、本地机房;ABANCA、BNP Paribas、CMA CGM 等客户已在生产使用
开发者视角技能、子智能体、钩子、沙箱、追踪,现在已是各家智能体平台的标配五件套。Mistral 真正不同的只剩「模型和平台都能进本地机房」,所以我只会因为这一点把它列进候选:智能面试那些不肯把候选人数据送出去的企业客户。
-
- 文章列出智能体给网站带回来的老问题:一份订阅多人共用、智能体下单后用户拒付、借共享智能体撞库、内容被读走却没有访问
- Trusted Agent Delegation(TAD)联盟将梳理 Web Bot Auth、OAuth、MOLE 等现有协议,把定义清楚的问题提交 IETF
- Security Analytics 把「个人助理」单列为一类流量;AI Crawler and Agent 访问策略可以逐个智能体放行或拦截,包括只在带广告的页面拦截
- Account Abuse Protection(抢先体验)里,每次登录和注册都会显示是否由个人智能体发起、是哪个,网站可以按 Hashed User ID 只处置那一个账号
开发者视角加上前一天的 402 付费结算,网站这边对智能体既有了价码,也开始有身份层。产品有登录页的,现在就开始记录哪些登录来自智能体;数据出来后再决定哪些流程必须真人,哪些可以放行。
-
- Okta 每次请求都会先检查智能体是否启用、用户是否已分配、管理员是否连接了目标,再签发 ID-JAG;它只能用一次,5 分钟过期
- AgentCore Identity 用它换取同时写明用户和智能体的 5 分钟访问令牌;10 次请求中首次兑换约 0.5 秒,复用令牌的中位数为 58 毫秒
- 删除智能体的资源连接,新请求立即被拒;移除用户分配约 1 秒内被拒;停用智能体在测试组织里排队了 86 分钟
- 已签发的令牌最多还能用 5 分钟;AgentCore Identity 让一次端到端约 30 秒的请求多出约 0.6 秒
开发者视角我会记住 86 分钟这个数:「停用智能体」不是紧急开关,删掉它的连接才是。和 11-04 那篇 ServiceNow 代表用户调用连起来看,做法正在收敛到「短期令牌、同时带上用户和智能体身份」;我们任何能碰 AI 云盘分享接口的智能体都按这个做默认。
-
- 4-bit 量化后模型约 18 GB,24 GB 显存的消费级显卡可跑,上下文最长 64K token
- 优化包括 DFlash2 投机解码、INT4 权重、KV 缓存量化、CPU 卸载、前缀缓存和连续批处理
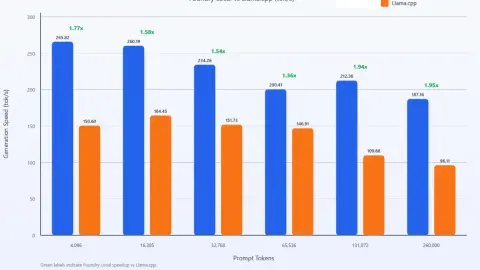
- 在 RTX 5090 和 DGX Spark 上与 llama.cpp 对比,所有测试提示长度下 Foundry Local 生成都更快,超过 131K token 后差距拉大
- 需要 Foundry Local CLI 0.13.0 及以上;微软也提醒本地模型推理能力不如云端大模型,建议混合使用
开发者视角24 GB 显卡、27B 模型、直接进 Copilot,这是我第一次觉得可以把本地方案交给团队做日常改动和写测试。不能出公司的代码走它,规划和难缠的 bug 留给云端模型,再统计大家多常要切回去。
-
- 新增计数:被评估的评论数、开发者处理了的评论数(应用建议、让 Copilot 修、自己改代码,或回复说下个 PR 修),以及 Copilot 首次审查后没有人再要求修改就合并的 PR 数
- 两项计数都按严重程度和定制方式细分,如自定义指令、技能、MCP 服务或无定制
- 评论在 PR 合并时才评估,计入合并当天;Copilot cloud agent 等机器人开的 PR 上的评论通常不评估
- 企业和组织报告中可见,限所有者、账单管理员及有相应权限的自定义角色;需要开启 Copilot 用量指标策略
开发者视角审查机器人一直缺的就是这个指标:不是评论了多少,而是有多少被人处理了。我会按仓库拉一个月数据,对比有无自定义指令的仓库,把没人处理的规则砍掉;注意机器人开的 PR 不计入,智能体的 PR 得另外统计。
-
- 优化引擎支持智能体追踪,包括 OpenTelemetry 追踪,追踪和日志存在同一处
- span 事件、span 链接、提示词和工具调用保留嵌套结构,写入时不必拍平,可按字段查询
- 热数据层支持按文档 ID 更新、删除和 upsert,迟到或出错的数据可以原地修正
- OpenSearch UI 新增智能体追踪和会话视图;OpenSearch 3.7 在 12 个区域可用,不额外收费
开发者视角Mistral Studio、AgentCore,现在加上 OpenSearch,都用 OpenTelemetry 记录智能体,所以埋点现在就按 OTel 做,后端当作可替换。应用日志本来就在 OpenSearch 的,这是不加新供应商就能按提示词和工具调用检索的最便宜办法。
-
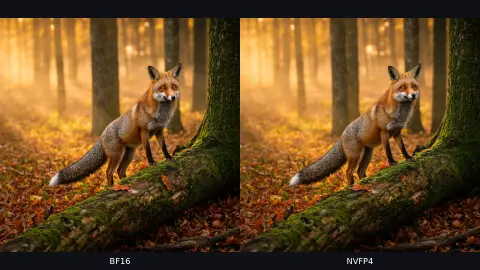
- FLUX 3 Image Klein 由 Qwen3-VL-4B-Instruct 做文本条件、扩散 Transformer 和自编码器组成,提供 Base 和蒸馏两种检查点
- 单用 NVFP4,在 B200 上文生图比 BF16 快至 1.62 倍,图生图快至 1.58 倍
- 叠加优化后文生图提速 3.46 倍(22.36 秒到 6.46 秒),图生图 4.45 倍(54.64 秒到 12.28 秒);单用 Cache-DiT 在 2048x2048 下提速 1.94 倍,LPIPS 为 0.033
- 8 张 B200 上,文生图中位延迟 Base 从 14.90 秒降到 3.00 秒,蒸馏版从 2.73 秒降到 1.08 秒
开发者视角PandaClaws 的封面图照这个顺序试就行:先上步缓存,画质变化最小、延迟几乎减半,再上 NVFP4;多卡并行只有交互式编辑才值。0.033 这个 LPIPS 我会先用自己的提示词复测再信。
本期由 AI 辅助检索与起草,选题标准与观点由 Darius 设定。
每周一,一封邮件看完 AI 大事
每周一早上,把过去 7 天最值得关注的 6 件 AI 大事和我的解读发到你邮箱。
邮箱只用于发送周报,不会提供给任何第三方;每封邮件底部都可以一键退订。 看看最近一期 →