NVIDIA TensorRT LLM VisualGen 让 FLUX 3 Image Klein 在单张 B200 上提速 3.46 倍,2048x2048 文生图从 22.36 秒降到 6.46 秒
一篇逐项实测的教程:Black Forest Labs 图像模型从 NVFP4 到步缓存、多卡并行,每项提速多少、画质损失多少。
// 要点
- FLUX 3 Image Klein 由 Qwen3-VL-4B-Instruct 做文本条件、扩散 Transformer 和自编码器组成,提供 Base 和蒸馏两种检查点
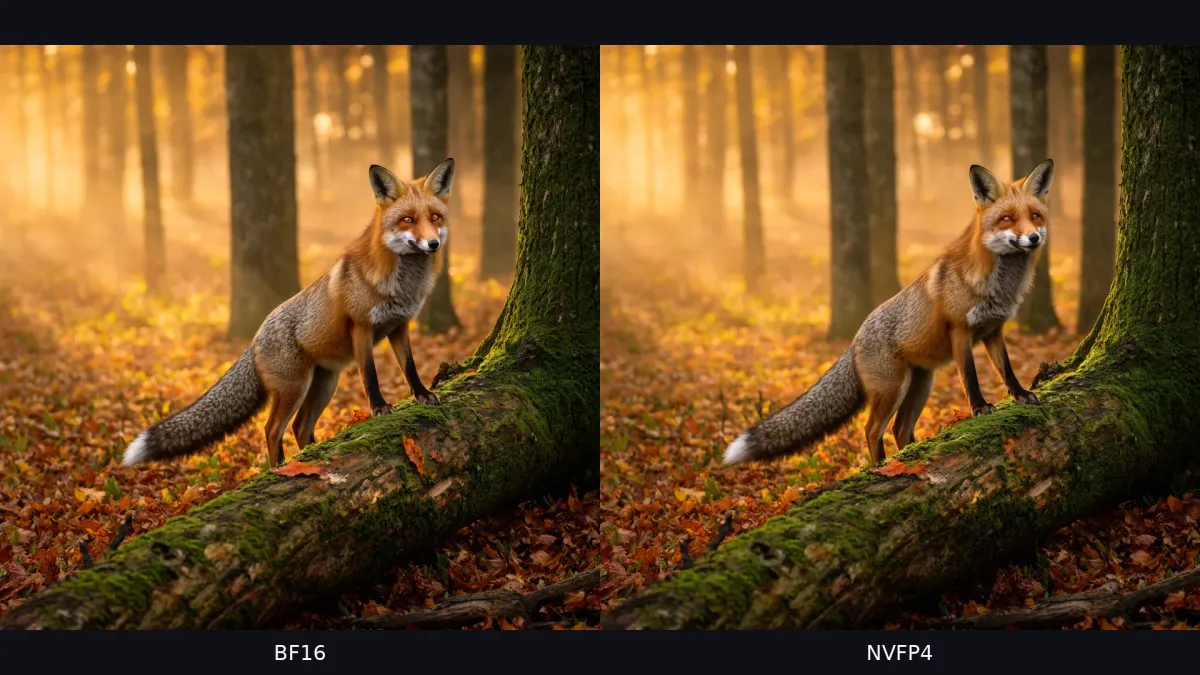
- 单用 NVFP4,在 B200 上文生图比 BF16 快至 1.62 倍,图生图快至 1.58 倍
- 叠加优化后文生图提速 3.46 倍(22.36 秒到 6.46 秒),图生图 4.45 倍(54.64 秒到 12.28 秒);单用 Cache-DiT 在 2048x2048 下提速 1.94 倍,LPIPS 为 0.033
- 8 张 B200 上,文生图中位延迟 Base 从 14.90 秒降到 3.00 秒,蒸馏版从 2.73 秒降到 1.08 秒
开发者视角PandaClaws 的封面图照这个顺序试就行:先上步缓存,画质变化最小、延迟几乎减半,再上 NVFP4;多卡并行只有交互式编辑才值。0.033 这个 LPIPS 我会先用自己的提示词复测再信。