Foundry Local 以 4-bit 运行 Qwen3.8-27B,约 18 GB,24 GB 显存的消费级显卡可跑 64K 上下文,并可作为 GitHub Copilot 的模型提供方
微软针对 NVIDIA 显卡优化 Qwen3.8-27B 的本地编码推理,并通过 BYOK 接进 GitHub Copilot,日常写代码可以不出本机。
// 要点
- 4-bit 量化后模型约 18 GB,24 GB 显存的消费级显卡可跑,上下文最长 64K token
- 优化包括 DFlash2 投机解码、INT4 权重、KV 缓存量化、CPU 卸载、前缀缓存和连续批处理
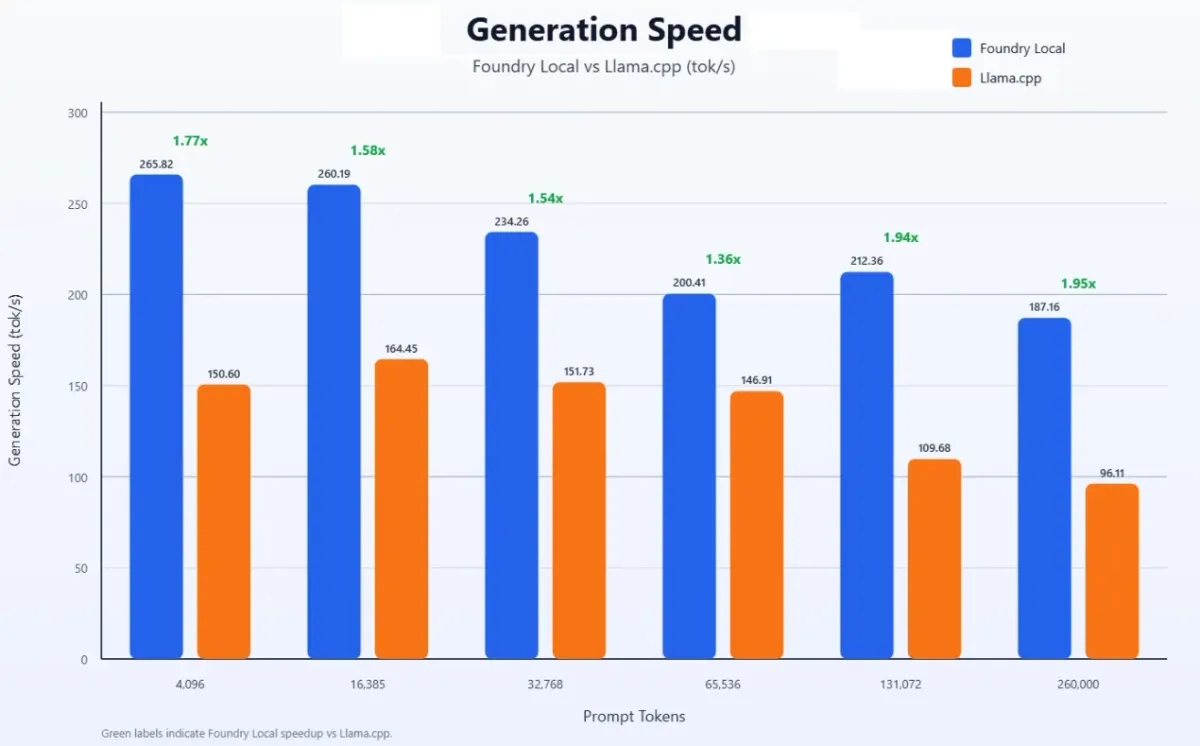
- 在 RTX 5090 和 DGX Spark 上与 llama.cpp 对比,所有测试提示长度下 Foundry Local 生成都更快,超过 131K token 后差距拉大
- 需要 Foundry Local CLI 0.13.0 及以上;微软也提醒本地模型推理能力不如云端大模型,建议混合使用
开发者视角24 GB 显卡、27B 模型、直接进 Copilot,这是我第一次觉得可以把本地方案交给团队做日常改动和写测试。不能出公司的代码走它,规划和难缠的 bug 留给云端模型,再统计大家多常要切回去。
// 来龙去脉 · 来自 #开源模型 专题
看完整时间线 →- 11-07 NVIDIA TensorRT LLM VisualGen 让 FLUX 3 Image Klein 在单张 B200 上提速 3.46 倍,2048x2048 文生图从 22.36 秒降到 6.46 秒
- 11-05 Hugging Face 为 Transformers 提出「模型集成契约」:在 CPU 上跑保留真实结构的微型模型,本可抓住一个在 main 里待了近两个月的 UMT5 缺陷
- 11-05 IBM Research 的 Palette 用一个 20B 开放权重模型加单个 LoRA 适配器做幻灯片,PresentBench 均分 59.7,NotebookLM 为 60.8