2026-11-08 · 周日 · 9 条 @GitHub 在 Slack 和 Teams 正式可用、Kimi K3.1 Pro 上架 Bedrock、OpenAI 联手 Hacktron 查自家漏洞
今天的主线是把智能体「管起来」:编码智能体进了团队聊天,审查设置和智能体配置都能用 API 和配置文件统一管理、进 PR 评审。另一头,大号开放模型继续进入托管目录,切分 GPU、端侧语音这类工程手段在把推理成本往下压。
-
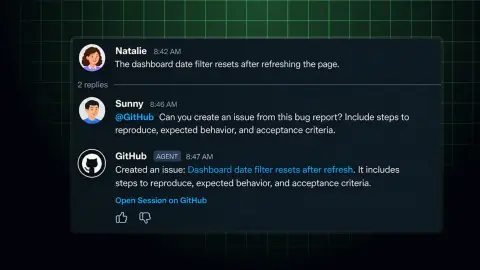
- 在 Slack 和 Teams 里 @GitHub 即可调查 bug、创建 issue、实现改动并打开 pull request,不用离开对话
- Teams 里的 Canvas 可以在对话旁边审实现方案、代码改动和预览,队友在同一处继续讨论、反馈
- @GitHub 会从消息里识别仓库并直接启动会话,不必再选一次仓库
- 由 @GitHub 创建的 issue 和 PR,描述里会写明「Created from a Slack/Teams conversation with @username」
开发者视角聊天里一句话就能开 PR,门槛低了,审查的量也会跟着涨。我会先在一个非核心仓库放开,盯两周 PR 的合并率和返工率,再决定要不要推到主仓库;PR 描述里自动写明发起人这一条,正好满足我们对「谁让智能体干的」的追责要求。
-
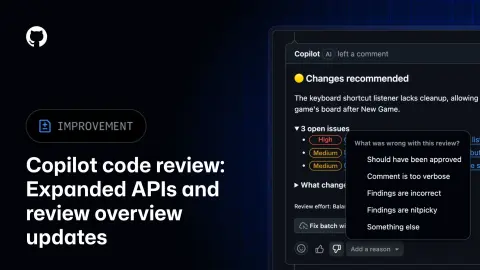
- 企业管理员可为所有组织开关代码审查,组织管理员可管理启用状态、默认审查力度和 runner 配置,企业已管的设置下级不能覆盖
- 仓库管理员可设置审查力度,以及审查是否使用自定义指令和 MCP 工具;仓库级接口支持 GitHub App 与细粒度 PAT,企业和组织级接口不支持
- API 可通过明确的归属字段识别 Copilot 的审查和评论,并返回审查用的力度、评论引用的技能、MCP 服务器和自定义指令
- 审查概览改得更紧凑;代码审查的智能体会话会显示一次审查消耗的 AI credits,「自动请求 Copilot 审查」规则支持豁免名单
开发者视角和前天的「审查意见采纳率」接起来看,GitHub 在把审查做成可度量、可配置的东西。我会用这个 API 把每个仓库的审查力度写进配置库统一管理,再结合每次审查消耗的 credits,给低采纳率的仓库降一档力度,省下的额度留给核心仓库。
-
- 据 Moonshot AI 介绍,Kimi K3.1 Pro 是开放权重、原生多模态的智能体模型,上下文窗口 100 万 token,是其迄今能力最强的 3 万亿参数级模型
- Bedrock 上提供 Highspeed 版本,强调高输出 token 速率,面向编码、文档处理等智能体场景
- 与专有模型运行在同一安全边界内,支持显式提示词缓存以降低延迟和输入成本
- 通过跨区域推理,在所有提供 Amazon Bedrock 的 AWS 区域可用
开发者视角距离 11-04 那条 Kimi K3 在印度境内推理不到一周,Moonshot 在 Bedrock 上的节奏很快。AI 云盘的长文档问答我会拿它和现用模型在同一批文件上对比,重点看长上下文下开了提示词缓存后的实际单次成本,而不是只看榜单。
-
- 用 NVIDIA MIG 把一张物理 GPU 切成独立分区,每个分区有固定的计算单元和专属显存,隔离由硬件保证;视 GPU 而定最多切 7 份
- 只适用于使用 inference components 的端点;单模型端点、Serverless 端点和异构实例池不能切分
- AWS 实测 H100 的一个 40 GB 分区对比整张 A100-40GB:各场景吞吐高 53% 到 89%(在各自成本优势最大的负载下),首 token 延迟低 5.6% 到 47.5%
- 越过一个随提示词变长而提前的交叉点之后,每百万输出 token 便宜 18% 到 34%(按按需价格计算)
开发者视角很多团队为每个小模型独占一张卡,账单里一半是空转。智能面试按岗位微调的几个小模型,我会先挪到 inference components 上,用半张新卡替换整张旧卡跑一周,对比延迟和账单再决定要不要全量迁移。
-
- 训练与推理分离部署时,需要定期把训练卡上的新权重同步到推理卡(refit);NVIDIA 估计当今最大开放权重模型每次 refit 约 10 TB
- Reshard 把 refit 改写成 DTensor 到 DTensor 的传输,在任意源、目标切分布局之间只传理论最小数据量
- 开源参考实现 NCCL M2N Reshard 放在 NVIDIA/nccl-extensions 仓库
- 在 DGX H100 和 DGX GB200 上的 NeMo RL 测试中,对 Qwen 3 235B、DeepSeek v3 671B 等模型提速 2.7 到 5.7 倍
开发者视角大多数产品团队不会自己做百亿级强化学习,但这说明开放模型的后训练成本还在被工程手段压低,自训专用模型的门槛会继续下降。我的建议是先把评测集和奖励信号准备好,等这类工具进到 NeMo RL 的默认路径再动手。
-
- 模型约 65 MB 和 75 MB,支持英、法、德、西、葡 5 种语言,内置 100 多种音色,支持声音克隆和音色设计
- Phonon 31m(英文)采用 Apache 2.0;覆盖 5 种语言的 Phonon 40m 为非商用许可
- Open TTS Leaderboard 上德语、西班牙语可懂度第一,各语言均进前三;CPU 流式首段音频 p95 为 28 毫秒(31m)和 38 毫秒(40m),Pocket TTS 为 165 毫秒
- 支持 10 多种后端,含 CPU、CUDA、Vulkan、Metal、WebGPU 和 NPU;从 Transformers v5.21 起内置,另有可在浏览器 WebGPU 上运行的 ExecuTorch 版本
开发者视角智能面试的语音追问目前走云端 TTS,延迟和按字计费都是负担。英文场景我会先用 Apache 2.0 的 31m 在浏览器里试,首段音频能压到几十毫秒就值得切;多语言版是非商用许可,上线前要单独确认授权。
-
- OpenAI 宣布与 Hacktron 合作,查找 OpenAI 系统中的漏洞
- 合作范围包括测试 OpenAI 与第三方服务之间的连接
- 目标是借助前沿 AI 加固防御,OpenAI 将其归入「安全」类公告
开发者视角这周 OpenAI 先是内核补丁、再是 GPT-6 Cyber,现在轮到查自己,安全是它这个月最一致的线。对我们来说值得照做的是「第三方连接」这一块:PandaClaws 对接了多个内容平台的授权,我会先把这些 OAuth 回调和 webhook 列成清单,交给 AI 扫描工具定期跑一遍。
-
- BioBasicsBench 包含 100 道任务
- 衡量 AI 智能体解读原始实验数据的能力
- 覆盖日常湿实验科学工作,OpenAI 将其归为「论文发表」类
开发者视角和 10-30 的 GPT-6 Rosalind、11-02 的 LifeVal 连起来看,OpenAI 在给垂直场景各配一把自己的尺子。做产品的人该学的是这个做法:用「用户手里的原始数据」出题,而不是用公开题库,智能面试的评测集我也会按这个思路补一批真实简历和面试录音。
-
- 扩展包 microsoft.foundry 达到 1.0 正式可用,需要 Azure Developer CLI 1.37.0 或更高版本
- 智能体与部署配置写在 azure.yaml 里,和代码放在一起,团队和 CI/CD 复用同一份定义
- 本地用 azd ai agent run 测试,可在 Agent Inspector 里查看请求和响应
- 托管智能体在 Foundry 的托管计算上运行你自己的智能体代码,框架和编排逻辑自选;需要定制时可导出可编辑的 Bicep 或 Terraform
开发者视角「智能体配置跟代码一起评审」这条值得任何平台照搬:提示词和工具清单一改,就和代码改动一样要过 PR。我们不在 Azure 上,但我会把 PandaClaws 各个智能体的提示词、工具权限从后台数据库挪进仓库的配置文件。
本期由 AI 辅助检索与起草,选题标准与观点由 Darius 设定。
每周一,一封邮件看完 AI 大事
每周一早上,把过去 7 天最值得关注的 6 件 AI 大事和我的解读发到你邮箱。
邮箱只用于发送周报,不会提供给任何第三方;每封邮件底部都可以一键退订。 看看最近一期 →