2026-11-09 · 周一 · 9 条 Google 量化过期 TODO 让智能体多烧 77% token、Copilot 支持辅助批准工具请求、Cursor 能和智能体语音通话
周末消息不多,主线落在智能体的「日常运营」:上下文里的一条过期注释就能让成本多出七成,放行规则、权限策略和用量口径都在变成能写下来、能审的配置。一个安全运营团队的真实数据则说明,分级把关比追求全自动更重要。
-
- 数据来自数千名工程师的智能体分布式追踪,覆盖数亿个智能体步骤;约 1/7(13%)的会话会碰到引用 bug 的 TODO 或 FIXME 注释
- 94% 的情况下智能体忽略这些注释;6% 会去处理所引用的 bug,其中 83% 用户并没有要求,41% 的「自作主张」追的是已关闭的工单
- 回归分析(均 p<0.0001)显示,被带偏的会话步数多 70%、token 多 77%、等待时间多 105%
- Google 让清理智能体核对 bug 历史和文件历史后再提删除,六个月删掉数千条过期引用,人工评审接受率超过 95%
开发者视角这是我今年看到最「便宜」的智能体降本办法:不换模型,先清代码里的过期注释。我会在 PandaClaws 和 AI 云盘的仓库里加一个提交前检查,扫出引用已关闭工单的 TODO,交给智能体核对后再删,删除一律走人工评审。
-
- Copilot 应用里可以从 pull request 设置 Agent Merge,准备好后由 Copilot 合并;必需检查或规则未通过时保持启用等待
- 辅助批准:给 Copilot 写指导,说明哪些工具请求可自动批准;个人指令需主动开启,只作用于本地会话
- 会话上下文到上限时,可直接从报错处压缩对话或查看占用;Copilot CLI 新增 /settings 面板,统一管理插件和 MCP 服务器
- VS Code 1.145 支持用 cron 表达式排定本地自动化任务,并可调用工作区里的自定义智能体
开发者视角「辅助批准」是把每次弹窗确认变成一条可写下来的策略,方向对,但我会先只放行只读类工具(搜索、读文件、跑测试),写操作和联网请求继续人工点。这份指令最好和仓库里的权限配置放在一起评审,别只存在个人设置里。
-
- 可在 Agents 窗口、IDE、网页和 Cursor iOS 中与智能体实时语音通话;iOS 上说「Hey Siri, call Cursor」即可发起
- 语音智能体负责对话,把编码工作交给聊天里的智能体;运行期间可以问 diff 改了什么、查进度、搜索过往消息
- 运行在 xAI 的 Grok Voice 上,开启隐私模式时语音通话零数据保留
- 与原来的听写(此前叫 Voice Mode)是两个功能:听写只把语音转成文字,语音通话是双向对话
开发者视角语音适合「盯进度、问改了什么」这种碎片场景,不适合描述复杂需求。和 11-08 那条 Slack、Teams 入口连起来看,编码智能体正在变成随时能叫到的同事;我会先把它当成离开电脑时查后台任务的方式来用,需求本身还是写成文字。
-
- 每月约 3,000 到 4,000 条告警,来自暗网泄露卡片、身份与访问异常、基础设施告警和金融风险事件四类来源
- 一级主管智能体编排 30 多个专项智能体做分诊;约 10% 需要多步推理的案件交给二级主管,关联 3 到 5 个数据源出调查报告
- 自动处理率从 0 到一级 83%、两级合计超过 90%,人工升级降到 10% 以下;常规分诊从 15 到 30 分钟降到数秒,估计每月省 900 到 1,800 个分析师小时
- 30 天滚动的情景记忆识别重复模式;同一模式以相同方式处理三次才记为确认;高风险案件连同证据链交给人工
开发者视角值得抄的不是「90%」,而是两条规矩:同样处理三次才算确认的模式,以及按风险分三档决定谁来拍板。我做智能面试的异常评分复核时也会照这个来,低风险自动过、中风险标记、高风险带证据转人工。
-
- 智能体的所有流量改走一个 AgentCore Gateway,入站授权只接受签发给该智能体的 ID-JAG;令牌兑换移到网关,智能体执行角色不再需要兑换和密钥权限
- AgentCore Policy 以 ENFORCE 模式运行 Cedar 策略、默认拒绝,在任何工具执行前把工具绑定到智能体的 client ID 和委托范围(如 xaa:write);被拒的调用不会兑换 ID-JAG
- 第二个报表智能体跑在 Amazon EKS 上,独立的 Okta 注册,只有 xaa:read;OpenTelemetry 记录每一跳,Okta 系统日志经 EventBridge 进 CloudWatch 一起查
- 新增部分约 90 分钟搭完;EKS 控制面每小时 0.10 美元另加节点等费用;作者说明代码只演示模式,不用于生产
开发者视角「被拒的调用连令牌都不兑换」这一点我很认同:权限判断放在拿凭证之前,泄露面最小。我们 PandaClaws 的多平台发布智能体也该这样拆:发布和读数据用两个身份,网关统一做默认拒绝的工具级策略,而不是在每个智能体里各写一套判断。
-
- 请求经 Route 53、带 AWS WAF 的公网负载均衡和 Amazon Cognito 鉴权后,才转到私有子网里 Fargate 上的 MCP 服务器,后者不直接暴露在公网
- 暴露三类工具:经 Athena 和 Redshift 跑 SQL、在 Bedrock Knowledge Bases 上做文档与表元数据语义检索、检索运维制度
- Athena 工具只允许 SELECT、拒绝写入;每次工具调用以结构化 JSON 写入 CloudWatch 供审计;会话状态放 DynamoDB,Fargate 任务无状态
- 接入数据集只需一个 JSON 元数据文件,无需写代码;数据湖有数千个数据集,测试中端到端交互延迟 15 到 20 秒
开发者视角「只读 SQL + 每次调用都留 JSON 日志」是给智能体开数据权限的最低配置,值得直接照抄。AI 云盘的存储驾驶舱如果要开放给智能体查询,我会按这个做;但 15 到 20 秒的延迟只适合分析类问答,别放到用户等着看的交互路径上。
-
- 开放仿真资产、任务与示范生成器、训练与评测代码、验证集,以及 Molmo2-4B-tb 和 maniflow-tb 两个模型;数据含 85,336 条长时程示范、约 1.44 亿帧
- 以 Claude Opus 5.5 做智能体,在「找字母并拼词」任务上解出或正确判定不可行的比例为 63%;自学的技能描述把成功率从 24% 提到 63%,专家手写的只有 36%
- 加入 100 条世界模型生成的推演,策略在未见区域的成功率从 19% 升到 78%;ManiFlow 原子技能仿真 80.0%、真机 81.1%
- 作者认为视觉-语言-动作模型对新空间布局泛化仍差,前沿模型仍会出现字母方向认错等感知错误;更大的第二批发布计划在几周内推出
开发者视角我不做机器人,但「自学的技能描述比专家手写的好用」这个结论对写智能体工具说明的人很有参考价值:工具描述不妨让模型根据实际调用结果自己改写,再拿评测集对比。我会在 PandaClaws 的工具说明上试一轮。
-
- 用户描述一个想法,例如节日礼物清单或每日猜词游戏,Muse 生成对应的专属体验,之后可继续让它补功能、改样式、改逻辑
- Spaces 可放进侧边栏或主标签页、隐藏,或按时间排期出现,比如工作日显示周计划、周六切到周末安排
- 可连接用户的应用,让 Space 在后台更新(如演出日期、价格变化),用户也能在里面勾选、记笔记、编辑
- 已在 Muse 可用的所有地区上线;Meta 正在探索共享 Space 协作,并向 Muse 推出用 Muse Wonder 经验训练的专用模型
开发者视角这对做工具类产品的人是个信号:用户开始期待「我说需求,产品当场长出一个界面」。我不会去追这个形态,但会在 AI 云盘里先试一个小切口:让用户用一句话生成某类文件的专属看板,看留存再说。
-
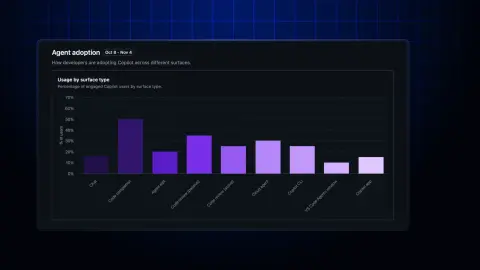
- 智能体采用图新增 Copilot Chat 和 VS Code Agents 窗口,共覆盖 9 种 Copilot 体验;企业和组织的 28 天用量报告同步加入,API 字段新增 chat 和 vscode_agent
- 28 天内至少两天使用某功能才算参与;Chat 包含智能体模式,做过智能体编辑的用户也计入 chat
- 「被动用户」更名为「以聊天为主的用户」;Chat 和 Agents 窗口不计入采用阶段,队列规模不变
- 企业所有者、账单管理员、组织所有者及具备 View Copilot Metrics 权限的自定义角色可查看,需启用用量指标策略
开发者视角和 11-07 那条审查采纳率连起来看,GitHub 在把「用了多少」细分成「怎么用」。我会把「两天以上才算参与」这个口径直接借来,统计我们团队的智能体使用,避免被试一次就走的人拉高数字。
本期由 AI 辅助检索与起草,选题标准与观点由 Darius 设定。
每周一,一封邮件看完 AI 大事
每周一早上,把过去 7 天最值得关注的 6 件 AI 大事和我的解读发到你邮箱。
邮箱只用于发送周报,不会提供给任何第三方;每封邮件底部都可以一键退订。 看看最近一期 →