智能体
智能体落地:评测、可靠性、工具调用与成本。 这一页按时间倒序收录简报里所有与 智能体 相关的条目,并保留每条的一手来源。
时间线 128 条
-
10-30 · 周五 · 2 条
- AWS Step Functions 工作流可作为智能体工具调用:经 AgentCore Gateway 以 MCP 暴露,Standard 和 Express 都支持
视角 · 这是我一直推荐的做法:智能体只决定「做不做、参数是什么」,真正有副作用的步骤(审批、扣款、改数据)留在确定性的工作流里。如果你已经在 AWS 上用 Step Functions 编排业务,先把只读的「查运行状态」接给智能体做运维问答,再考虑放开「启动流程」,并且让工作流自己带审批节点,而不是靠提示词约束。
出自 10-30 简报 · 第 03 条 →
- AWS Step Functions 工作流可作为智能体工具调用:经 AgentCore Gateway 以 MCP 暴露,Standard 和 Express 都支持
-
10-29 · 周四 · 5 条
- GitHub Agentic Workflows 正式可用:用 Markdown 写自动化,编译成 Actions YAML,由 Copilot 或自带的编码智能体执行
视角 · 小团队最先能用上的是 CI 失败分析和 issue 分诊:默认只读加输出校验,它只能「提建议」,风险可控。我会先只上一个「CI 失败后自动写分析评论」的工作流,上之前跑一遍 gh aw forecast 看每月额度区间。
出自 10-29 简报 · 第 03 条 → - Copilot Memory 在付费计划正式可用,「dreaming」进入公开预览:自动整理记忆,改指令文件要走 PR
视角 · 「改指令文件走 PR」这条边界划得对:会改变整个团队行为的记忆,就该和代码一样能被审查。我会开启仓库记忆,但要求 dreaming 的 PR 和普通代码同样过审;个人记忆也要定期翻一遍,过时的记忆会变成没人察觉的错误默认值。
出自 10-29 简报 · 第 04 条 → - Microsoft 把 Copilot harness 放进 Foundry Agent Service 公开预览:微软跑智能体循环和沙箱,开发者只带技能和工具
视角 · Skills + MCP + 子智能体,已经是 Anthropic、GitHub、微软共同的形状:智能体能力按 skill 和 MCP 来写,别绑死在某个平台上。真正要记住的是恢复那段:重启会用原始输入重跑,所以发邮件、建报告这类写操作必须先检查是否已经做过。PandaClaws 的发布步骤不管跑在哪个平台,都该加这个幂等检查。
出自 10-29 简报 · 第 08 条 → - Amazon Quick 推出智能审批:由独立的分类模型自动放行常规智能体操作,重要操作交给用户确认
视角 · 和 10-28 那条 Copilot 辅助权限是同一个思路:模型初筛、人看例外。它列出的「必须交给人」的五类(外发、改权限、删除、付款、超出请求范围)可以直接抄成自家智能体的默认清单;另外每次自动放行都要留日志,像 CloudTrail 一样能事后查。
出自 10-29 简报 · 第 09 条 → - Google 发布 Gemini API CLI 测试版:零依赖的命令行客户端,面向编码智能体、脚本和 CI
视角 · 用 CLI 而不是 SDK 给智能体加能力,是成本最低的做法,也正好能写成一个 skill。我会先在 CI 里用它做生成配图这类一次性任务;但安装时用 GEMINI_VERSION 锁版本,别直接 curl | bash 装最新版,10-24 的 LiteLLM 投毒还历历在目。
出自 10-29 简报 · 第 10 条 →
- GitHub Agentic Workflows 正式可用:用 Markdown 写自动化,编译成 Actions YAML,由 Copilot 或自带的编码智能体执行
-
10-28 · 周三 · 2 条
- Liquid AI 开放 LFM3 系列权重:1.7B 到 2B 级的文本、视觉、语音与全模态模型,单张 GPU 即可微调
视角 · 2B 级模型在网页智能体任务上从 3 分到 38 分,说明端侧小模型开始能干点实事。AI 云盘里文件分类、截图识别这类高频、低难度的活,我会拿 LFM3-VL-2B 用自己的数据微调一版试试;但许可证没写清楚之前,只做内部评测,不进产品。
出自 10-28 简报 · 第 04 条 → - GitHub Copilot 支持服务器到服务器认证:用 GitHub App 安装令牌调用 Copilot SDK,不再需要登录用户的凭据
视角 · 以前后台跑的编码智能体大多挂在某个员工的 PAT 上,人一离职就断,用量也算到个人头上。10-23 Enterprise 级 GitHub Apps 正式可用、10-25 用量指标按客户端拆分,再加上这一步,「智能体用组织身份、短期令牌、可单独计费」这条链补齐了。有自建 CI 智能体的团队,可以排期把个人令牌换掉。
出自 10-28 简报 · 第 06 条 →
- Liquid AI 开放 LFM3 系列权重:1.7B 到 2B 级的文本、视觉、语音与全模态模型,单张 GPU 即可微调
-
10-27 · 周二 · 4 条
- GPT-6.1 Terra 同日在 Amazon Bedrock 正式可用,OpenAI 测评称其完成任务比 GPT-6 Astra 快 3 倍以上
视角 · OpenAI 新模型当天上 AWS,和 10-21 宣布进 Google Cloud 一起看,「用哪家模型」和「在哪朵云上买」已经脱钩。账在 AWS 上的团队可以直接在 Bedrock 里试 Terra,但注意 Bedrock 文案写的是 100 万输入上下文,与 OpenAI 直连的 105 万略有出入,按你实际调用的那个渠道核对上限和价格。
出自 10-27 简报 · 第 02 条 → - Cloudflare 披露 GLM-5.3 跨请求泄露:155 条回复混入其他客户的数据,根因是 KV 缓存池小于上下文加上 SGLang 缺陷
视角 · 这是自托管开源模型最容易漏掉的一类风险:没有报错,只是悄悄串数据。用 SGLang 的先升到 0.5.22;上线前从运行中的引擎核对 KV 池大小不小于宣称的上下文长度,长上下文测试要检查输出内容(放标记字符串看会不会串到别人那),不能只看状态码。AI 云盘这种多租户文件问答,我会把这条加进发布检查表。
出自 10-27 简报 · 第 05 条 → - Google Docs 原生编辑 Markdown 文件,Drive 可直接预览,面向人和智能体协作
视角 · 智能体写的方案、文档越来越多是 Markdown,以前评审要么在 Git 里看 diff,要么转成 Docs 再改回去。现在可以让非技术同事直接在 Docs 里评论 .md 原文件。PandaClaws 的长文草稿我会先试这条路;但公告没讲和 Git 仓库的自动同步,进仓库前仍要自己导出。
出自 10-27 简报 · 第 07 条 → - AWS 给出 Bedrock 上 OpenAI 模型的提示缓存写法:隐式与显式断点并用,前缀至少 1,024 token
视角 · 这些规则不只适用于 Bedrock:把时间戳塞进系统提示开头,是我见过最常见的缓存失效原因。我在博客里写过 RAG 一个月的真实账单,结论是控制上下文长度回报最高;智能体同理,先把工具定义和指令做成固定前缀,再看缓存命中率,最后才考虑换模型。
出自 10-27 简报 · 第 09 条 →
- GPT-6.1 Terra 同日在 Amazon Bedrock 正式可用,OpenAI 测评称其完成任务比 GPT-6 Astra 快 3 倍以上
-
10-26 · 周一 · 1 条
- Amazon Bedrock 联网搜索支持域名过滤与用户位置:白名单或黑名单各最多 100 个域名
视角 · 我那篇 RAG 检索质量自查清单里说过,来源不可控是联网问答最常见的漏洞。做客服或资料问答的,我会先用 allowed_domains 把来源锁在自家文档和几个权威站点,再看回答覆盖率掉多少;目前只有美国区域,国内业务暂时只能当参考。
出自 10-26 简报 · 第 03 条 →
- Amazon Bedrock 联网搜索支持域名过滤与用户位置:白名单或黑名单各最多 100 个域名
-
10-25 · 周日 · 1 条
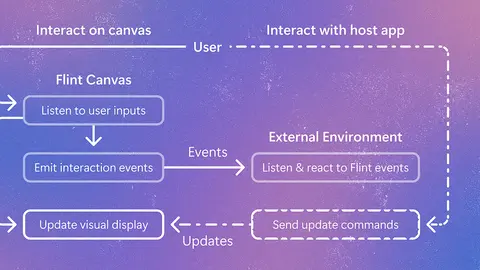
- Microsoft Research 发布 Flint-interactive:让智能体用一份交互规格生成可交互图表,不必反复写代码调试
视角 · 让模型输出「规格」而不是代码,是降低智能体出错率最便宜的办法之一,图表只是一个例子。我会在需要给用户出报表的功能里先试 Flint-MCP,比较一下和让模型直接写前端代码相比,失败率和 token 消耗差多少;它没有公布评测,结论要自己测。
出自 10-25 简报 · 第 07 条 →
- Microsoft Research 发布 Flint-interactive:让智能体用一份交互规格生成可交互图表,不必反复写代码调试
-
10-24 · 周六 · 2 条
- LiteLLM 1.107.0 遭供应链投毒:恶意代码借 Python 启动钩子运行,不用 import 也会窃取凭据
视角 · 模型网关是整个系统里钥匙最多的地方,这次连「没用到它、只是装了它」的 CI 和开发机都中招。我会先查所有锁文件和镜像里有没有 1.107.0,有就按凭据泄露处理、全部轮换;之后网关镜像一律按 digest 固定,升级走人工审核,别再用浮动 tag 自动拉新版。
出自 10-24 简报 · 第 01 条 → - AWS 公开一次多轮强化学习的完整账单:约 339 美元,gpt-oss-20b 的 Wordle 解题率从 61% 升到 84%
视角 · 339 美元这个数字很有用:一个规则清楚、能自动判分的多步任务,小开源模型一轮强化学习的成本已经低于一次外包测试。智能面试里「按评分规则追问」这类流程可以照这个套路试,但先把判分函数写扎实,别让模型学会钻打分的空子。
出自 10-24 简报 · 第 07 条 →
- LiteLLM 1.107.0 遭供应链投毒:恶意代码借 Python 启动钩子运行,不用 import 也会窃取凭据
-
10-23 · 周五 · 3 条
- Anthropic 把 Agent Skills 标准捐给 Linux 基金会旗下的 AAIF:已有 70 多个智能体平台接入,发布技能约 100 万个、安装近 2.8 亿次
视角 · 我会把团队内部的提示词和操作手册按 SKILL.md 的规范整理,别写成只认某一家的格式:标准进了中立基金会,同一套技能以后在 Claude Code、Codex、Copilot 之间能直接搬。PandaClaws 的内容生产流程本来就是一步步的规程,正适合拆成技能。安装别人的技能要当成装依赖来管,等官方安全指引出来之前,先只装看过脚本的。
出自 10-23 简报 · 第 01 条 → - SageMaker AI 训练会话正式可用:自己写后训练循环和奖励函数,GPU 由 AWS 管,按处理的 token 计费
视角 · 「打分时不计费」这一点对多轮智能体训练很关键,评测环境慢也不白花 GPU 钱。我会先拿下一条 ThinkingBox 那种「检查最终状态」的奖励,在一个小开源模型上跑几十步看曲线,再决定值不值得为某个固定任务养一个专用模型。
出自 10-23 简报 · 第 05 条 → - Microsoft 开源 ThinkingBox-Training:用数据库最终状态作奖励,50 步 GRPO 让 Qwen3.8-27B 平均成功率从 51.70% 升到 60.78%
视角 · 就算不训练,这套思路也该先用在评测上:AI 云盘里让智能体整理、移动文件,验收看的应该是目录和权限最后变成什么样,而不是它说自己做完了。「20 次全对」从 38 个升到 107 个,比平均分更贴近线上体验,这个指标值得抄。
出自 10-23 简报 · 第 06 条 →
- Anthropic 把 Agent Skills 标准捐给 Linux 基金会旗下的 AAIF:已有 70 多个智能体平台接入,发布技能约 100 万个、安装近 2.8 亿次
-
10-22 · 周四 · 2 条
- Commerce.com 借 Cloudflare 边缘为旗下店铺统一开启 WebMCP,购物智能体改调结构化工具、不再猜 HTML
视角 · 标准还在实验阶段,不必急着上线,但值得先列出自己产品里最常被智能体代劳的三五个动作,比如 AI 云盘的搜索文件、PandaClaws 的查数据,先做成只读工具。平台型产品可以学这里的做法:默认统一开启,但给每个租户一个退出开关。今天推荐的 axuse 从另一头说明了同一件事:给智能体结构化接口,比截图点按钮靠谱。
出自 10-22 简报 · 第 07 条 →
- Commerce.com 借 Cloudflare 边缘为旗下店铺统一开启 WebMCP,购物智能体改调结构化工具、不再猜 HTML