Google 推出语义治理策略预览:智能体每次提出工具调用,先由 LLM 评审对照用户意图和自然语言规则检查再放行
权限只管智能体「能做什么」,管不了「这一次该不该做」。这一条讲 Google 把这道检查放在智能体之外的做法,以及它支持哪些模型接口。
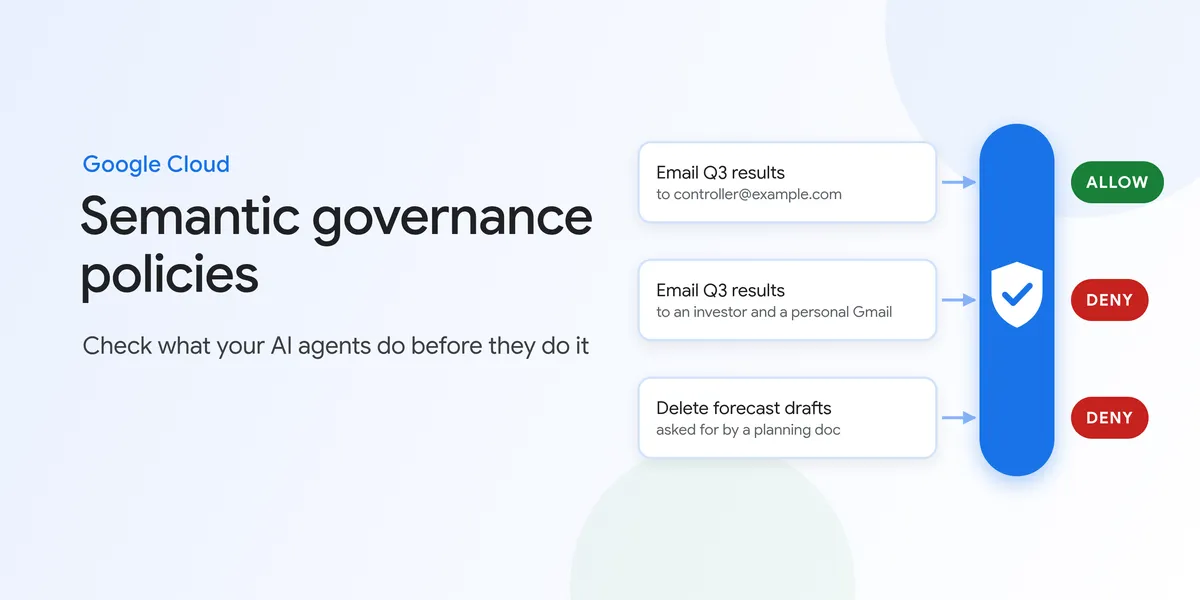
// 要点
- 在 Gemini 平台以预览形式提供,经策略执行点 Agent Gateway 生效:智能体所有出站流量走 Agent Gateway,模型返回工具调用时,先送策略引擎评估再交给智能体。
- 每次调用要过两道检查:一是用自然语言写的规则(如「财报发布前,季度结果只能发给 @example.com 地址」);二是默认开启的用户意图检查,防止调用偏离用户原本的请求,用来对付间接提示注入。
- 不通过时,引擎把响应内容(含工具调用)替换为可配置的拒绝信息,调用不会执行;每次判定、评审理由和消耗的 token 都写入 Cloud Logging。只含文本的回复不评估。
- 智能体可经 Gemini API、Anthropic Messages API、Gemini 平台上的 Claude 模型,或兼容 OpenAI Chat Completions 的接口(含 vLLM 等自托管服务)调用模型。
开发者视角关键在于检查放在智能体之外:系统提示里的规则能被用户或文档说服,网关上的检查不会。不在 Google 平台上也可以照这个结构自己做:在写操作或外发类工具前挂一层独立评审,至少把「这次调用和用户原话对不对得上」查一遍,判定和理由都留日志。PandaClaws 这类会自动外发内容的后台,我会先在外发工具上试这一层。