首页 / AI 简报 / 2026-11 / 11-22 2026-11-22 · 周日 · 9 条 Google 在智能体之外加一道调用审查、AWS Quick 按岗位打包插件、AWS 把 KV 缓存部署写成技能 周末这期的主线是「把规矩放到智能体外面」:Google 在网关上用独立评审逐次检查工具调用,AWS 用域名验证给智能体身份、用插件和技能交付能力。开源这边,NVIDIA 的两篇把自托管推理最容易出错的两处(RL rollout 和工具调用解析)补上了工程化方案。
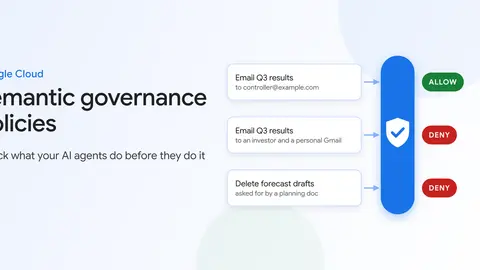
在 Gemini 平台以预览形式提供,经策略执行点 Agent Gateway 生效:智能体所有出站流量走 Agent Gateway,模型返回工具调用时,先送策略引擎评估再交给智能体。 每次调用要过两道检查:一是用自然语言写的规则(如「财报发布前,季度结果只能发给 @example.com 地址」);二是默认开启的用户意图检查,防止调用偏离用户原本的请求,用来对付间接提示注入。 不通过时,引擎把响应内容(含工具调用)替换为可配置的拒绝信息,调用不会执行;每次判定、评审理由和消耗的 token 都写入 Cloud Logging。只含文本的回复不评估。 智能体可经 Gemini API、Anthropic Messages API、Gemini 平台上的 Claude 模型,或兼容 OpenAI Chat Completions 的接口(含 vLLM 等自托管服务)调用模型。 开发者视角 关键在于检查放在智能体之外:系统提示里的规则能被用户或文档说服,网关上的检查不会。不在 Google 平台上也可以照这个结构自己做:在写操作或外发类工具前挂一层独立评审,至少把「这次调用和用户原话对不对得上」查一遍,判定和理由都留日志。PandaClaws 这类会自动外发内容的后台,我会先在外发工具上试这一层。
插件把连接器(接系统)、技能(团队做法)、智能体(推理任务)和流程(编排)打包,用户一步装好一项工作需要的全部能力。 官方插件如「日历与会议助手」「销售开发」;覆盖日常办公、财务 / 市场 / 法务等岗位、行业和常用业务应用的技能与插件超过 100 个。 构建者在对话里描述工作,Quick 自动拼装插件,可分享给团队发现使用;同批更新还加入多智能体编排,多个专门智能体并行处理同一请求再汇总成一个回答。 另以预览提供企业级护栏:内容过滤、拒绝话题、提示攻击检测、PII 控制,可按用户或 IdP 组下发,并有只检测不拦截的试运行模式。 开发者视角 「插件 = 连接器 + 技能 + 智能体 + 流程」这个打包单位,和编码工具里的 skill / plugin 已经是同一套语言,企业办公侧也在收敛到它。做企业 AI 产品的,我建议把能力也按岗位打包交付,而不是只给一个通用对话框;护栏的「只检测」模式值得照抄,上线拦截规则前先在真实流量上看误伤。
在 GPU 本地缓存之外加一层与 GPU 机群相邻的共享 KV 层,任一服务器都能跨会话、路由切换和故障复用 KV 状态,最长可保留数天;AWS 称成本最多降 40%、首 token 延迟最多降 80%。 技能收录在 Agent Toolkit for AWS,可在 Kiro、Claude Code、OpenAI Codex 等支持 Agent Skills 的编码智能体里用:先做适配检查,用 KVTrace 按你自己的流量估算收益,收益覆盖不了缓存成本就停。 通过 LMCache 连接器接入现有 vLLM 或 SGLang(含 llm-d、Ray Serve 下的 vLLM),统一各服务器的 KV ID 机制与数据类型;上线前清空本地层,核对两次缓存加载运行输出一致。 前提包括支持 EFA RDMA 写的 GPU 实例(如 p5)、LMCache 0.5.8rc1+、vLLM 0.11.1+(或 SGLang 0.5.13+)和 ElastiCache for Valkey 9.1+;创建、修改、删除资源前需显式确认。 开发者视角 更值得学的是这个技能的写法:先只读检查、再用自己的流量估收益、算不过账就停、高影响操作要人确认,这是把运维知识写成 skill 的好样板。长对话占比高的自托管服务,我会先跑 KVTrace 看缓存命中率再决定;注意它提醒的那个坑:布局不一致时命中计数正常但答案是错的,上线前一定要做输出一致性核对。
AWS 用同一评测设置在 BIG-Bench Hard、GPQA Diamond、MMLU-Pro 三项推理基准上评测每个模型,并按每种 JumpStart 部署配置实测首 token 延迟、吞吐和 SageMaker 实例成本。 首发覆盖 70 多个 LLM,来自 Meta、Google、Qwen、IBM、Arcee 等。 可按提供方、许可证、输入输出模态筛选,并选用例画像和优化目标(均衡、成本、延迟或吞吐)查看对应配置的指标。 不额外收费,在所有提供 SageMaker Studio 的 AWS 商业区域可用。 开发者视角 把质量分和「这个配置下的延迟与每小时成本」放在一张表上,比单看榜单有用得多。三项基准都是通用推理题,不代表你的业务;我会用它做第一轮筛选,把候选缩到三四个,再拿自己的任务集跑最后一轮,智能面试这类对延迟敏感的场景优先按延迟目标看。
在 Bedrock AgentCore 和 Bedrock 上新增西班牙语、法语、德语、意大利语、日语 5 种语言及非美式英语,结果会引用当地语言来源。 新增可选 country 字段,传 ISO 3166-1 alpha-2 代码(如「JP」「DE」)让结果偏向该国来源,适合当地法规、价格、公职人员这类随地点变化的问题。 AgentCore 版在美东(弗吉尼亚北部、俄亥俄)、美西(俄勒冈)、悉尼、东京、爱尔兰可用,Bedrock 版在美国区域可用;查询在调用所在区域处理,便于满足数据驻留要求。 现有客户无需改代码自动获得新语言,各语言价格相同。 开发者视角 中文还不在列,国内产品暂时用不上,但 country 字段这个设计值得借鉴:搜索类工具的参数里显式带上用户所在地,比让模型自己在查询里猜国家可靠。做跨地区产品的,我会把「用户地区」作为工具调用的固定参数从会话上下文里注入,而不是交给模型决定。
开发者和网络管理员先做域名所有权验证,再把验证过的域名关联到智能体和 AI 工具,使其在自己的注册表和 AWS 账户之外公开可见。 公开的智能体记录锚定在已验证的域名身份上,连接前可以确认来源;发布后任何 AWS 认证用户都可用语义和关键词搜索找到。 同日 Agent Registry 新增 WebBotAuth(WBA)机器人记录类型,机器人用域名证明身份,可与 AWS WAF Bot Control 结合,按验证状态和机器人身份写放行或拦截规则。 公开命名与发现目前不额外收费,在所有提供 Agent Registry 的区域可用。 开发者视角 和前几天的智能体独立身份、按任务收窄凭证连起来看,智能体的「身份证」这一层正在补齐:域名证明你是谁,凭证限制你能做什么。我的建议是,对外开放的智能体接口先把调用方身份记清楚,网站侧则开始区分已验证的爬虫和普通流量,别一刀切全拦。
技能引导智能体为每份文档选对 Textract Core API,并带一个经过测试的解析器,把输出转成阅读顺序文本和结构化字段,如问答、收据发票明细、身份证件字段。 支持多页 PDF,按阅读顺序返回每一页;用置信度接受高置信结果、标记其余,便于转入你自己的人工复核流程。 技能本身不额外收费,按标准 Textract 价格计费;在所有提供 Textract 的商业区域可用,包括东京、首尔、新加坡、悉尼等亚太区域。 使用 AWS MCP 服务器和 aws-core 插件时智能体可自动加载;技能也发布在 AWS Agent Toolkit 中。 开发者视角 和昨天的 Textract Insights 一起看,AWS 在文档这块同时给了「托管接口」和「智能体技能」两条路。AI 云盘的文档入库流程里,我会照它的做法加一道置信度分流:高置信字段直接入库,低置信的标出来让用户确认,而不是全部信任或全部重跑。
Dynamo 位于 rollout 编排与推理 worker 之间,负责路由、worker 管理和遥测;RL 框架仍掌管优化、奖励、环境和样本接收。 KV 感知路由在缓存复用和 worker 负载之间取平衡,减少多次尝试共用指令或代码仓库上下文时的重复前缀计算。 ModelExpress 传输压缩后的增量权重并复用已在显存中的权重;worker 故障时请求转到健康容量,替换 worker 用检查点加增量追上。 H Company 使用后平均单步训练时间最多缩短 20%、GPU 时最多减少 5%;已有 verl、NeMo RL、Slime、prime-rl 的开源集成。 开发者视角 和昨天 Hugging Face 的 harness 适配器、前几天的 DaisyRose-27B 放在一起,小团队做智能体 RL 的工具链越来越完整,瓶颈也从算法转到推理基础设施。真打算给自家流程训适配器的,我会先看用的 RL 框架是否在这四个集成里,再评估要不要上 Dynamo;规模不大时 5% 的 GPU 时节省未必抵得上引入新组件的成本。
解析器把模型输出(token ID 或解码文本)拆成可见文本、推理和工具调用事件,按文档化的恢复规则处理格式错误、不完整和流式输入,不猜测模型意图,也不泄漏模型专用标记。 共享的一致性测试集把各模型的输入与期望 GOLDEN 输出配对,UNIFIED.* 用例可在 Beam、GPT-OSS、Muse Spark、Nemotron 3 等模型家族间复用。 新增解析器的流程:从 UNIFIED.* 改编一套 GOLDEN 测试,按模型语法实现解析器,用本地一致性报告验证;仓库里附带供智能体使用的 tool-parser-generator 技能。 支持引导解码,把生成约束在模型的标记和参数 schema 内以减少格式错误,但截断和语义错误仍需解析器的恢复检查。 开发者视角 自托管开源模型的人大概都踩过「工具调用解析错一半」的坑,这套跨模型的测试集比解析器本身更有价值。我的做法是:换新开源模型前,先拿 UNIFIED.* 这类用例把自己推理栈的工具调用解析跑一遍,尤其是流式和截断场景,再谈效果对比。
本期由 AI 辅助检索与起草,选题标准与观点由 Darius 设定。
每周一,一封邮件看完 AI 大事 每周一早上,把过去 7 天最值得关注的 6 件 AI 大事和我的解读发到你邮箱。
邮箱只用于发送周报,不会提供给任何第三方;每封邮件底部都可以一键退订。 看看最近一期 →