本季度搭建AI简报流水线的五个关键决策
ALT: 工程师视角下搭建AI简报流水线的五个关键决策与权衡
搭建AI简报流水线:你绕不开的五个决策
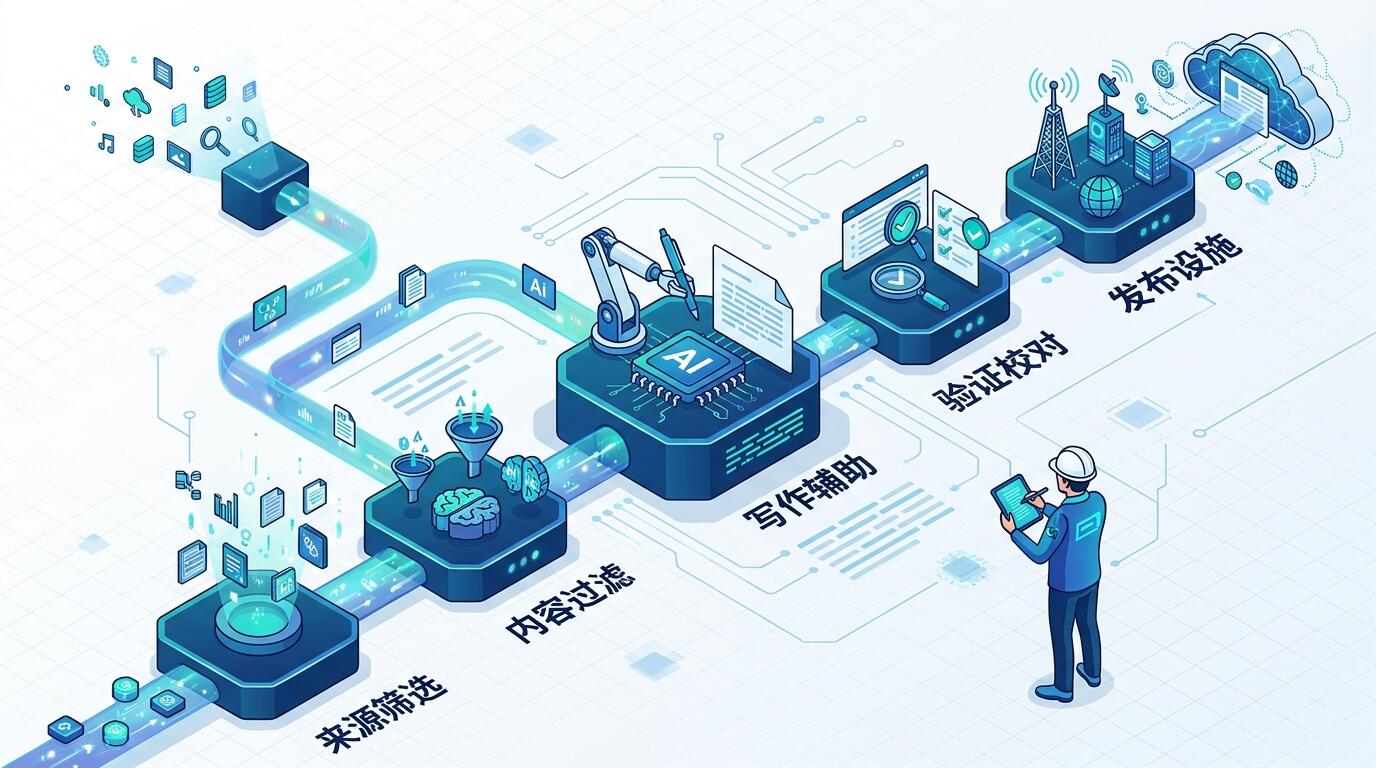
构建一条稳定运行的 AI 简报生产流水线,核心挑战并不在于"用不用 AI",而在于如何在自动化效率与内容可信度之间找到可持续的平衡点。这五个关键决策,正是我们在实际搭建和迭代自己的简报系统过程中,反复碰壁、反复校准后沉淀下来的判断。
本文面向正在或计划构建 AI 内容生产系统的开发者与技术负责人。以下五个决策点的选取标准很直接:每一个都曾经是流水线卡壳的直接原因,每一个的取舍都会显著影响后期的运营成本与内容质量。它们不是理论框架,是真实走过的坑。
五个让流水线真正跑起来的关键决策
信源结构:全自动抓取还是人工精选种子
信源策略是整条流水线的上游,决定了后续所有处理步骤的输入质量。简单来说,全自动抓取和人工精选种子代表两种截然不同的工程哲学:前者追求覆盖广度,后者优先保证基准可信度。
在我们早期的实践中,曾尝试完全依赖 RSS 聚合加关键词过滤来驱动内容抓取,结果是每天产出几百条候选条目,但真正值得写进简报的不超过十条。大量的算力和审核时间被用于过滤噪声,而非提炼洞见。后来我们转向"精选种子信源 + 动态扩展"的混合策略:维护一份经过人工评审的核心信源列表,每季度更新一次;同时允许系统通过引用溯源自动发现新信源,再经由编辑确认后纳入池子。
这个决策的本质是:你愿意用多少人工成本换取多少信源的确定性。对于定位严肃的 AI 简报来说,信源质量直接决定内容的可引用性,这一点不宜为了自动化而妥协。
Best for: 对内容可信度要求高、读者群体为专业从业者的简报团队
Watch out: 精选信源列表容易固化,需要建立显式的周期性审查机制,否则会错过新兴的高质量信源
内容筛选:LLM 打分还是规则引擎
信源进来之后,第二个决策是如何筛选哪些条目值得处理。这里有两条路:用大语言模型(LLM)做语义相关性评分,或者用确定性规则引擎做过滤。
根据 IEEE 软件工程相关研究对自动化内容管道的分析,纯规则系统在领域明确、标准稳定的场景下具有可解释性优势,但在语义理解层面存在明显天花板。LLM 打分在捕捉"这条内容是否真的有实践价值"这类模糊判断上表现更强,但存在不稳定性和幻觉风险——同一条内容在不同 prompt 下可能得到显著不同的评分。
我们目前采用的方案是两阶段过滤:第一阶段用规则快速淘汰明显不相关的内容(比如纯营销稿、重复内容),第二阶段用 LLM 对剩余候选做相关性与实践价值的双维度评估。这样既控制了 LLM 调用成本,也避免了规则系统在语义层面的僵化。
值得注意的是,LLM 评分的 prompt 工程本身是一个持续迭代的工作。我们维护一份编辑 Agent 能够实际遵循的规则文档,将评分标准显式化,这样既便于调试,也便于新成员理解系统逻辑。
Best for: 内容量大、主题边界相对清晰的简报流水线
Watch out: LLM 评分的一致性需要定期抽检;不要假设模型的判断标准会保持稳定,尤其是在底层模型版本升级后
写作辅助深度:生成草稿还是仅做提纲
这是五个决策里争议最大的一个,也是最容易做错的一个。让 LLM 直接生成简报条目的完整文本,还是只用它来生成结构提纲、由人完成最终写作?
表面上看,全生成更高效;实际上,全生成在面向专业读者的场景下往往适得其反。AI 生成的文本在技术细节的准确性、来源引用的可靠性、以及判断性语句的分寸感上,和有实际工程经验的作者之间仍然存在可感知的差距。专业读者对这种差距是敏感的。
我们在 Darius 简报的实践中,明确选择了辅助而非替代的定位:LLM 用于信息摘要、关键点提取和初步结构化,人工负责判断取舍、补充第一手视角、以及最终的文字打磨。这个分工的边界不是为了追求"纯人工"的标签,而是因为在我们处理的这类内容(AI 产品实践、技术架构决策)中,判断性语句的质量直接决定内容价值。
如果你的简报定位是信息聚合型(覆盖广度优先),全生成可以接受;如果定位是判断型(实践洞见优先),建议保留人工在关键环节的主导权。
Best for: 对内容深度和实践价值有明确要求的专业简报
Watch out: "辅助写作"的分工如果没有明确的工作流界定,很容易退化成"人工微调 AI 稿",实质上仍然是全生成,只是多了一层形式上的审核
验证机制:事实核查的自动化边界
一条 AI 简报如果引用了错误的数据或归因不实的观点,对读者信任的损耗是非线性的。因此,验证机制的设计是流水线中不能省略的环节,问题只是自动化到什么程度。
目前行业内常见的做法包括:溯源链路检查(验证引用是否指向一手信源)、交叉比对(同一事实点是否有多个独立信源支持)、以及时效性检查(发布日期与事件时间线是否吻合)。这些都可以程度不同地自动化。
但有一类验证是自动化工具处理不好的:对技术判断类陈述的正确性核查。比如"某模型在特定任务上的表现优于另一个模型"这类陈述,需要了解测评方法论和局限性才能判断是否合理引用,这不是一个纯文本匹配问题。
我们建议将验证分为两层:结构性验证(信源是否存在、日期是否准确、引用是否对应原文)由自动化处理;判断性验证(技术陈述是否合理、上下文是否完整)保留人工。这与我们在AI 简报 Agent 管道的完整技术报告中描述的分层设计一致。
Best for: 面向技术专业读者、对引用准确性有较高要求的简报
Watch out: 自动化验证容易产生"验证通过了所以内容没问题"的误判心理——自动化验证只能覆盖可机器检查的维度,不能替代判断
发布节奏与基础设施:构建还是购买
流水线的最后一公里是发布,这里涉及一个对所有 AI 产品团队都普遍存在的经典问题:自建基础设施还是使用现成方案?
对于简报发布场景,现成方案(如主流邮件服务商、Notion + 自动化工具等)在初期能快速跑通;但当流水线需要双语支持、多渠道分发、内容版本管理和分析反馈闭环时,现成方案的组合成本和灵活性限制会逐渐显现。
我们的判断是:发布层不是差异化竞争力所在,应尽量避免自建;但内容数据库和读者行为数据的所有权必须掌握在自己手中。具体来说,邮件发送、渠道分发可以用成熟的 SaaS;内容存储、标签体系、读者数据应该用自己控制的系统。
这个决策也与 AI 基础设施的 Build vs. Buy 框架高度相关——根据对 AI 基础设施构建与采购决策框架的系统性梳理,差异化价值层应自建,标准化能力层应采购,这个原则在简报流水线的基础设施决策中同样适用。
Best for: 希望长期运营、有数据所有权意识的简报团队
Watch out: 过早自建发布基础设施是常见的资源错配——在读者规模和内容节奏稳定之前,优先跑通内容生产闭环,基础设施可以渐进演进
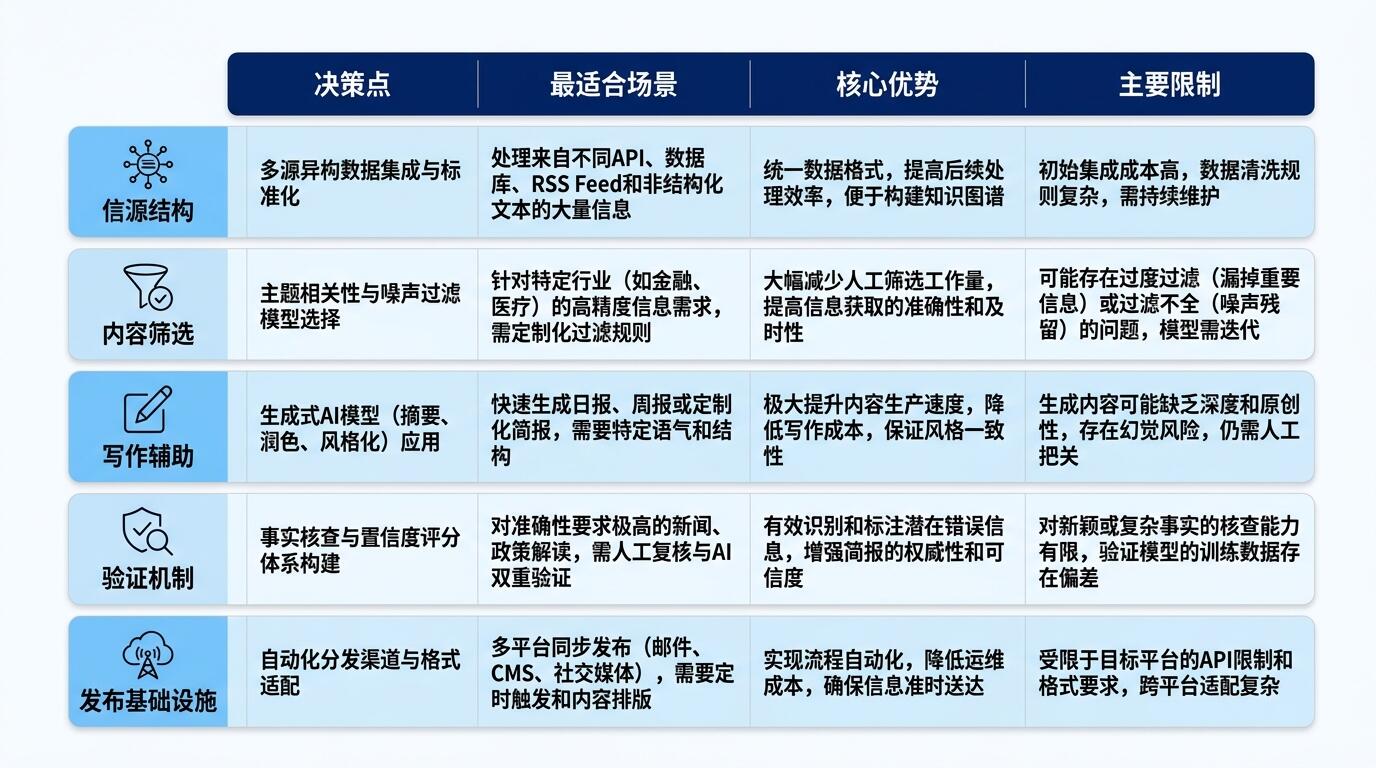
五个决策一眼对比
| 决策点 | 最适合的场景 | 核心优势 | 主要限制 |
|---|---|---|---|
| 精选种子信源 | 专业读者、高可信度要求 | 输入质量稳定,噪声低 | 需要显式维护,容易固化 |
| 两阶段内容筛选 | 内容量大、主题边界清晰 | 兼顾效率与语义理解 | LLM 评分一致性需持续监控 |
| 辅助写作(非全生成) | 判断型内容、专业受众 | 保留实践判断的质量优势 | 需要清晰的工作流分工界定 |
| 分层验证机制 | 高引用准确性要求的简报 | 覆盖可机器检查的维度 | 无法替代判断性核查 |
| 数据自有 + 发布外包 | 长期运营、有扩展需求 | 灵活性与所有权兼顾 | 初期系统集成有一定复杂度 |
ALT: AI简报流水线五个关键决策的权衡对比:信源结构、内容筛选、写作辅助、验证机制与发布基础设施选型对照表
如何根据自身情况选择适合的方案
这五个决策并不是独立的,它们之间存在明显的耦合关系。一个高效的决策路径是:先确定定位,再推导决策。
如果你的简报定位是信息密度高、覆盖面广,那么信源策略可以更激进,内容筛选可以更多依赖自动化,写作辅助可以接受更高的 AI 生成比例。代价是需要更强的验证机制来对冲错误率。
如果定位是判断深度强、读者为技术决策者,那么信源精选的投入值得做,写作辅助必须保留人工主导,验证机制的分层设计不能省略。发布基础设施可以相对简单,因为读者忠诚度更多来自内容质量而非分发效率。
一个常见的误判是:把"流水线自动化程度"等同于"效率"。实际上,对于专业内容简报来说,过度自动化的代价通常在三到六个月后才会显现——读者流失、引用被指出错误、或者订阅者反馈内容"感觉像 AI 写的"。这些是很难用数据即时捕捉到的信任损耗。
另一个容易忽视的点是:这五个决策都需要周期性复盘,而不是一次性设定。AI 模型能力在快速演进,信源的质量和活跃度在变化,读者的期望也在变化。我们建议每季度对这五个维度做一次显式的审查,而不是等问题出现再调整。
常见问题
Q1:如何判断简报流水线是否需要引入 LLM 辅助,而不是完全人工?
LLM 辅助适合引入的临界点,通常是内容量超出人工处理能力、且重复性结构化任务占比较高的时候。具体来说,如果你每期需要处理超过五十条候选信源、或者需要维护双语版本,LLM 在摘要、翻译和结构化方面的价值会显著超过其引入的复杂度。但如果内容量较小且读者对准确性要求极高,人工主导仍然是更稳健的选择。
Q2:AI 生成的简报内容是否会影响读者信任?
会,但影响的大小取决于读者群体和内容定位。根据 Nielsen Norman Group 等用户体验研究机构对数字内容可信度的长期研究,专业读者对生成式内容的感知能力在逐步提升,尤其是在技术领域。如果你的读者是工程师或技术决策者,对内容分寸感和判断质量的要求会更高。混合工作流(AI 辅助 + 人工判断)通常比全自动生成更能维持这类读者的信任。
Q3:搭建一条基本可用的 AI 简报流水线大概需要多少时间投入?
这取决于你对"可用"的定义。一个能跑通信源抓取、LLM 筛选和邮件发布基本流程的 MVP 系统,有经验的工程师通常需要几周时间完成初版。但真正稳定运行——包括验证机制、错误处理和周期性审查流程——需要持续迭代。我们在实践中的经验是:头两个月主要在调试,第三个月开始进入相对稳定的节奏,之后每个季度仍会有针对性的优化。
核心结论
- AI 简报流水线的质量瓶颈通常不在技术选型,而在信源结构和验证机制的严肃程度。
- 写作辅助的深度应与内容定位直接挂钩:判断型内容必须保留人工主导,信息聚合型内容可以接受更高的自动化比例。
- "自动化程度越高效率越高"是误判——对专业读者来说,信任损耗的代价往往高于效率提升的收益。
- 发布基础设施遵循 Build vs. Buy 原则:标准化能力采购,数据所有权自持。
- 五个决策需要周期性复盘,不能一次性设定后不管。
建议的下一步是:对照以上五个维度,先审查你现有流水线(或计划中的流水线)在哪个环节定义最模糊——通常那就是最先需要明确的决策点。如果你希望了解如何在 AI 工具评估阶段就把这些决策考虑进去,可以参考在签约前系统评估 AI 开发工具的方法论。
如果你正在构建 AI 产品,或希望每周用最短的时间掌握真正值得关注的 AI 动态,欢迎订阅 Darius 双语简报。每一期内容均来自一手来源,并附有来自真实生产环境的实践判断——访问 Darius 即可开始阅读,和数千位正在构建 AI 的人一起保持在前沿。
参考资料
- IEEE. "Software Engineering Standards and Practices for Automated Content Systems".
https://www.ieee.org/ - Nielsen Norman Group. "Credibility and Trust in Digital Content".
https://www.nngroup.com/