OpenAI 公开 Performance Factory:Codex 驱动的性能回归流程三个多月跟踪 1,700 多次调查,找到 600 多个根因
一个把告警到修复验证全程交给智能体的生产案例。这一条讲它的四个组成部分和演进路径,适合想把编码智能体从对话里搬进流程的团队。
// 要点
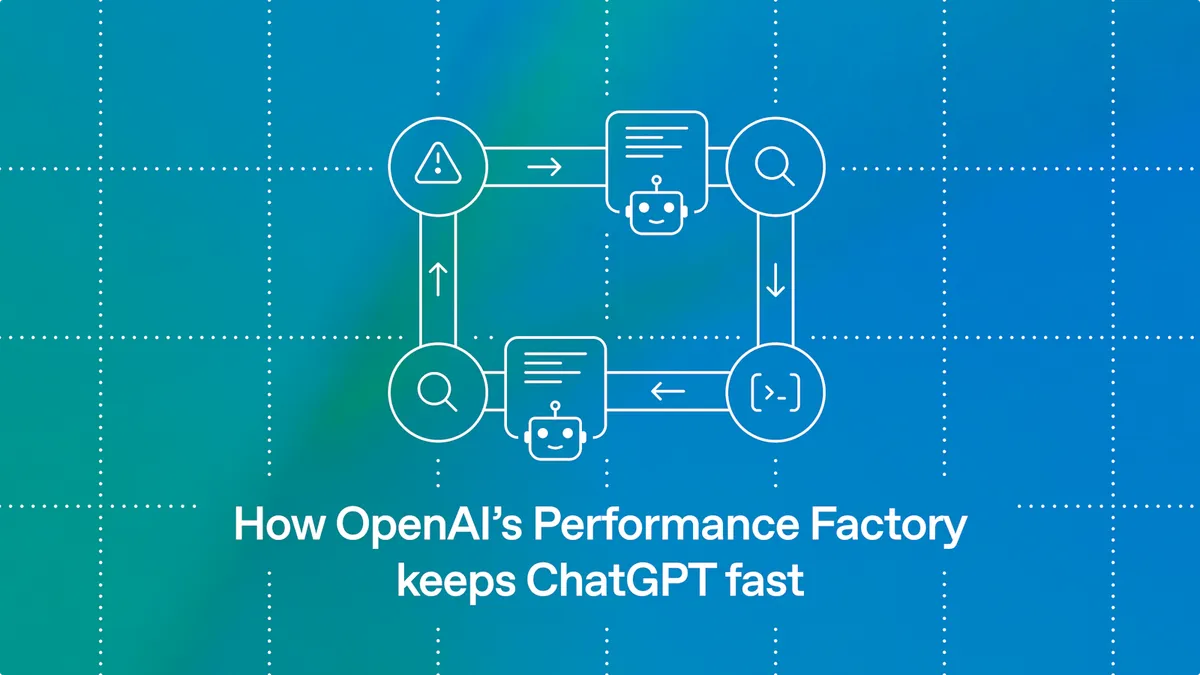
- 回归流程在性能告警触发时开任务:智能体调查、记录发现并提出修复交工程师审查,部署后另一个智能体检查性能是否回到基线。
- 三个多月里跟踪了 1,700 多次调查、找到 600 多个根因,相当于每天 17 次自动调查。
- 由四部分组成:可配置工作流的任务服务(Markdown 提示词加配置文件)、分派就绪任务的循环、在云端运行 Codex 的 API,以及在 GitHub 评论或部署完成时唤醒智能体的订阅。
- 团队先把排查经验写成共享 skill「perf-forensics」,并用过往回归做评测来打磨,然后才走向全自动。
开发者视角值得抄的不是规模,而是路径:先把老手的排查步骤写成 skill,再用历史事故做评测,最后才接告警自动跑,人只留在审查和合并。我们的 PandaClaws 后台也可以照这个顺序,从最常见的发布失败告警开始,先做到「自动给出诊断」,再谈自动修。