NVIDIA 公布 MLPerf Endpoints v1.0 暂定成绩:Vera Rubin NVL72 在智能体推理上每千瓦吞吐是 GB300 NVL72 的 5 到 10 倍
MLPerf 新出了按智能体负载测推理端点的基准,NVIDIA 用三款开源模型交了下一代机柜的成绩。这一条讲测什么、差多少、哪些还没核验,适合在估算托管开源模型长期成本的团队。
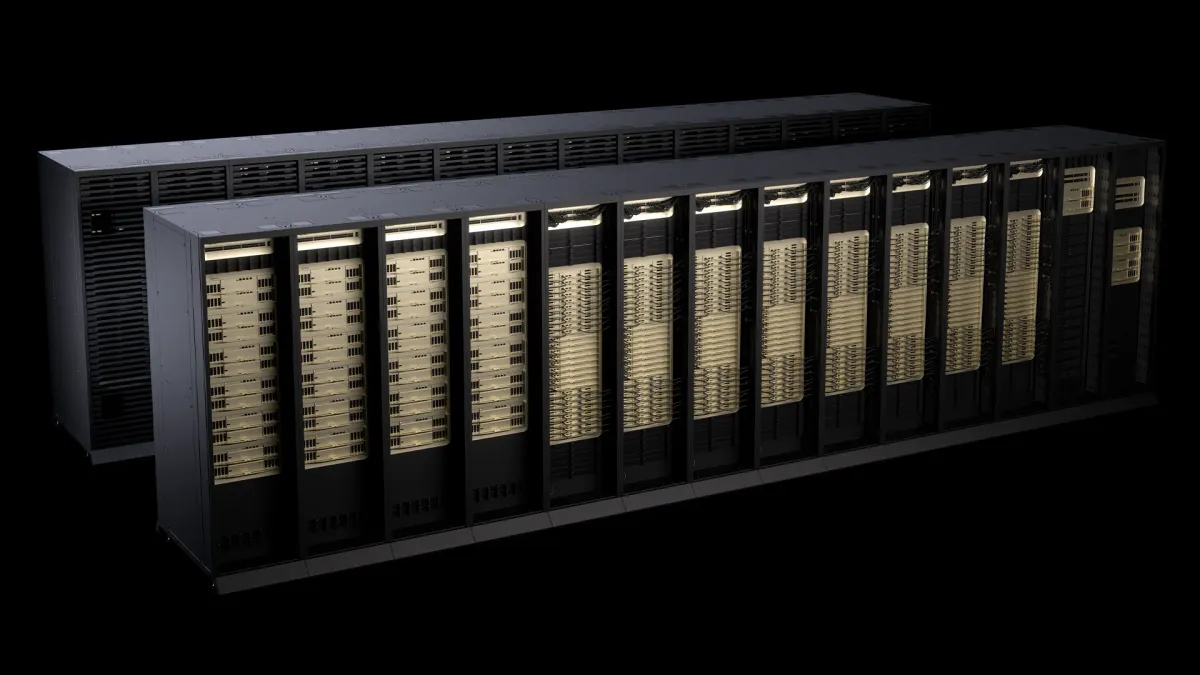
// 要点
- Endpoints v1.0 通过 API 端点、用编码和企业工作流衡量服务容量与响应速度的平衡;运行时会把生成的工具调用和工作流意图与参考值比对,另用 SWE-bench Verified 评估端到端解题能力。
- 在 Kimi K3、DeepSeek-V4.1-Flash 与 Qwen3.6-35B-A3B 上,Vera Rubin NVL72 每千瓦吞吐是 GB300 NVL72 的 5 到 10 倍,相同并发下端到端交互速度高 3 到 5 倍;Kimi K3 在每用户至少 50 token/秒的门槛下每千瓦吞吐超过 10 倍。
- Vera Rubin 的成绩是暂定的,尚待 MLCommons 核验;GB300 的成绩已核验。
- NVIDIA 把提升归于前缀缓存、状态复用、Dynamo 路由与预填充 / 解码分离,以及 DeepSeek 的 MegaMoE 内核、Qwen 的多 token 预测等针对模型的优化。
开发者视角对不自建机房的团队,这条说明托管开源模型的单价还有下降空间,但成绩是暂定的,我不会据此提前锁长期合同。更现实的是文中那几招,和今天 Hugging Face、Bedrock 两条讲的是同一件事:智能体负载的成本大头在重复的上下文,先把缓存和会话粘性做好。