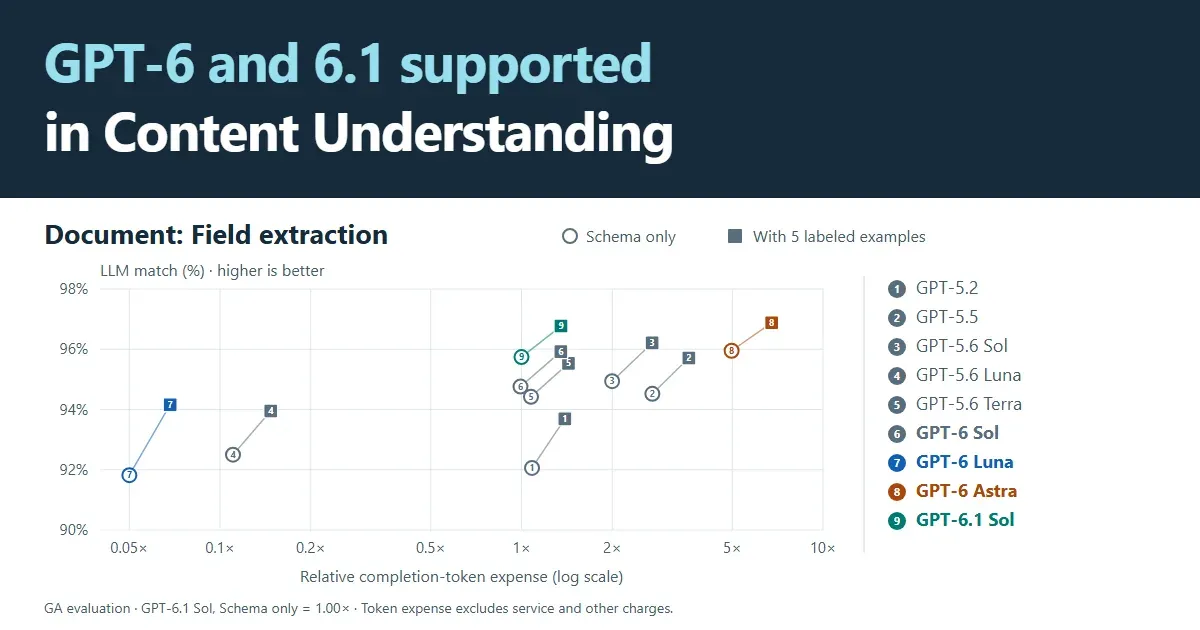
Azure Content Understanding 支持 GPT-6 与 GPT-6.1 并公开评测:文档抽取默认选 GPT-6.1 Sol,GPT-6 Astra 只高 0.21 个百分点、补全 token 花费约 5 倍
微软给文档、语音、视频处理的模型选择更新了建议,并给出数据。这一条讲各档模型的差距,以及「先加样例再升模型」这个更便宜的办法。
// 要点
- Content Understanding 新增 GPT-5.6、GPT-6 与 GPT-6.1 系列;标准文档抽取建议从 GPT-6.1 Sol 开始,重视成本时用 GPT-6 Luna。
- 正式版抽取评测中 Astra 以 95.95% 对 95.74% 小幅领先 Sol(仅用 schema),但补全 token 花费约为 Sol 的 5 倍;在预览版抽取评测里反而是 Sol 领先(96.06% 对 95.58%)。
- 给 Luna 加 5 个标注样例,抽取质量从 91.82% 提到 94.16%,token 花费仍远低于 Sol。
- 不同任务最优模型不同:文档分段 Astra 领先(98.00% 对 97.10%),视频生成 F1 最高的是 GPT-6 Sol(86.40%)。
开发者视角这组数据的价值在于说明「贵一档」往往只换来零点几个百分点。AI 云盘的文档字段抽取,我会先给便宜档补 5 个标注样例跑一遍,再决定要不要升模型;分段和抽取分开评测、分开选模型。