Dharma AI 的 2B 字段抽取模型把文档字段输出为带类型的 JSON,在其基准上与 Claude Opus 5 差距 1.8 分,成本低约 6 到 147 倍
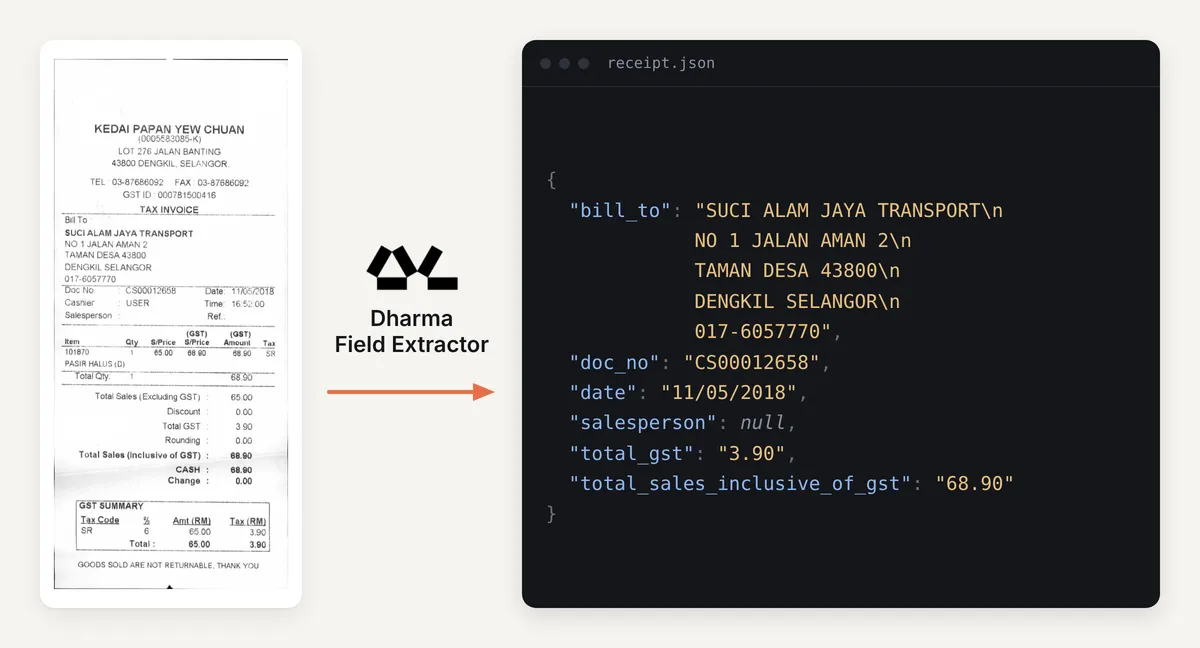
用小而专的模型解决量大、边界清楚的任务:从发票、表单、证件里抽出指定字段,输出系统能直接用的 JSON。
// 要点
- 基于 DharmaOCR-LITE v1.1(20 亿参数),在 43,384 条样本上训练 LoRA 适配器;可开放抽取,也可按指定 schema 填充,文档上没有的字段返回 null
- 基准含 546 份文档、三种请求场景,共 1,638 个用例,评分为字段级 F1 乘以取值相似度再乘以合法 JSON 比例
- 与通用大模型相比,质量差距从 1.8 分(Claude Opus 5)到 9.3 分(GPT-5.6 Luna)
- 成本比 GPT-5.6 Luna 低约 6 倍、比 GPT-5.6 Sol 低约 147 倍,按单张 L40S 每小时 2.24 美元的自托管 GPU 时间计
开发者视角要注意基准是厂商自己的,前沿模型分数仍然更高,但成本差距大到值得认真看。AI 云盘里的发票、收据字段抽取正是这类活;我会拿几百份我们自己的文档跑一遍,只把低置信度的转给大模型。