降低存储与向量成本的进阶策略:本季度的联合优化实践
ALT: AI产品构建者通过联合优化策略降低向量存储与检索成本的工程实践指南
存储成本与向量成本:为什么单独优化往往事倍功半
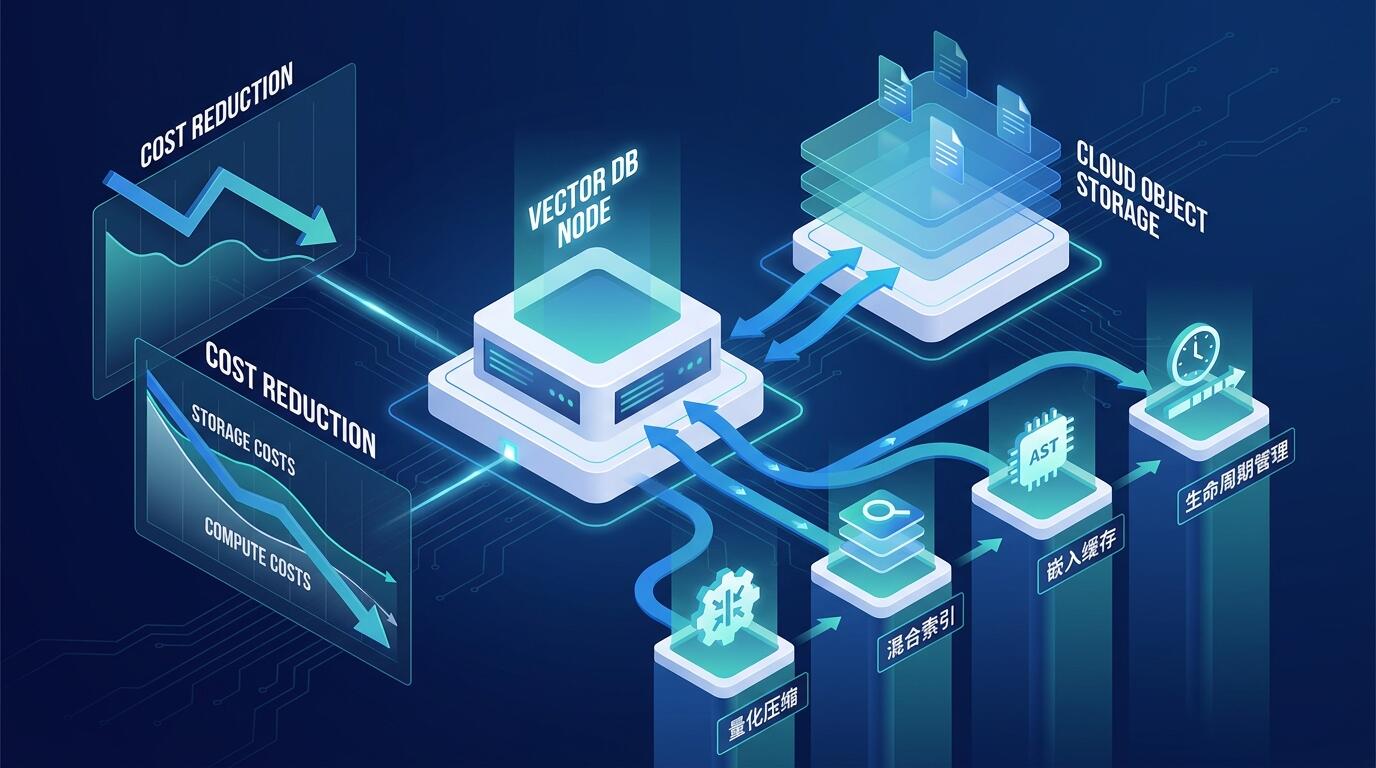
核心结论:向量检索系统的存储成本与向量计算成本高度耦合,单独压缩任何一方都会以隐性代价转嫁给另一方。真正有效的降本路径是联合优化——在索引结构、量化策略、存储分层和查询路由四个维度上协同决策,而非逐项打补丁。本文记录我们在生产系统中本季度亲历的若干联合优化实践,供同样面临此类成本压力的团队参考。
运营一套真实的 AI 产品,向量数据库账单和对象存储账单几乎是同步增长的。我们在这个季度做了一次系统性的成本复盘,发现大多数团队——包括我们自己早期的版本——会把"优化向量成本"和"优化存储成本"当成两件独立的事来处理。这个思维定势本身就是问题所在。
向量索引的精度、存储占用、查询延迟、以及调用 Embedding 模型的频率,这四者之间存在深度的相互约束。忽视这种耦合关系,优化动作往往只是把成本从账单的一行转移到另一行,账单总额并不下降,甚至因为引入额外复杂度而上升。
本文的比较对象是当前主流的几类联合优化策略,评判标准是在不显著损失检索质量的前提下,实际可落地的综合成本削减幅度。
评估维度:我们用哪些标准来衡量联合优化效果
一套有效的联合优化策略,需要在以下五个维度上同时给出答案,任何一个维度的极端牺牲都会让整体方案失效。
综合存储成本:包括向量数据库的索引存储、原始文档的对象存储,以及两者之间的数据同步开销。存储计费模式在不同云服务商之间差异显著,需要按实际账单结构评估,而非只看标称的每 GB 单价。
Embedding 调用频率与成本:每一次重新索引、增量更新或失效重建,都意味着对 Embedding 模型 API 的额外调用。Embedding 成本在规模增长后往往比存储成本增长更快,这是容易被低估的隐性开销。
查询延迟与吞吐量:压缩存储通常会引入解压或量化误差补偿的额外计算,导致 P99 延迟上升。在有延迟 SLA 的生产环境中,这个代价不可忽视。
检索精度保留率:量化、稀疏化或降维等手段都会引入不同程度的精度损失。我们关注的不是理论上的 Recall@10,而是在实际查询分布下的业务相关性变化。
运维复杂度:一个需要高度定制化部署、频繁人工调参或专属硬件的方案,即便账面成本低,也会以工程人力成本的形式重新计入。联合优化方案必须可持续维护。
主要策略方向:各类联合优化手段的核心特征
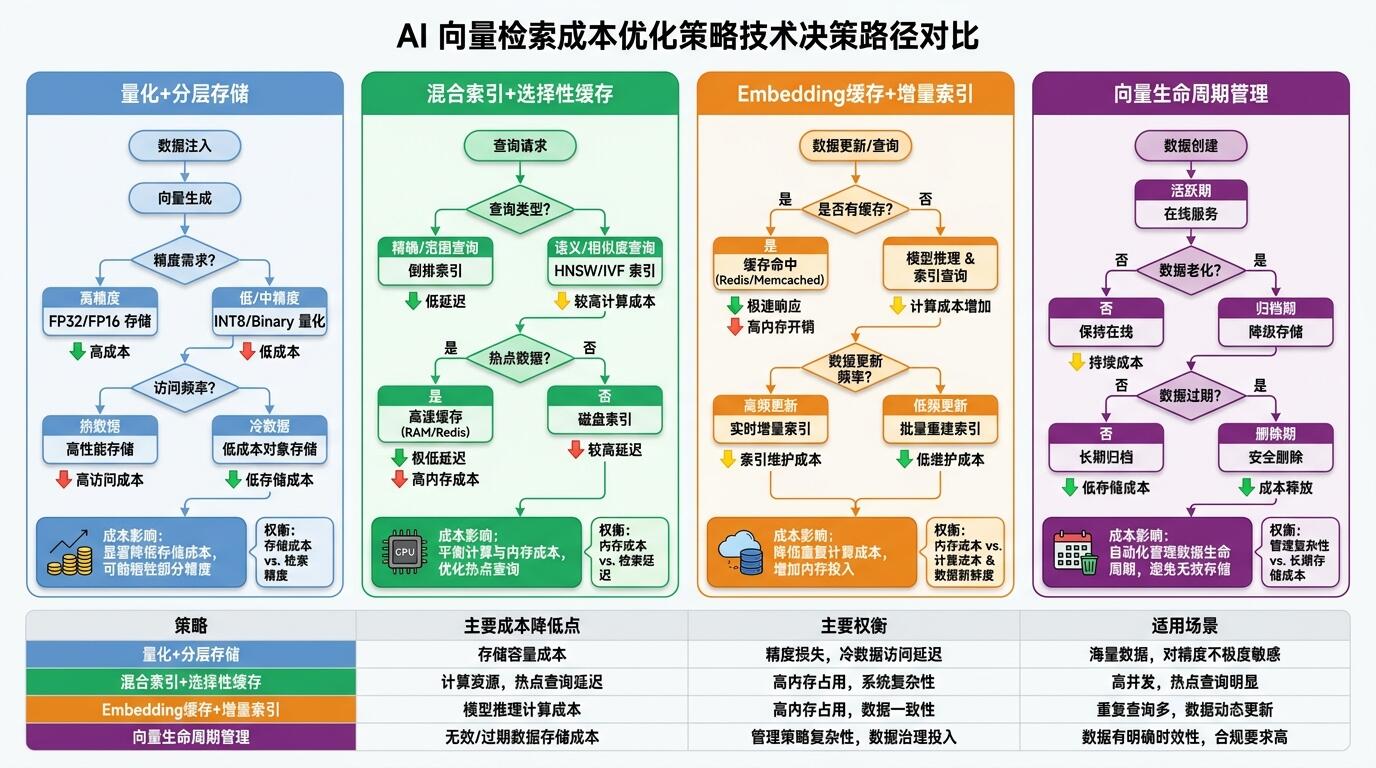
策略一:量化压缩(Quantization)+ 分层存储联动
量化压缩是指将向量的浮点精度从 float32 降低到 int8、二进制(Binary)或乘积量化(PQ)格式,以换取存储空间的大幅收缩。这是当前向量数据库成本优化中使用最广泛的单一手段。
单独使用量化时,常见问题是精度损失超出预期,团队不得不通过增加候选集大小(nprobe 或 ef_search)来补偿,这反而增加了查询计算成本。联合分层存储的做法是:将高精度 float32 向量归档到冷存储(如对象存储的低频访问层),热路径上只保留量化后的压缩版本,当精度敏感查询触发时,再异步回查原始向量做重排序(Reranking)。
这种联动的关键在于准确识别哪些查询真正需要高精度。在我们观察到的团队实践中,大多数生产流量中只有少部分查询属于精度敏感型,将这部分流量单独路由,可以在整体上同时压低存储成本和 Embedding 重计算成本。
策略二:稀疏-稠密混合索引(Hybrid Index)+ 选择性缓存
混合索引是指同时维护稀疏(BM25 或 SPLADE 类)和稠密(Dense Embedding)两套索引,在查询时根据语义特征动态决定调用哪一路或如何融合。
从成本角度来看,稀疏索引的存储和查询成本远低于稠密向量,因为稀疏向量的非零元素占比通常极低。对于以关键词匹配为主的查询,稀疏路径可以完全绕开向量检索,既节省计算又节省带宽。联合选择性缓存的优化是:对高频查询(尤其是近似重复的查询模式)直接从缓存返回结果,彻底规避向量检索的计算成本。
这种策略的难点在于查询路由的准确性。路由决策本身需要计算,如果路由器太重,收益会被抵消。我们在实践中倾向于使用轻量级的规则路由(基于查询长度、停用词占比等特征)作为第一层过滤,而非再训练一个分类模型。
策略三:Embedding 缓存 + 增量索引联动
Embedding 模型调用成本是许多团队在做向量系统成本审计时最容易漏算的一项。文档每次更新、索引重建或数据迁移,都会触发大量的 Embedding API 调用。
联合优化的思路是:在内容哈希层面建立 Embedding 缓存,相同内容(即便来自不同文档、不同时间)只调用一次 Embedding 接口,结果写入持久化缓存。配合增量索引策略(只对变更的内容重新建索引,而非全量重建),可以将 Embedding 调用量压缩至近乎与净新增内容成正比,而非与全量内容成正比。
这个策略看起来简单,但对内容管道的工程要求较高——你需要可靠的内容哈希机制、缓存失效策略,以及确保向量版本与内容版本一致的协调层。我们在构建 AI 简报的智能体检索管道时,就在这个环节踩过坑:缓存命中率估算过于乐观,实际上因为内容格式的细微差异导致大量缓存失效。
策略四:向量索引生命周期管理 + 存储分级
向量数据的访问频率随时间衰减的规律极为明显——新入库的文档查询频率高,数月前的内容往往很少被检索。然而大多数团队对所有历史向量一视同仁,付出相同的存储和索引成本。
生命周期管理策略是指为向量数据设置访问热度跟踪,将低频访问的向量从在线索引中卸载,归档至成本更低的冷存储。被卸载的向量在必要时可以按需重新加载(或按需重新 Embedding),但在常规查询路径上不参与检索。这需要产品层面对"哪些历史内容仍然需要在线检索"有清晰的业务定义,是一个工程与产品联合决策的问题。
在讨论 AI 基础设施的自建与外购框架时,向量生命周期管理是一个典型的"自建更合算"的场景——托管向量数据库服务对数据生命周期的细粒度控制支持普遍不足,而自建方案可以直接对接云存储的分层计费体系。
策略横向对比:四种联合优化路径的关键维度
| 评估维度 | 量化+分层存储 | 混合索引+选择性缓存 | Embedding缓存+增量索引 | 向量生命周期管理 |
|---|---|---|---|---|
| 综合存储成本削减 | 显著 | 中等(稀疏部分显著) | 中等(减少冗余) | 显著(历史数据) |
| Embedding 调用成本削减 | 有限 | 有限 | 显著 | 中等 |
| 查询延迟影响 | 有精度补偿延迟 | 路由决策有轻微开销 | 缓存命中时极低 | 冷数据加载延迟高 |
| 检索精度保留 | 需调参 | 依赖路由准确性 | 与全量相当 | 热数据范围内保留 |
| 运维复杂度 | 中等 | 较高(两套索引) | 中等(缓存管理) | 较高(生命周期策略) |
| 适用数据规模 | 中大型 | 中大型 | 各类规模 | 以历史数据为主 |
四种策略在成本结构上的优势并不相同,因此不存在普遍最优解。量化加分层存储对存储账单的影响最直接;Embedding 缓存对 API 调用成本的压缩最显著;混合索引对兼顾查询质量与成本的场景最实用;生命周期管理对数据体量大、历史内容占比高的系统最有价值。
实际系统中,这四种策略并非互斥。我们见过的最有效的方案,是将 Embedding 缓存作为基础层(几乎所有系统都应该做),在此之上叠加量化压缩,再根据查询分布决定是否引入混合索引路由。生命周期管理则作为中长期的存储治理手段独立运行。
场景匹配:你的系统应该优先选择哪条路径
如果你的系统数据量处于中小规模,Embedding API 是最大的单项成本,优先建立 Embedding 缓存加增量索引机制。这是投入产出比最高的起点,且不会引入检索质量风险。
如果你的查询流量中存在大量可预测的重复查询模式(如知识库问答、FAQ 系统),在 Embedding 缓存之外叠加查询结果缓存,效果往往比优化索引本身更立竿见影。
如果向量存储费用是账单的主要构成,且你已经在使用 float32 全精度索引,量化压缩加分层存储应是下一步。关键是先做精度损失的基准测试,再决定量化等级,而非直接采用最激进的压缩比。
如果你的数据包含大量历史内容,且业务上对历史内容的实时检索需求较低,向量生命周期管理是性价比最高的手段。在评估这条路径时,需要与产品团队对齐"历史数据的检索价值衰减曲线",这是技术决策之外的核心输入。
如果你的查询语义多样,关键词精确匹配和语义相似度检索都有强需求,混合索引值得引入,但要提前评估路由策略的准确率,以及维护两套索引的工程成本。关于在此类决策前如何系统评估 AI 开发工具,可以参考签合同前评估 AI 开发工具的方法论,同样的框架适用于向量基础设施的选型。
联合优化的主要风险是过度复杂化。在我们观察到的实践中,一个中等规模的 AI 产品如果一次性引入三到四种优化策略,往往会因为各组件之间的版本协调问题,在运维上付出远超预期的人力成本。建议的做法是:先做收益最大的单一策略,稳定后再叠加下一层。
ALT: AI产品向量检索系统中量化压缩、混合索引、Embedding缓存与生命周期管理四种联合降本策略的决策路径对比图
常见问题解答
向量压缩(量化)会对检索精度造成多大影响?
量化对精度的影响高度依赖具体数据分布和查询类型。从生产经验来看,int8 量化在大多数通用文本检索场景下对 Recall@10 的影响通常是可接受的,而二进制量化(Binary Quantization)的影响则更明显,需要配合重排序(Reranking)机制来补偿。建议在引入量化前,先用实际查询日志做基准测试,而非依赖公开 benchmark 的精度数据,因为后者往往与业务数据分布不符。
Embedding 缓存的缓存粒度应该如何选择?
缓存粒度的选择取决于内容的变更频率和查询分布的重复度。文档级缓存(以文档哈希为 key)适合内容更新不频繁的场景;段落级或 chunk 级缓存在内容频繁局部更新时命中率更高,但管理复杂度也更高。一个常见的起点是:以 chunk 的内容哈希作为缓存 key,并配合 TTL 机制控制失效,避免过期 Embedding 参与检索。
联合优化策略需要多长时间才能看到账单效果?
对于 Embedding 缓存加增量索引策略,通常在下一个完整的内容更新周期后即可在 API 调用量上看到明显变化。量化压缩和分层存储的效果则更依赖数据体量——数据量越大,账单变化越明显,小规模系统可能需要数周才能看到统计意义上的差异。生命周期管理的效果则是渐进式的,随历史数据体量积累而逐步显现。无论哪种策略,建议在实施前后对同等时间窗口的账单做逐项比对,而非只看总账单数字。
核心总结
- 向量存储成本与 Embedding 调用成本高度耦合,单独优化任何一方都会产生隐性的成本转移,联合优化是正确的思维框架。
- 四种主流策略(量化+分层存储、混合索引+选择性缓存、Embedding 缓存+增量索引、向量生命周期管理)各有其成本杠杆点,需根据你系统的实际成本构成选择优先顺序。
- Embedding 缓存加增量索引是投入产出比最高的起点,适合几乎所有规模的 AI 产品,应作为第一步实施。
- 量化压缩必须配合精度基准测试,激进压缩带来的检索质量下降往往会以增加 nprobe 或引入 Reranking 的方式把计算成本推回来。
- 联合优化的最大风险是过度复杂化——建议按收益排序逐层叠加,不要一次性引入所有策略。
- 向量生命周期管理是长期存储治理的核心手段,需要技术与产品团队联合定义"历史数据的在线检索价值",这是纯工程之外的输入。
关于如何在不降低质量的前提下快速推进这类基础设施优化,可以参考在不牺牲产品质量的前提下快速交付的工程实践——那篇文章里对取舍决策的框架同样适用于存储优化的优先级排序。
如果你正在构建 AI 产品,不想在信息噪音中浪费时间,Darius 简报正是为你而写——每期精选 AI 领域关键进展,附上来自真实生产系统的第一手解读。立即访问 Darius,订阅由工程总监亲笔撰写的双语 AI 简报,让每一条信息都真正服务于你的构建决策。
参考资料与延伸阅读
- IEEE. "IEEE Standards on Information Technology and Neural Network Architectures".
https://www.ieee.org/ - ACM. "ACM Digital Library — Research on Vector Search, Approximate Nearest Neighbor, and Information Retrieval Systems".
https://www.acm.org/ - arXiv.click. "Curated Research Intelligence — Vector Quantization and Retrieval Augmented Generation".
https://arxiv.click/paper/10780
注:技术标准与研究文献持续更新,建议查阅各机构官方渠道获取最新版本,并结合你的实际生产环境做本地化评估。