为LLM功能设计干净可用API的方法
ALT: Designing clean and usable APIs for LLM functions with best practices in AI architecture
为什么LLM功能API的设计质量,直接决定产品能否真正落地
你大概遇到过这样的场景:团队花了几周时间把大语言模型接入产品,function calling跑通了,演示效果不错,但一上生产环境就开始出问题——模型不按预期调用工具、参数格式五花八门、错误处理逻辑散落在各处,维护起来举步维艰。这不是模型能力的问题,而是API设计的问题。
为LLM功能设计干净可用的API,核心命题是:让模型能够可靠地理解并调用你的接口,同时让工程团队能够以合理的成本维护这套接口。本文从实际工程经验出发,对比几种常见的API设计方案,帮你在架构决策早期做出更好的选择。
比较的维度包括:接口可读性与自描述能力、错误处理机制的完备程度、调用链可观测性、版本演进的容易程度,以及在生产环境下的真实可靠性。
衡量LLM功能API好坏的核心标准
判断一套面向LLM功能的API设计是否"干净可用",需要超越传统RESTful设计的评判框架。以下六个维度是我们在实际项目中反复验证过的关键判据。
自描述能力(Self-descriptiveness):LLM通过函数的名称、参数描述和schema来理解"何时调用、如何调用"。如果一个函数的描述模糊,模型就会在不该调用的时候调用它,或者传入错误格式的参数。自描述能力差的API,直接导致function calling的准确率下降。
参数schema的严格程度:宽松的参数定义(比如允许任意字符串)看起来灵活,实则给模型留下了太多猜测空间,也让服务端验证变得复杂。严格的schema——明确的类型、枚举值、必填项——是减少模型幻觉调用的第一道防线。
错误处理与反馈机制:当模型调用失败时,返回给模型的错误信息质量至关重要。一个设计良好的API会返回结构化的错误描述,让模型能够在下一轮重试时做出修正,而不是陷入无限循环或沉默失败。
调用链可观测性:在多轮对话或agent链路中,一次完整的用户请求可能触发多次工具调用。没有完善日志和追踪设计的API,在排查问题时几乎是黑盒。可观测性直接影响团队的维护效率和系统可靠性。
版本演进的兼容性:业务需求会变,工具的参数和行为会迭代。一套设计良好的API需要能够平滑演进——既不破坏已有的模型prompt,也不让旧版本的调用突然失效。
开发与维护成本:最终,所有设计决策都要落到团队能否以合理投入长期维护这套接口。过于复杂的抽象层会让新成员上手困难,过于简陋的设计则会在规模扩大后积累大量技术债。
三种主流的LLM功能API设计方案
方案A:原生JSON Schema + OpenAI Function Calling规范
原生JSON Schema方案是目前业界最广泛使用的基础方式。开发者直接按照OpenAI function calling规范(现已被多数主流模型提供商采纳)定义工具的名称、描述和参数schema,模型根据这份描述决定是否调用以及如何填充参数。
这种方式的优点是直接、透明,没有额外的抽象层。你对模型看到的工具描述拥有完全的控制权。缺点是,随着工具数量增多,手动维护JSON Schema变得繁琐,且容易出现描述不一致的情况。
方案B:SDK封装层(如LangChain Tools、LlamaIndex Tools等)
以LangChain为代表的框架提供了更高层的Tool抽象,开发者用Python装饰器或类定义工具,框架自动生成对应的schema并处理调用路由。这降低了初始开发门槛,也提供了内置的错误处理和重试机制。
然而,框架层的抽象往往带来控制权的损失。当模型行为出现异常时,定位问题需要穿透多层封装。此外,框架的升级路径有时与项目的稳定性需求相冲突。
方案C:自定义工具注册表 + 结构化描述规范
这种方案介于前两者之间:团队自行设计一套工具注册机制,统一管理工具的schema生成、版本标记、权限控制和调用日志。实现成本比原生方案高,但比依赖第三方框架更灵活、更可控。
在我们参与的多个中大型AI产品项目中,当工具数量超过一定规模、需要细粒度的权限管理和完整审计链路时,这种方案往往是更合理的选择。AI系统架构模式的选型决策,与工具层的API设计方案选择紧密相关——在做这一决策时,值得同步考虑整体架构的演进路径。
三方案横向对比:生产环境下的真实表现
| 评估维度 | 方案A:原生JSON Schema | 方案B:SDK封装层 | 方案C:自定义注册表 |
|---|---|---|---|
| 自描述能力 | 高(完全可控) | 中(框架生成,可定制) | 高(自定义模板) |
| 参数schema严格程度 | 视开发者纪律而定 | 框架提供基础验证 | 可强制执行团队规范 |
| 错误处理完备性 | 需自行实现 | 内置部分机制 | 完全自定义 |
| 调用链可观测性 | 需自行接入 | 框架提供基础日志 | 可深度集成监控系统 |
| 版本演进兼容性 | 手动管理,风险较高 | 依赖框架版本策略 | 可设计版本控制机制 |
| 初始开发成本 | 低 | 最低 | 高 |
| 长期维护成本 | 中(规模扩大后上升) | 中高(框架锁定风险) | 低(规范统一后) |
| 适合规模 | 小型项目,少量工具 | 快速原型,中小型项目 | 中大型产品,多团队协作 |
这张表格揭示了一个反直觉的规律:初始开发成本最低的方案(SDK封装层),在产品进入规模化阶段后往往带来最高的维护摩擦。我们在与客户合作时一再观察到,很多团队在原型阶段用LangChain快速跑通了概念,但在尝试将其推进到生产环境时遭遇了框架升级破坏性变更、日志难以追踪、自定义行为难以注入等问题。
方案A(原生JSON Schema)在工具数量较少时是理想选择,因为它透明、可预期,且与模型提供商的规范保持一致。IBM在其关于LLM API的技术分析中也指出,清晰的函数描述和严格的schema定义是提升模型调用准确率的关键因素。
方案C的价值在规模化后才完全显现。当一个团队需要同时维护数十个工具、跨多个业务模块、并且需要对每一次工具调用保留完整审计记录时,统一的注册表机制带来的收益远超初始投入。
选择哪种方案?基于你的实际场景做决策
如果你正在构建一个快速验证想法的原型,或者整个产品的工具函数不超过五到十个,方案A是正确选择。把精力放在描述质量上,确保每个函数的description字段写得清晰、具体,枚举值用enum约束,必填参数明确标注。
如果你的团队没有专门的AI架构师,且需要在几周内交付一个可演示的产品,方案B能够帮你节省大量初始配置时间。但要在项目早期就建立退出预案——记录哪些逻辑依赖了框架的特定行为,方便未来迁移。
如果你在构建一个计划长期运营的AI产品,工具函数会持续增长,或者涉及多团队协作,方案C是值得提前投入的架构决策。根据meta-intelligence.tech对LLM Function Calling工具链设计的分析,工具注册表的设计质量直接影响整个agent系统的可维护性和扩展性。
方案C的核心设计要素包括:统一的schema模板(确保所有工具描述风格一致)、工具版本标签(允许在不破坏现有prompt的情况下迭代工具行为)、调用日志中间件(每次工具调用自动记录输入输出和耗时),以及权限矩阵(控制哪些工具可在哪些上下文中被调用)。
对于涉及复杂数据管道的AI应用,生产环境AI应用的数据管道架构决策同样是不可忽视的配套工程问题——工具API的设计不能孤立于整体数据流架构之外。
方案A与方案C的核心权衡总结:
- 方案A优势:透明度高,与模型规范完全对齐,调试直接,无框架依赖
- 方案A劣势:规模化后维护成本上升,需要团队自律维持描述质量
- 方案C优势:规范统一,版本可控,可观测性强,长期维护成本低
- 方案C劣势:初始投入高,需要有经验的工程师设计注册机制
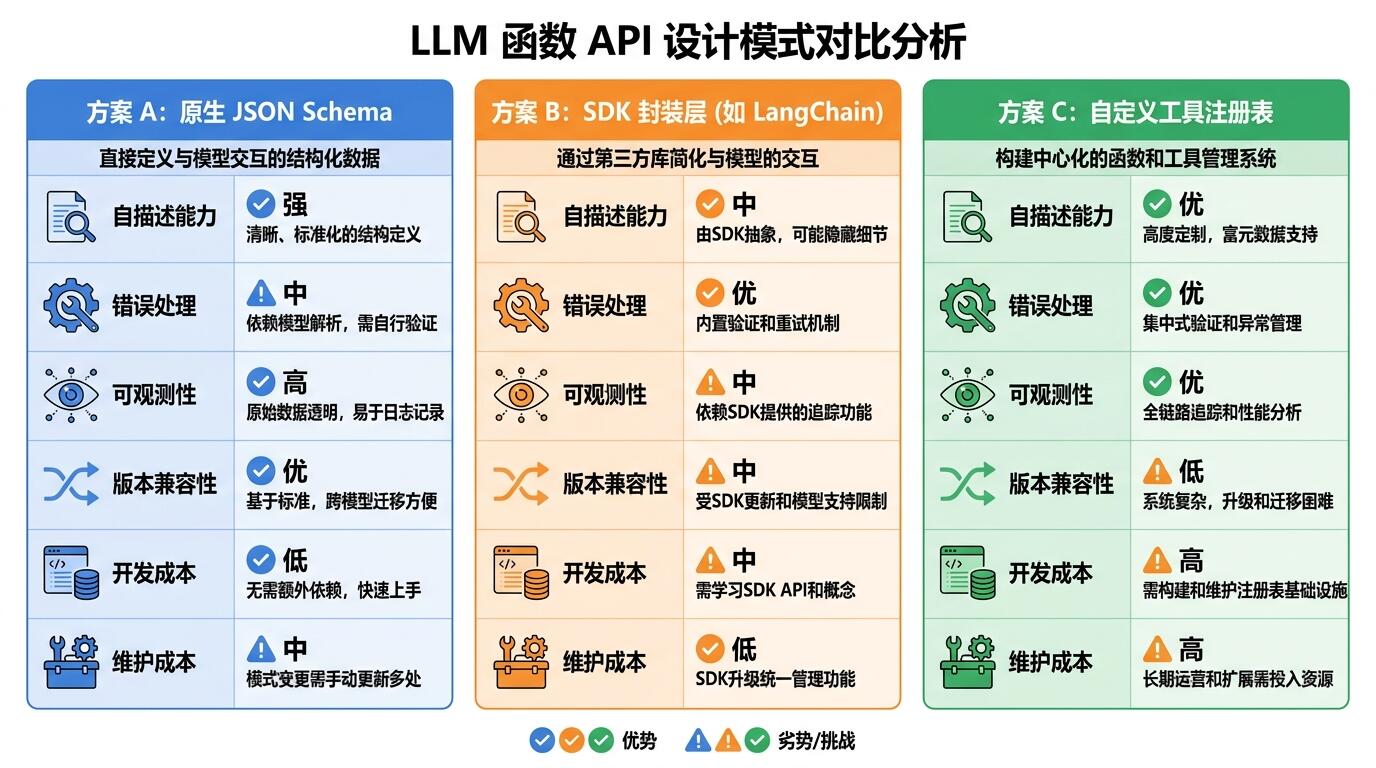
ALT: Comparison table of LLM function API design patterns showing trade-offs between native JSON Schema, SDK wrappers, and custom tool registries for AI product development
常见问题解答
Q1:如何让模型更准确地知道何时调用哪个工具函数?
提升工具调用准确率最有效的手段是改善函数描述的质量,而不是调整模型参数。每个函数的description字段应该明确说明"什么情况下应该调用这个函数",而不仅仅是"这个函数做什么"。同时,工具名称应该用动词短语命名(如search_product_catalog而非catalog),参数描述应包含格式示例。经过这类优化后,工具调用的准确率通常会有显著提升。
Q2:在生产环境中,原生Function Calling与自建工具注册表哪个更可靠?
两者的可靠性差异主要体现在规模和团队规模上。对于工具函数少于十五个、由单一团队维护的项目,原生JSON Schema方案完全可靠。一旦工具数量增多、涉及多团队、或需要细粒度的调用审计,自建注册表的可靠性优势就会显现——因为它强制统一了描述规范,消除了人工维护多份schema时容易出现的不一致问题,并提供了完整的调用链追踪能力。
Q3:从原型阶段的SDK封装方案迁移到自定义方案,需要多大的工程投入?
迁移成本取决于项目对框架特定API的耦合程度。如果团队在原型阶段已经将工具逻辑(业务代码)与框架调用层(工具注册、schema生成)清晰分离,迁移通常只需要重写注册层,核心业务逻辑不受影响。反之,如果工具实现与框架深度耦合,迁移工作量会大幅增加。在项目早期保持关注点分离(separation of concerns)是控制未来迁移成本的关键。
最终思考
核心要点
- LLM功能API的质量不仅影响开发体验,直接决定模型在生产环境中的调用准确率和系统可靠性
- 函数描述(description)的写作质量是被最多团队低估、却对模型行为影响最大的单一因素
- 三种方案各有适用场景:原生JSON Schema适合小型项目,SDK封装层适合快速原型,自定义注册表适合规模化产品
- 初始开发成本最低的方案往往在规模化阶段积累最多的技术债,架构决策需要考虑长期演进路径
- 可观测性不是可选项——每次工具调用的完整日志是快速排查生产问题的前提条件
在我们参与的项目中,那些在早期就投入精力设计干净工具API的团队,在产品迭代阶段往往能够以更快的速度响应需求变化,因为他们不需要每次都去修复破损的调用链。如果你正在为一个AI产品做架构规划,工具层的API设计值得作为一级架构决策来对待,而不是留到后期去重构。
如需进一步了解如何将AI系统的工具层与整体架构结合设计,可以参考本季度CTO必须评估的AI系统架构模式中关于模块化AI系统设计的讨论。
如果你正在规划一个AI驱动产品的架构,或者正在为LLM功能层的工程质量寻求更系统的方法,欢迎访问 Darius 的官网,探索更多从架构设计到实际落地的技术洞察与项目案例。
参考资料
- IBM Think Insights. "LLM API:弥合差距的技巧".
https://www.ibm.com/cn-zh/think/insights/llm-apis - Meta Intelligence. "LLM Function Calling 完全指南:Tools API 與工具鏈設計".
https://www.meta-intelligence.tech/insight-function-calling - IEEE. IEEE Standards for AI and Machine Learning Systems.
https://www.ieee.org/
注:相关技术规范和最佳实践持续演进,请参阅各官方渠道的最新文档或咨询专业技术顾问。