面向生产环境的AI应用数据管道架构决策
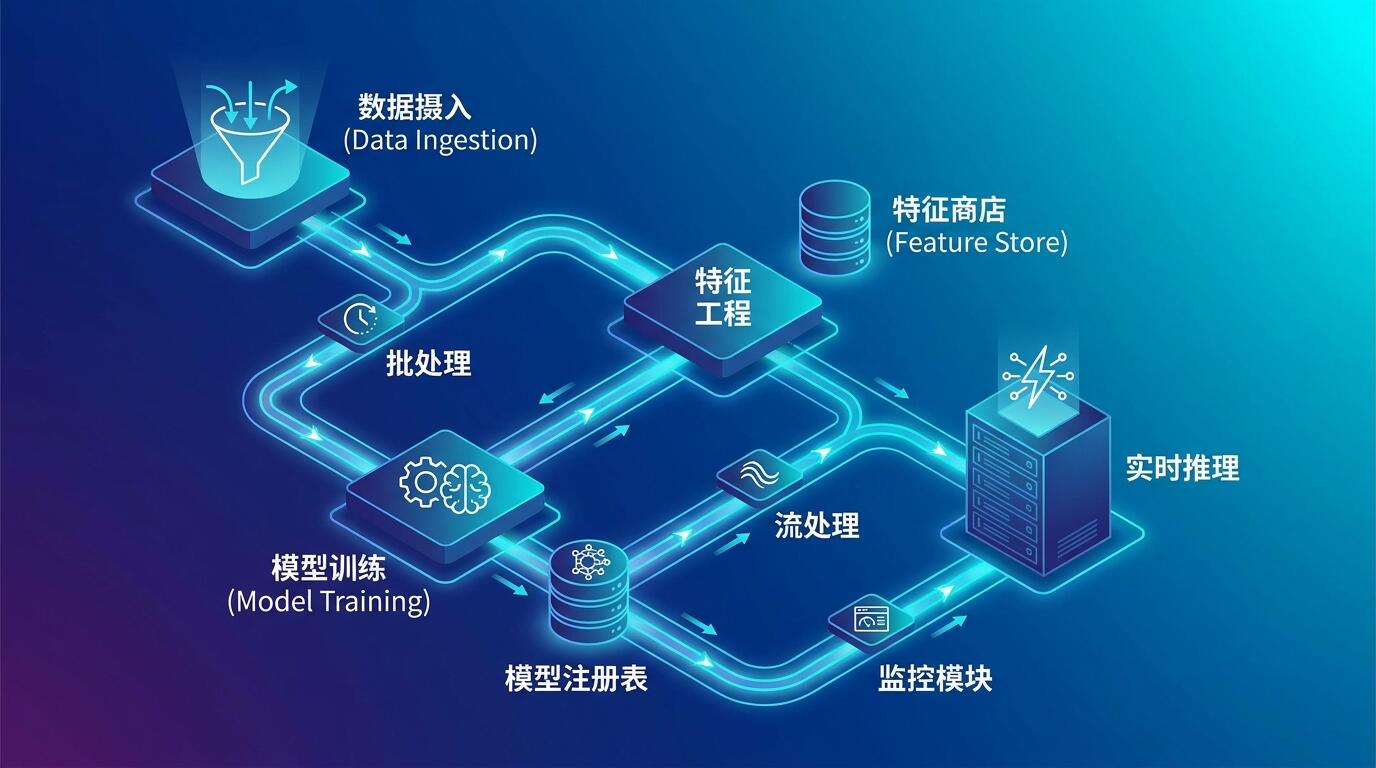
ALT: Production AI application data pipeline architecture decision guide for engineering leaders and CTOs
生产环境中AI数据管道的架构决策,为什么大多数团队在这里翻车
一个常见的场景:团队花了几个月时间打磨模型,离线指标漂亮,演示时掌声不断,然而一旦部署到生产环境,数据管道就开始出各种问题——延迟飙升、数据漂移无人察觉、批处理和实时处理逻辑分裂成两套难以维护的代码。根源往往不在模型本身,而在于数据管道的架构决策从一开始就没有认真做。
在实际项目交付的经验中,我们反复观察到同一个规律:AI应用在实验阶段和生产阶段之间存在一道隐形的"工程鸿沟",而这道鸿沟的主要成因,正是数据管道的架构选型没有面向生产环境的实际约束来设计。本文梳理出面向生产环境的AI应用数据管道架构决策中最关键的七个维度,帮助技术决策者在早期就建立系统性判断,而不是等到上线后再救火。
以下七个决策点的选取,基于从零到上线的完整交付视角——不只是架构设计图好看,而是要在真实负载、真实团队、真实预算下可以运转。每个维度都给出适用场景和需要警惕的陷阱,方便对号入座。
七个关键架构决策维度
批处理管道与实时流处理管道的选型
批处理管道是指按时间窗口周期性地处理数据,而实时流处理管道则对数据流进行持续的低延迟处理。两者的核心差异不是技术复杂度,而是业务延迟容忍度。
很多团队在早期低估了这个选型的长期成本。批处理架构(如基于Apache Spark或定时任务的ETL)在初期研发效率高,运维成本低,调试链路清晰;实时流处理(如Apache Kafka + Flink或Spark Streaming)的吞吐和延迟能力更强,但工程复杂度显著上升,对团队的流处理编程能力要求也更高。
过度设计是我们在客户项目中见到的高频失误。一个T+1小时刷新就够用的推荐系统,没有必要用毫秒级流处理架构来支撑,带来的是维护成本翻倍、链路排查难度倍增。
Best for: 明确依赖低延迟信号的AI场景,例如实时风控、在线推荐、智能客服意图识别等;批处理则适用于周期性模型再训练、离线特征工程、报表驱动型AI产品。
Watch out: Lambda架构(同时维护批处理和流处理两条链路)虽然功能齐全,但会导致逻辑重复和一致性问题,除非团队有足够的工程资源,否则应优先考虑Kappa架构(纯流处理)或仅批处理方案。
特征存储(Feature Store)的引入时机
特征存储是一种为机器学习模型统一管理、存储和服务特征数据的基础设施组件,解决训练时特征与推理时特征不一致(training-serving skew)这一核心问题。
在我们参与的多个AI项目交付过程中,训练-服务偏差是导致模型上线后效果下降的首要技术原因,远比模型算法本身的问题更常见。特征存储通过统一特征定义、版本管理和在线/离线双写,从架构层面消除这一风险。
值得注意的是,引入特征存储本身有工程成本,Feast、Tecton、Hopsworks等开源和商业方案在功能完整性和运维负担上各有权衡。过早引入可能拖慢早期迭代速度,而过晚引入则可能导致特征代码散落各处、难以治理。
Best for: 团队拥有多个AI模型、特征被多个下游模型复用,或者训练与推理环境存在明显隔离的中型以上AI工程团队。
Watch out: 对于单模型、单团队的MVP阶段,轻量级特征管理(如数据库+版本表)往往更务实,过度投资特征存储基础设施会显著拖慢交付节奏。
数据版本控制与谱系追踪(Data Lineage)
数据版本控制是指对训练数据集、特征集和标注数据的变更进行系统性的记录和回滚管理;数据谱系追踪则是对数据从源头到最终模型输出的完整流转路径进行可审计的记录。
根据 IEEE 软件工程相关标准所定义的可重现性原则,一个可在生产中信任的AI系统,必须能够精确地重现任意历史时间点的训练数据状态。缺乏数据版本控制,意味着模型调试、合规审计和故障回溯都将成为不可能完成的任务。
DVC(Data Version Control)等工具提供了Git兼容的数据版本管理能力;MLflow、Neptune等MLOps平台则将数据谱系与实验追踪整合在一起。这些工具的引入成本相对可控,但需要团队在工作流层面建立纪律。
Best for: 需要满足监管合规要求的行业(金融、医疗),以及对模型可解释性和可审计性有明确要求的企业级AI应用。
Watch out: 数据谱系系统如果只记录元数据而不落实到实际的数据变更工作流中,会沦为"存档式合规"而非真正的质量保障工具。
数据质量监控与异常检测的架构嵌入
数据质量监控是指在数据管道的关键节点自动检测数据的完整性、分布合理性和业务规则合规性,并在异常时触发告警或熔断。生产环境中的AI应用必须将质量检测视为管道的一等公民,而不是事后补救。
数据漂移(data drift)和概念漂移(concept drift)是AI生产系统失效的两大隐性杀手。数据漂移指输入特征分布随时间偏离训练时的分布,概念漂移指目标变量与输入特征之间的关系发生了变化。两者在生产中都会悄无声息地降低模型性能,直到业务指标出现肉眼可见的恶化。
Great Expectations 等开源框架可以在数据进入管道时自动进行断言式质量验证;Evidently、WhyLabs 等工具则专注于模型服务阶段的数据分布监控。
Best for: 数据来源复杂、多方接入的AI系统,以及依赖实时数据进行决策的高风险业务场景(如反欺诈、信用评分)。
Watch out: 质量检查的粒度设计需要权衡——过于细密的断言会导致误报率高、管道频繁中断;过于宽松则形同虚设。阈值设定应基于业务容忍度,而非技术默认值。
在线推理与批量推理的服务架构选型
在线推理(Online Inference)是指为单条或少量请求实时返回模型预测结果,延迟通常要求在数百毫秒以内;批量推理(Batch Inference)则是对大规模数据集进行异步批量预测,通常接受分钟到小时级的延迟。
这个选型直接决定了数据管道的下游架构:在线推理需要低延迟的特征服务层和高可用的模型服务节点(如基于Kubernetes的模型部署),批量推理则更多依赖高吞吐的分布式计算框架。混合使用两种模式的系统在设计上需要特别注意特征一致性,避免在线和离线路径产生语义差异。
从成本角度看,在线推理的单次预测成本通常高于批量推理,尤其是在使用大型语言模型(LLM)时,推理计算费用可以成为系统运营成本的主要构成项。
Best for: 在线推理适用于用户交互型AI产品(对话、实时推荐、个性化内容生成);批量推理适用于周期性报告生成、大批量数据标注、离线风险评分等场景。
Watch out: 很多初创团队在原型阶段用批量推理模拟在线能力(通过轮询),这在早期可以接受,但应在系统设计文档中明确标注为技术债,并制定迁移计划。
数据管道的编排与依赖管理
数据管道编排是指对一系列有序任务(数据抽取、转换、特征工程、模型训练触发等)的调度、依赖管理和失败重试进行系统性控制的机制。Apache Airflow 是目前生产环境中使用最广泛的开源管道编排工具,Prefect 和 Dagster 则在开发体验和可观测性方面进行了改进。
在工程交付实践中,我们发现编排层的设计是最容易被低估的部分。团队往往在早期用简单的cron任务或脚本串联管道步骤,随着业务复杂度上升,依赖关系变成了难以调试的"意大利面条式"脚本,最终导致管道可靠性极低。
编排工具的选型应综合考虑:团队的Python熟练程度(Airflow的学习曲线非平坦)、对动态DAG的需求程度、以及对可观测性仪表盘的要求。
Best for: 任何超过三个有序步骤的生产数据管道,均应引入编排工具。这不是可选项,而是工程纪律的基本要求。
Watch out: Airflow的调度器在高并发任务场景下存在性能瓶颈,且其有向无环图(DAG)定义方式对于习惯声明式配置的团队有一定门槛,务必在引入前评估团队的实际运维能力。
数据安全、隐私合规与访问控制的架构集成
数据安全和隐私合规在AI数据管道中的架构集成,是指将数据加密、访问控制、脱敏处理和合规审计机制嵌入管道的各个环节,而不是在管道建成后作为补丁叠加。
随着各主要经济体对数据处理的监管日趋严格,欧盟的通用数据保护条例(GDPR)等法规对AI系统处理个人数据的要求已具有约束性的法律效力。在架构层面,这意味着需要在数据进入管道时就进行分类打标,对敏感字段实施字段级加密或动态脱敏,并对所有数据访问操作保留可审计日志。
从成本角度看,事后合规改造的工程成本通常是架构前置集成的数倍。将安全和合规需求纳入初始架构决策,是降低长期技术债和法律风险最直接有效的投资。
Best for: 处理用户个人数据、医疗数据或金融交易数据的AI应用,以及计划进入欧洲或其他强监管市场的产品。
Watch out: 过度的数据脱敏可能导致特征信息损失,降低模型性能。脱敏策略需要在隐私保护强度和模型可用性之间进行权衡,建议引入差分隐私(Differential Privacy)等技术手段进行精细化控制。
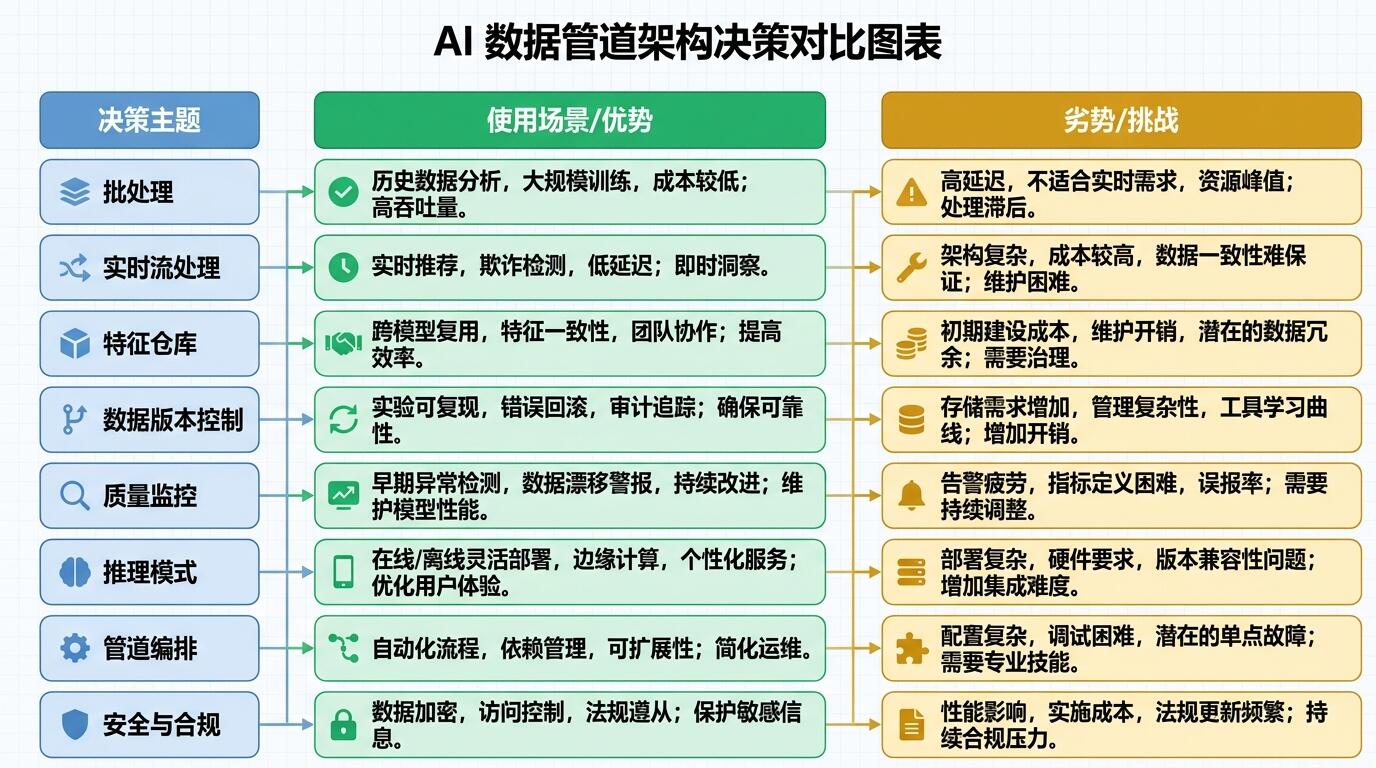
ALT: AI data pipeline architecture comparison table showing batch processing, real-time streaming, feature store, and monitoring decisions for production deployment
七个决策维度快速对比
| 决策维度 | 最适用场景 | 核心优势 | 主要局限 |
|---|---|---|---|
| 批处理管道 | 周期性训练、离线特征工程 | 开发效率高、成本可控、调试简单 | 无法支持低延迟实时场景 |
| 实时流处理管道 | 风控、在线推荐、实时个性化 | 低延迟、高吞吐、事件驱动 | 工程复杂度高、运维成本大 |
| 特征存储 | 多模型复用特征、大型AI工程团队 | 消除训练-服务偏差、特征复用 | 引入成本高、MVP阶段易过度设计 |
| 数据版本控制与谱系追踪 | 合规场景、需要可审计性的AI系统 | 可重现性强、支持回溯与审计 | 需要团队工作流纪律配合 |
| 数据质量监控 | 多源数据接入、高风险业务决策 | 主动防御数据漂移、提升可靠性 | 误报率与漏报率难以同时优化 |
| 在线推理 vs 批量推理 | 用户交互型 vs 离线批量场景 | 分别优化延迟与吞吐 | 混合架构需解决特征一致性问题 |
| 管道编排 | 任何超过三步的生产管道 | 可观测性强、依赖关系清晰 | 引入额外运维复杂度和学习成本 |
| 安全与合规集成 | 处理敏感数据的AI产品 | 降低法律风险、减少技术债 | 脱敏可能影响特征质量 |
如何根据实际情况做出正确选择
面向生产环境的AI数据管道架构决策,没有放之四海而皆准的标准答案。选择哪种组合,取决于团队规模、业务延迟要求、数据敏感程度和预算约束四个核心变量。
如果你是一个小型初创团队、正在验证产品假设,最务实的建议是:批处理优先,用托管服务(如云平台的托管Kafka、托管Airflow)降低运维负担,暂时用轻量级数据版本管理替代完整的特征存储。这个阶段的核心目标是快速交付,而不是架构完美。
如果你的团队已经有多个模型上线、数据来源超过三个、并且出现了训练-服务偏差的迹象,那么引入特征存储和系统性数据质量监控的时机已经成熟。此时的投入能够显著降低未来的维护成本,是合理的架构投资。
如果业务场景涉及实时决策(风控、智能客服、动态定价),在架构层面就需要为流处理管道和在线推理服务做好预算。这类系统的运营成本高于批处理架构,但业务价值通常也高得多,ROI是可以量化的。
一个常见误解值得特别点明:许多团队认为"先跑通再优化"是合理的工程策略,但数据管道架构一旦在生产中运转,重构成本往往远超预期。数据模式、特征定义和管道接口的变更会牵一发而动全身。正确的做法是在MVP阶段就明确记录架构决策(Architecture Decision Records,ADR),为未来演进保留清晰的脉络,而不是在技术债积累到无法偿还时才开始补文档。
常见问题
Q1:如何判断现有的数据管道是否已经影响了AI模型的生产表现?
判断数据管道对模型生产表现产生影响,最直接的信号包括:线上预测结果分布与离线评估指标出现显著偏差、特征计算结果在相同输入下不一致、以及模型性能随时间出现无法用业务变化解释的缓慢下滑。建议在关键管道节点增加数据统计快照,并与训练集的基线分布进行持续对比,这是发现数据漂移的最低成本方法。
Q2:实时流处理架构是否适合所有AI应用场景?
实时流处理架构并不适合所有AI应用。对于预测频率低、业务延迟容忍度高(如每日更新的推荐结果、周期性风险评分)的场景,批处理架构在成本和维护复杂度上有明显优势。流处理架构的引入应以明确的业务延迟需求为前提,而不是以"技术先进性"为驱动。盲目追求实时处理会导致工程资源的严重浪费,并引入不必要的系统脆弱性。
Q3:为AI数据管道引入完整MLOps体系的时间和成本投入大概是什么量级?
MLOps体系的建设成本高度依赖于团队规模、现有基础设施和工具选型。使用开源工具(Airflow、MLflow、Great Expectations的组合)构建一套功能基本完整的管道监控和版本管理体系,通常需要具备相关经验的工程师投入数周到数月不等。使用云平台托管的MLOps服务(如各主流云厂商提供的ML平台)可以显著缩短建设周期,但会引入持续的运营成本。建议在项目启动前做好TCO(总拥有成本)分析,将长期运营成本纳入选型考量。
核心要点
- 管道架构决策应前置:数据管道的架构选型应在AI系统设计阶段就完成,而不是等到模型训练完成后才补建,因为后期重构成本远高于前期设计投入。
- 业务延迟需求决定技术选型:批处理与流处理、在线推理与批量推理的选择,应以业务对延迟的实际容忍度为核心依据,而非以技术时髦程度为导向。
- 数据质量是生产AI系统的生命线:训练-服务偏差和数据漂移是AI生产系统最常见的失效模式,数据质量监控应作为管道的一等公民从架构层面嵌入,而非事后补救。
- 安全与合规集成越早越便宜:将数据安全和隐私合规需求纳入初始架构设计,是降低长期法律风险和技术债的最经济选择。
- 记录架构决策,为演进留余地:通过Architecture Decision Records(ADR)记录关键选型的背景和权衡,是团队在快速迭代中保持架构清晰度的低成本有效手段。
下一步行动建议:对照本文的七个维度,对现有或规划中的AI数据管道做一次快速的架构审查,找出最薄弱的环节,从那里开始投入,而不是试图一次性重构整个体系。
如果你正在推进一个AI产品从想法到生产上线的完整旅程,数据管道的架构决策只是其中需要系统性应对的诸多工程挑战之一。Darius 的技术洞察与项目案例涵盖了AI架构设计、系统工程策略到全栈交付的完整视角——如果你是正在寻找可落地技术方向的创始人、CTO或工程负责人,欢迎前往探索。
参考资料
- IEEE. "IEEE Standards for Software and Systems Engineering".
https://www.ieee.org/ - Apache Software Foundation. "Apache Airflow, Apache Kafka, Apache Spark — Open Source Data Engineering Projects".
https://www.apache.org/ - European Parliament and Council. "General Data Protection Regulation (GDPR)".
https://www.europa.eu/
注:相关标准和法规可能持续更新,建议参阅各官方机构发布的最新版本或咨询专业顾问。