不拖慢交付节奏的AI治理框架落地方法
ALT: Engineering team implementing AI governance framework without slowing down product delivery cadence
AI治理框架的落地困境:为何"规范"总是拖累"交付"
核心结论:不拖慢交付节奏的AI治理框架,并非对开发流程施加额外约束,而是将治理检查点嵌入现有的CI/CD管线、代码审查和迭代周期中,以"轻量检查、持续覆盖"替代"集中评审、阶段性阻断"。治理的本质是风险管理,而风险管理做得好,恰恰是交付提速的前提条件,而非对立面。
在实际与客户合作的过程中,我们反复观察到同一个模式:团队在AI系统进入生产环境之前,往往对治理的必要性深信不疑;但一旦治理流程真正落地,它几乎无一例外地演变成一道审批门槛——需要额外的委员会、额外的文档、额外的等待周期。结果是,工程师开始绕过流程,或者治理形同虚设。
这个困境的根源在于:大多数AI治理框架是由合规团队设计的,而不是由工程团队设计的。本文要探讨的,正是如何从工程视角重新设计治理落地路径,让它真正融入交付节奏,而不是与交付节奏对抗。
本文适用于哪些场景
适用场景:
- 团队规模在5人以上、已有或计划部署AI功能到生产环境的工程组织
- 正在经历合规压力(监管、客户审计、内部审查)但不愿牺牲迭代速度的技术领导者
- 使用敏捷或DevOps交付模式、希望将AI风险管控内嵌到现有工作流的CTO或架构师
- 处于快速扩张阶段、需要在治理缺失和治理过重之间找到平衡点的初创公司
不适用的场景:
- 纯研究型团队,尚未涉及生产部署,治理压力极低,此时引入完整框架会得不偿失
- 监管环境极端严苛(如医疗器械AI、金融核心决策系统)的场景,这类场景需要专门的合规架构,本文的轻量化方法仅能作为起点参考,不能替代法规要求的正式评审
为何AI治理必须在现在落地
AI治理(AI Governance)是指对AI系统在设计、开发、部署和运营全生命周期中的风险识别、责任归属、透明度保障和合规管控所建立的一套机制。它回答的核心问题是:当AI系统出了问题,谁负责、怎么发现、如何修复。
当前,这个问题的紧迫性正在快速上升。全球范围内,欧盟《人工智能法案》(EU AI Act)已进入分阶段实施周期,将AI系统按风险等级分类监管;美国国家标准与技术研究院(NIST)发布的AI风险管理框架(AI RMF)也已成为企业建立内部治理参考的重要依据。根据项目管理权威机构APMG International的观点,AI项目治理不仅是合规要求,更是决定项目成败的核心能力——它帮助组织识别风险、明确责任、确保资源在正确的优先级上对齐。
然而,在我们接触的大量工程团队中,治理落地的最大阻力从来不是"不知道为什么要做",而是"不知道怎么做才不会把节奏拖死"。一个典型的反模式是:在发布前设立一个"AI安全评审委员会",要求所有AI功能通过集中评审才能上线。这个机制在纸面上很完善,在实践中却制造了批量积压——功能等评审、评审等委员会日程、委员会等文档齐备。
真正可持续的治理落地,需要回到工程的第一性原理:企业AI治理的长期成功,依赖于将治理能力编码进工具链和流程,而不是依赖人工审批节点。
落地方法:如何让治理不拖慢交付
三步快速启动
第一步:绘制你的AI风险地图(Risk Mapping)
在动手建立任何治理机制之前,先花一到两天时间,把团队当前所有的AI功能和在途需求列出来,按照"决策自动化程度"和"影响范围"两个维度做一次粗粒度分类。高自动化、高影响范围的功能(如自动审批、内容推荐、风险评分)需要重点治理;低自动化、低影响范围的(如内部搜索、辅助写作)可以采用轻量检查。这一步的目的不是精确评分,而是让团队对"哪里最需要治理资源"形成共识,避免把有限的精力平摊在所有功能上。
第二步:将治理检查点嵌入现有CI/CD流程
确定风险优先级之后,针对高风险AI功能,在现有的Pull Request模板和CI流水线中增加三个最小化检查项:模型输入/输出的数据来源是否有记录(可追溯性);模型的预期行为边界是否有测试用例覆盖(可验证性);异常输出的降级或回退机制是否就绪(可恢复性)。这三项检查不需要新建工具,只需在代码审查清单和自动化测试脚本中增加对应条目。预期增加的评审时间通常在每次PR的10到20分钟以内。
第三步:建立轻量级的"治理即代码"记录机制
治理的可审计性要求有记录可查,但记录本身不应成为负担。推荐的做法是,在代码仓库中为每个AI组件维护一个结构化的Markdown文件(类似"模型卡片"的简化版),内容包括:模型用途、数据来源概述、已知局限性、当前监控指标、最近一次评审记录。这个文件随代码一起提交和更新,避免了治理文档与实现代码的脱节。对于已有文档规范的团队,这通常只是在现有README规范上增加一个固定章节,边际成本极低。
三种治理落地模式的对比分析
在与不同规模的工程团队合作中,我们观察到三种主流的AI治理落地模式,它们在灵活性、覆盖深度和实施成本上各有取舍。
| 对比维度 | 集中评审模式 | 嵌入式流程模式 | 自动化优先模式 |
|---|---|---|---|
| 治理检查时机 | 发布前集中审批 | 每个PR/迭代周期嵌入 | 实时自动化检测 |
| 对交付节奏的影响 | 显著阻断,积压风险高 | 轻微增加单次周期,整体无阻断 | 几乎无感,但需前期工具投入 |
| 治理覆盖深度 | 深,但存在评审盲区 | 中等,依赖工程师执行纪律 | 可配置,覆盖面取决于规则设计 |
| 适用团队规模 | 大型企业,合规部门独立 | 中小型团队,工程主导 | 技术能力强的团队,有平台工程资源 |
| 初期实施成本 | 高(流程设计、委员会建立) | 低(在现有模板上扩展) | 中高(工具链开发) |
| 长期维护难度 | 高(委员会协调、日程管理) | 中(规范迭代) | 低(规则更新即可) |
集中评审模式在高度监管行业有其必要性,但对大多数产品团队而言,嵌入式流程模式是启动治理的最优路径——它以最低的摩擦实现了治理覆盖,并且随着团队能力成熟,可以逐步过渡到自动化优先模式。
治理框架的五个核心设计原则
原则一:治理应该让工程师"默认合规",而非"主动申报"
这是嵌入式治理思路的核心。当治理检查点是一个需要工程师主动跳转到另一个系统、填写另一个表单的步骤时,它就会被跳过。正确的设计是:把治理检查变成工程师已有工作流中的默认部分——PR模板里的一个checkbox、自动化测试套件里的一个标准测试集、代码审查清单里的固定条目。合规成本越低,执行率越高。
原则二:区分"门控治理"与"监控治理"
并非所有治理都必须是"发布前阻断"的形式。对于成熟度较高、风险相对可控的AI功能,可以采用"监控治理"模式:先允许功能上线,同时配置好异常监控、输出质量采样和用户反馈回路,以事后发现代替事前阻断。这种模式显著降低了治理对交付速度的摩擦,同时保持了对生产环境风险的持续可见性。当然,对于真正高风险的决策功能,门控治理是不可替代的。
原则三:让数据血缘(Data Lineage)成为治理的基础设施,而非额外负担
AI系统治理的核心困难之一在于:当模型输出出现异常时,工程师往往无法快速追溯到是哪个数据环节出了问题。建立清晰的数据血缘记录,不仅是合规要求,更是工程团队快速排查问题的效率工具。在面向生产环境的AI数据管道设计中,数据血缘的可追溯性应该从架构设计阶段就作为一等公民纳入考量,而不是在出现问题之后再做补救性的日志挖掘。
原则四:治理文档应该"活在代码旁边"
治理文档与代码实现的脱节是造成治理失效的最常见原因之一。当文档存在于另一个系统(如Confluence或SharePoint)而代码在GitHub时,它们的更新节奏很快就会出现偏差。推荐的做法是将治理文档作为代码仓库的一部分进行版本管理,并在CI流水线中加入文档完整性检查——例如,如果模型文件有变更但对应的模型卡片文件没有同步更新,则触发提示或警告。
原则五:治理成熟度应该是一个渐进的过程,而非一次性的完整实施
我们在实践中观察到,试图一次性落地"完整治理框架"的团队,往往在第一次季度评审之前就宣告失败。更有效的做法是采用"治理成熟度模型"思路:第一阶段,建立最基本的可追溯性和可回滚能力;第二阶段,建立自动化测试覆盖和监控告警;第三阶段,建立跨功能的治理仪表板和定期评审节奏。每个阶段都产生可见的工程价值,这样治理建设本身就能获得工程团队的内生动力。
对于希望系统理解AI系统架构设计全局的技术领导者,本季度CTO必须评估的AI系统架构模式提供了从架构层面统筹治理与性能权衡的完整视角。
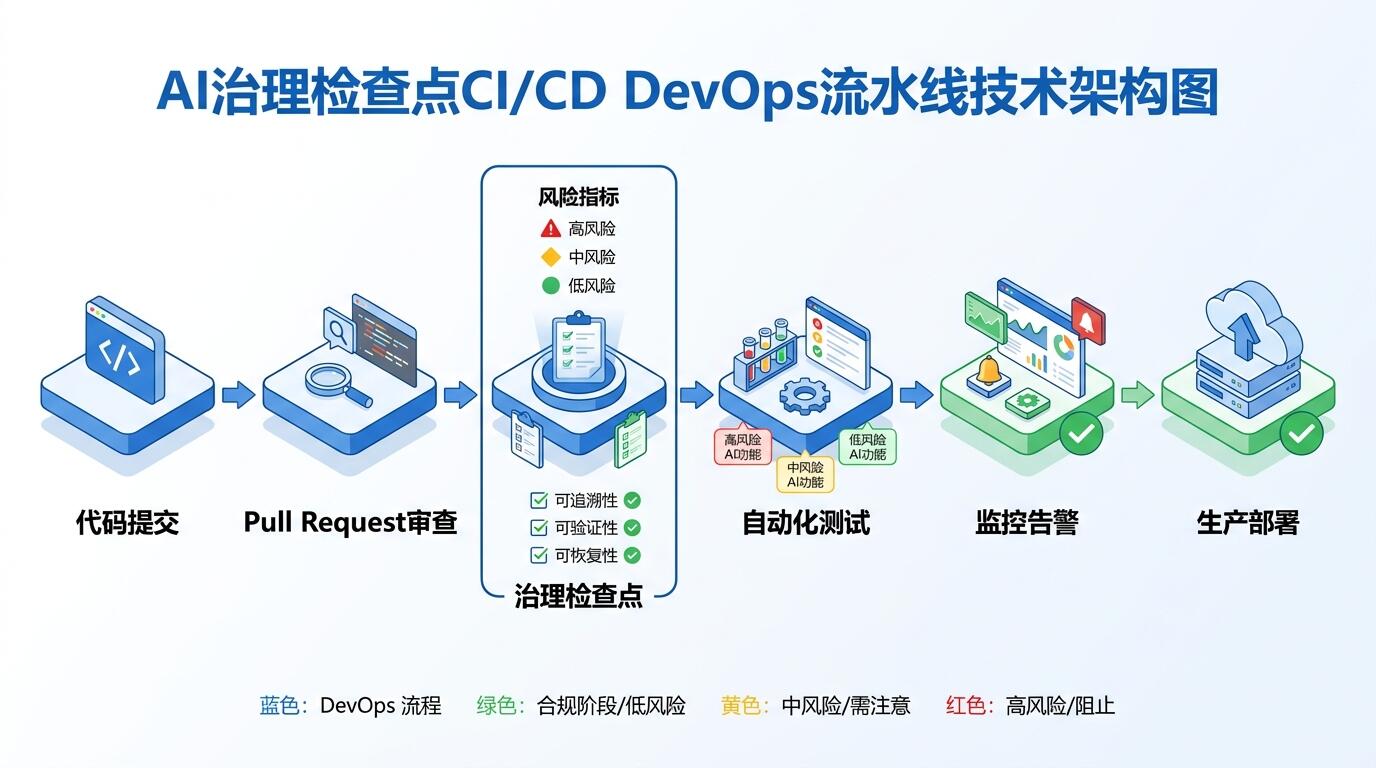
ALT: Diagram showing AI governance checkpoints integrated into CI/CD pipeline for continuous compliance without blocking delivery
进阶场景:当治理遭遇特殊挑战
场景一:第三方AI服务的治理盲区
当团队使用OpenAI、Anthropic或其他第三方API作为AI能力来源时,模型本身的行为不在团队的直接控制范围内。这类场景的治理重点应转移到接口层:明确定义输入/输出的质量断言、建立对第三方服务响应的采样审计机制、维护服务降级预案。根据OpenAI面向企业的指引,在AI时代保持竞争优势的关键之一,正是建立对AI能力使用的系统性管控,而不是单纯依赖供应商的内置安全机制。
场景二:团队对"治理就是官僚主义"的文化阻力
这种阻力通常源于过去被繁琐流程伤害过的经历。应对方法不是说服,而是用第一个版本证明:治理流程本身可以很快,而它带来的价值(更快的问题定位、更清晰的责任边界、更少的生产事故善后时间)是实实在在的工程效率收益。在首次落地时,刻意选择一个工程师已经觉得痛苦的高风险功能作为试点,让治理流程直接解决他们的痛点,而不是从一个"没有历史问题"的干净功能开始。
常见误区澄清:治理不等于减慢实验速度
一个常见的误解是,AI治理会压缩探索性实验的空间。实际上,治理框架应该在实验阶段和生产阶段之间建立清晰的边界——实验环境可以保持最大的自由度,而治理检查点只在功能准备进入生产时触发。这种分层设计既保护了创新速度,又确保了生产风险可控。
常见问题解答
Q1:如何评估当前团队的AI治理成熟度?
AI治理成熟度的自评可以从四个维度入手:可追溯性(能否在24小时内追溯到任何生产环境AI输出的数据来源);可验证性(是否有自动化测试覆盖核心AI功能的边界行为);可观测性(是否有生产监控可以在异常发生后的合理时间内触发告警);可问责性(是否有清晰的责任归属,让每个AI功能对应到一个明确的负责人)。四项全部具备为成熟,缺少任何一项均为需要优先补强的短板。
Q2:嵌入式治理模式是否适用于快速迭代的初创公司?
嵌入式治理模式恰恰最适合资源有限、追求速度的初创公司。其核心优势在于:它不需要新建独立的治理基础设施,而是在现有工程工作流上增加结构化的检查习惯。APMG International的AI项目治理框架研究指出,治理能力与项目成功率之间存在正相关——有清晰治理机制的AI项目,在风险发生时的恢复速度显著更快。初创公司尤其承受不起生产事故带来的信誉损失,因此治理的ROI反而更高。
Q3:建立一套基础的嵌入式AI治理机制大约需要多少时间投入?
基于我们在不同规模团队中的实践经验,一个5到10人的工程团队,从零建立覆盖风险分类、PR检查嵌入和基础文档规范的第一阶段治理机制,通常需要两到三个工作日的专项投入用于设计和配置,加上后续两到三个Sprint的迭代磨合期。这个投入规模对大多数团队是可承受的,而它换来的是整个团队对AI风险的系统性可见性,以及在面对客户或监管审计时的基本准备就绪状态。
核心要点
关键收获
- AI治理的最大落地障碍不是技术,而是流程设计方式——治理必须嵌入工程师已有的工作流,而非在其之外新建审批通道。
- 风险分级是治理资源分配的起点:不同风险等级的AI功能适用不同强度的治理检查,一刀切的重量级治理既浪费资源,又拖慢交付。
- 可追溯性、可验证性、可观测性和可问责性是衡量AI治理成熟度的四个实用维度,优先补强最薄弱的一项。
- 治理文档与代码共同版本管理,是防止治理文档与实际实现脱节的最低成本解法。
- 治理成熟度建设是渐进的:先建立最小可行治理,再逐步提升自动化覆盖和系统性,避免一次性落地完整框架带来的推行失败风险。
下一步行动:审视你们团队当前在途的AI功能,用"决策自动化程度"和"影响范围"两个维度做一次快速分类,找出风险最高的那一个,将本文介绍的三项基础检查嵌入它的下一个PR流程。这是建立可持续AI治理能力最有效的起点。
如果你正在思考如何将AI能力系统性地嵌入产品,同时保持工程团队的交付节奏,欢迎访问 Darius 的技术博客与项目案例,了解从架构设计到生产部署的完整工程实践。无论你是处于早期验证阶段的创始人,还是正在扩展AI系统规模的技术负责人,都可以通过 darius.wiki 发起合作探讨。
参考资料
- APMG International. "AI 项目治理框架".
https://apmg-international.com/zh-hans/article/xiangmuzhilitashishenmeyijiweihezaidangxiabiyiwangrenheshihoudougengjiazhongyao - OpenAI. "在AI 时代保持领先地位".
https://openai.com/zh-Hans-CN/business/guides-and-resources/staying-ahead-in-the-age-of-ai/ - 网易云信 CodeWave. "企业级AI Coding 如何治理?从代码生成到交付链路的管控框架".
https://codewave.163.com/info/enterprise-ai-coding-governance-framework.html
注:相关标准和监管要求持续更新,建议定期查阅最新官方文件或咨询专业顾问。