博客
记录把想法做成在线运行产品过程中的取舍与心得 —— AI 产品、云存储、SEO 与全栈实践。 简报是每天的短,这里是偶尔的长。
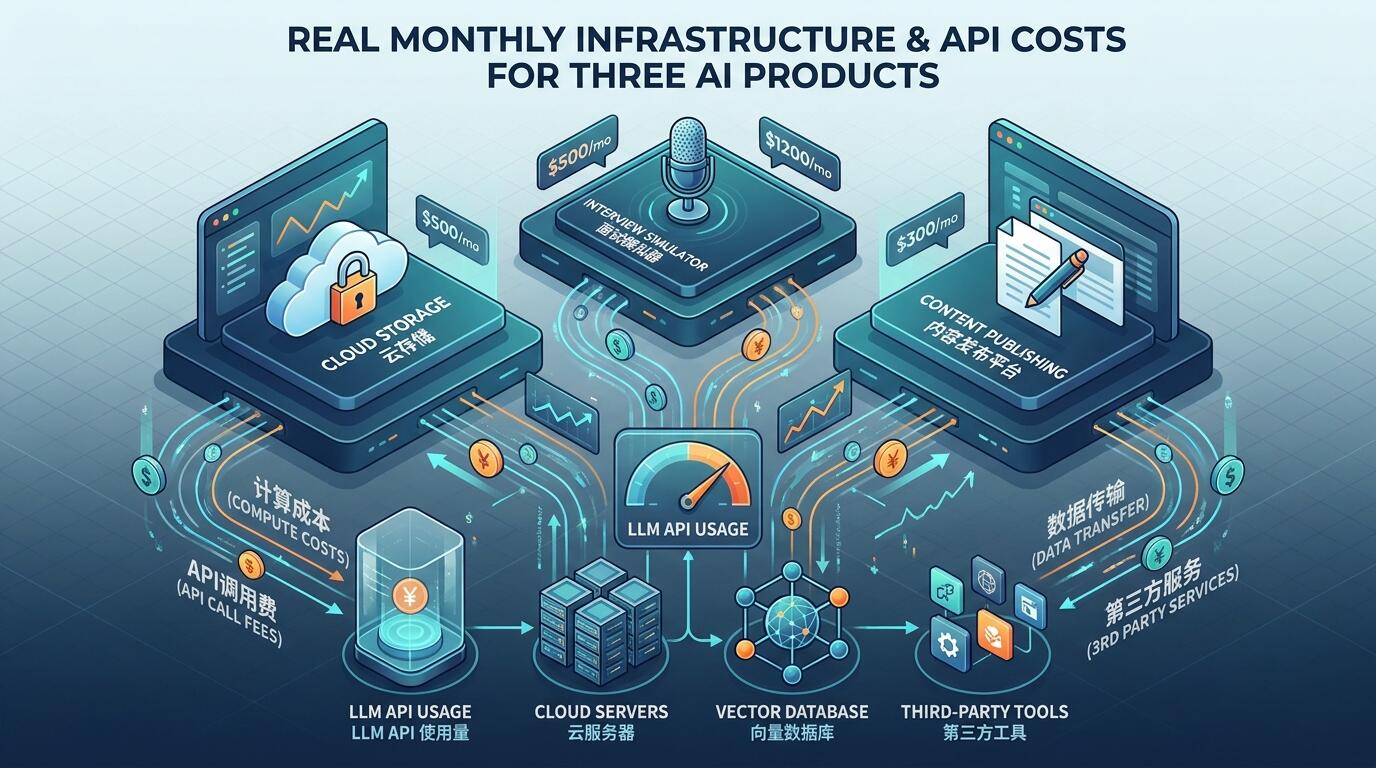
- 2026-10-19 每月维持三款AI产品在线的真实成本清单 本文由独立开发者以真实账单为基础,逐项拆解同时运营三款AI产品(AI云盘、AI面试模拟器、创作工作台)的月度成本结构,涵盖大模型API、云基础设施、向量数据库等七大类别,并提供不同产品阶段的成本控制决策框架,适合独立开发者和小团队建立可复用的AI产品成本认知体系。 阅读 →
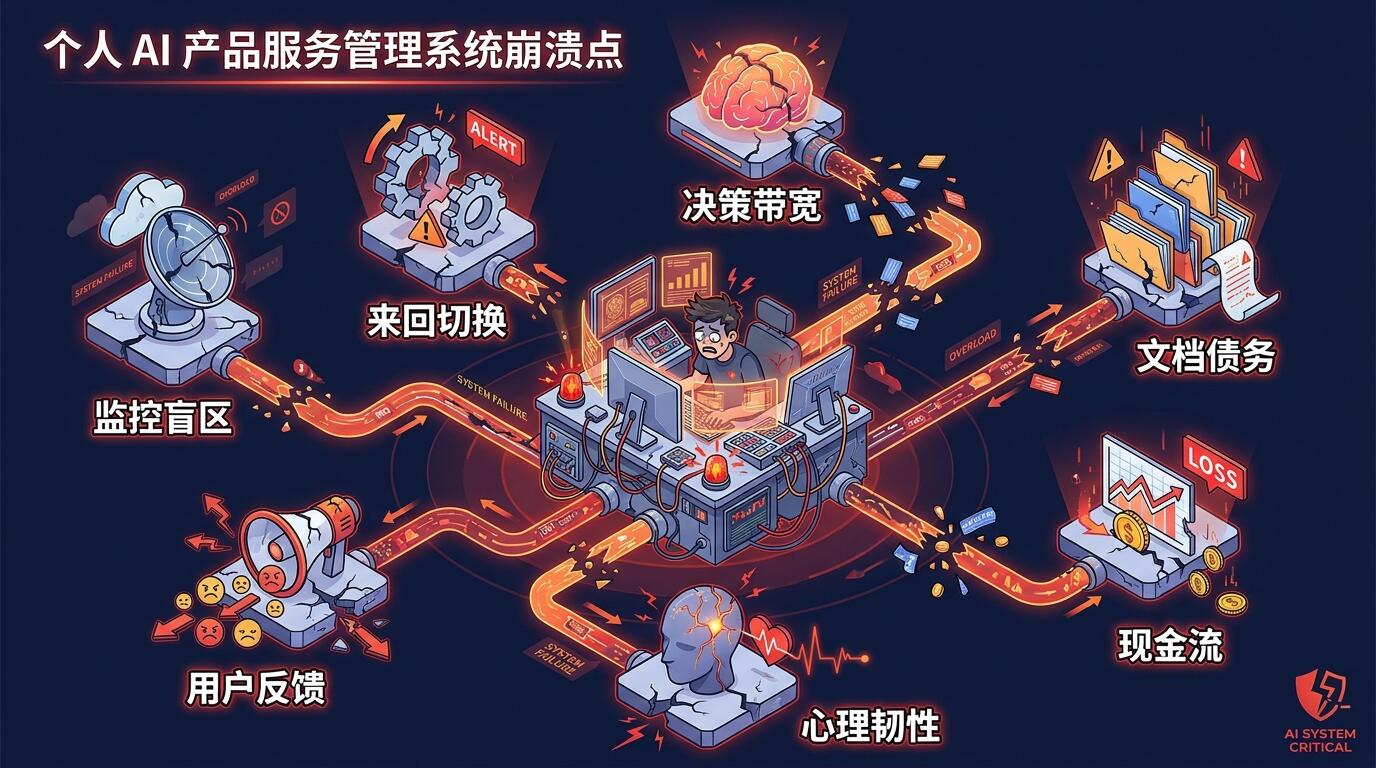
- 2026-10-18 当一个人拥有全部服务:最先崩溃的环节是什么 本文面向独立开发者与小团队,系统拆解单人全栈运营AI产品时最易崩溃的七个环节:决策带宽、上下文切换损耗、监控盲区、文档债务、用户反馈处理、财务现金流与心理韧性储备,并按产品阶段给出优先干预建议,核心结论是崩溃从认知资源而非技术栈开始。 阅读 →
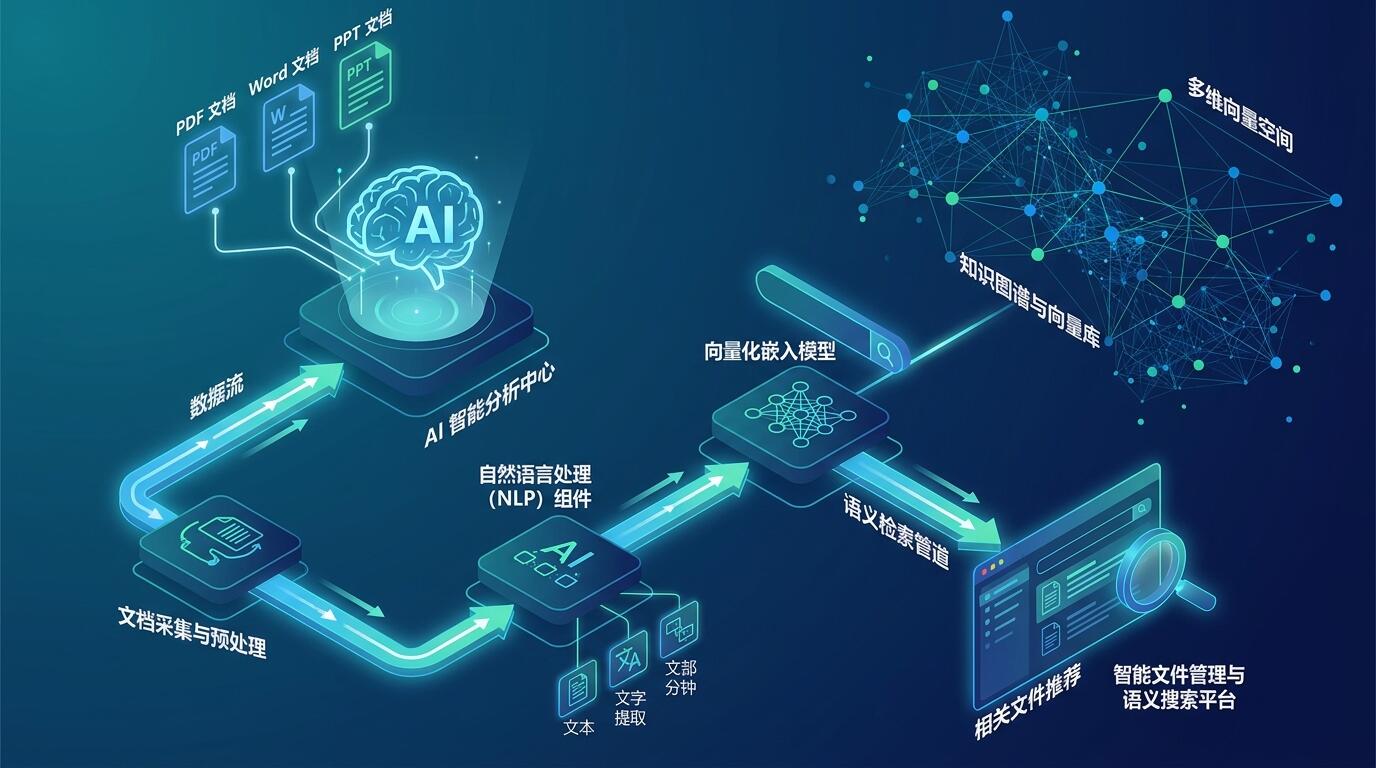
- 2026-10-18 档案级语义检索入门:aipan如何让文件'看得懂'内容 本文面向工程师和技术决策者,系统拆解了在档案/网盘场景中从零构建档案级语义检索系统的完整工程流程,涵盖文档解析、文本分块、向量化、索引构建、检索接口及持续调优六大步骤,并结合aipan产品真实实践给出避坑建议,核心结论是文档解析质量决定系统上限,调优需持续投入。 阅读 →
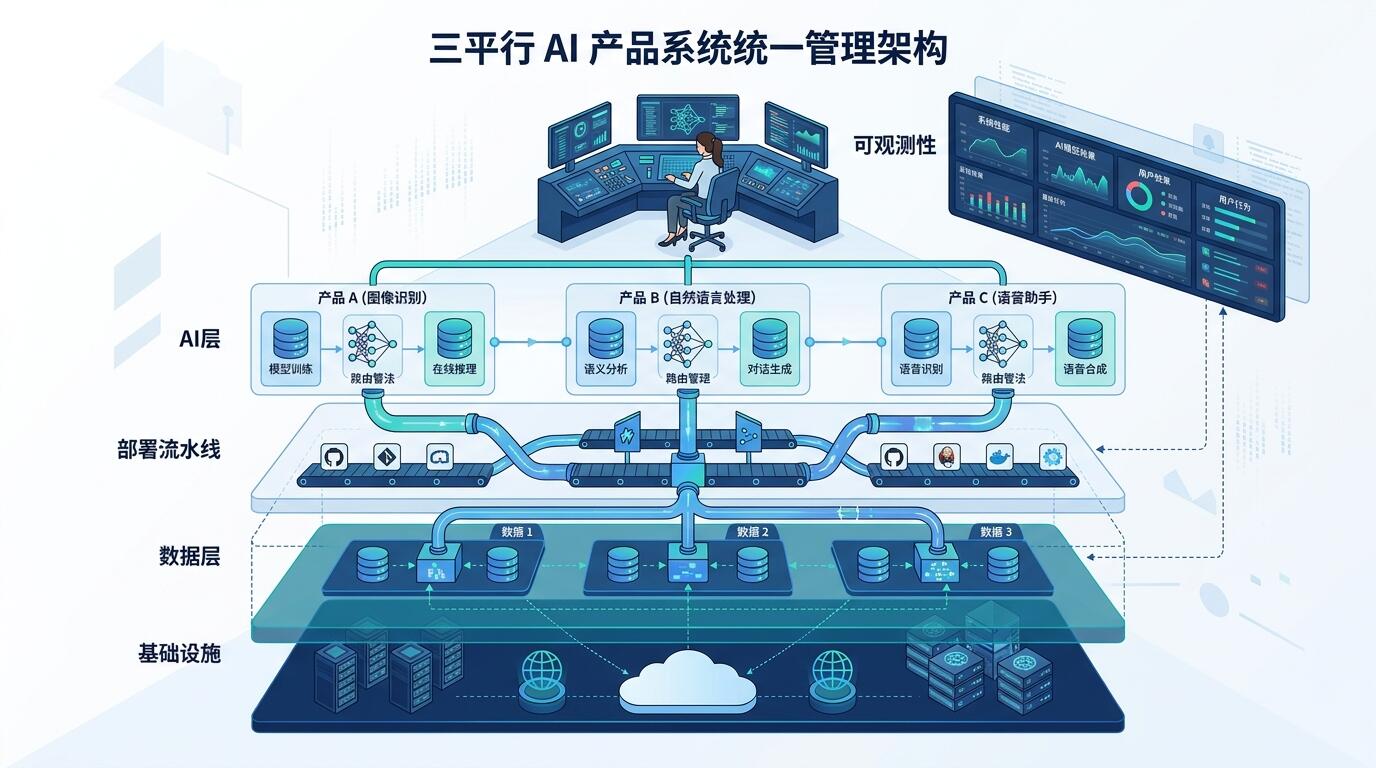
- 2026-10-18 独立工程师如何同时运营三款生产级AI产品:本季度的真实技术栈 本文由工程总监第一手复盘,系统介绍独立工程师同时运营三款生产级AI产品的技术栈与决策框架,涵盖基础设施收敛、AI分级路由、CI/CD统一、可观测性与成本管理。核心结论:技术栈标准化与工程纪律优先于工具堆叠,适合AI独立开发者与技术决策者参考。 阅读 →
- 2026-10-17 存储成本与向量成本的真实账单:本季度aipan运营数据公开 本文面向AI知识库(aipan)产品的工程师与架构师,以真实季度账单数据拆解了对象存储、Embedding计算和向量索引三层成本结构,揭示向量数量是核心驱动变量,并提出分块策略优化、冷热分层、查询缓存、模型维度选型四大高性价比降本手段,建议每季度复盘成本结构以实际数据驱动决策。 阅读 →
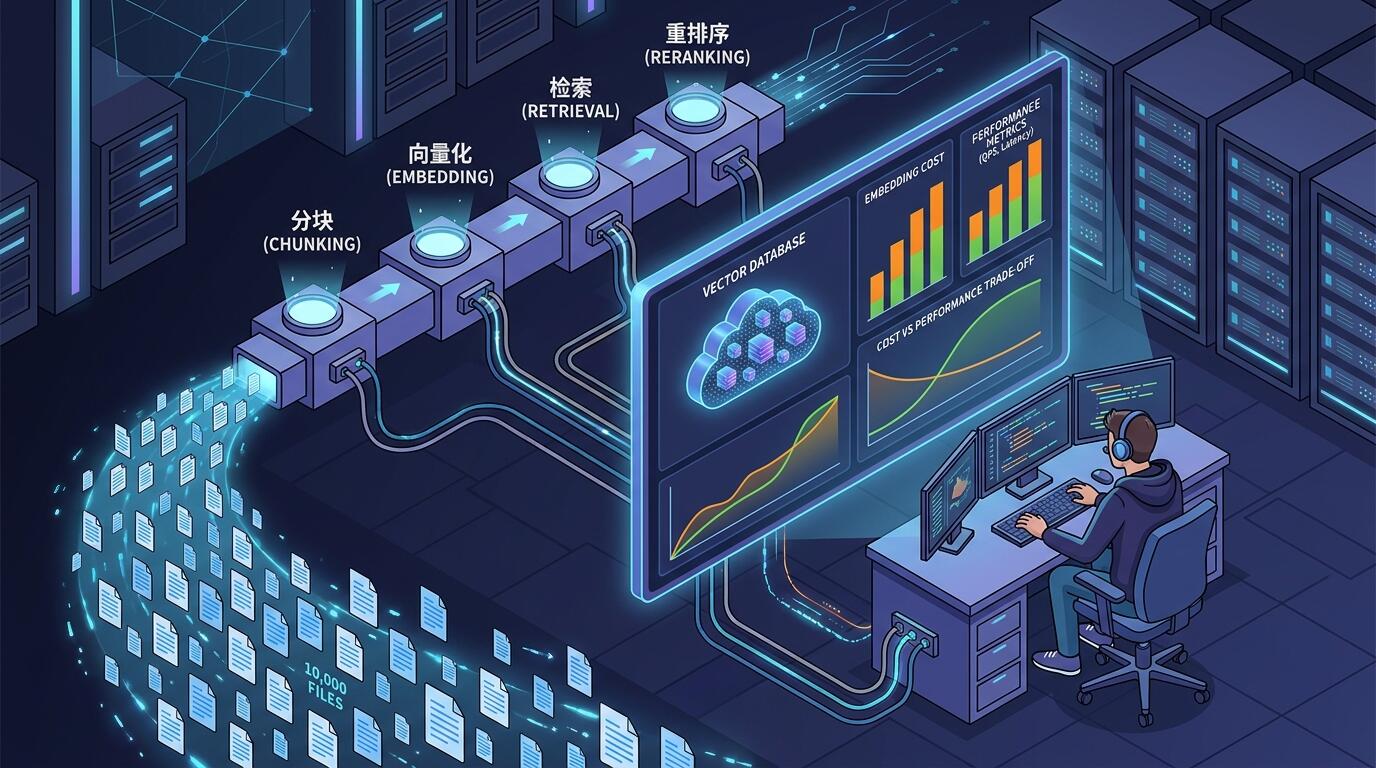
- 2026-10-17 把一万个文件变成可语义搜索:本季度的成本与性能权衡 本文面向AI工程师,系统拆解万级文件语义搜索系统的7大工程权衡:embedding模型选型、分块策略、向量数据库取舍、混合检索、增量更新、重排序与评估管线。核心结论:架构设计阶段须纳入成本与性能权衡,评估管线是一切优化前提,保持架构简单优于过度设计。 阅读 →
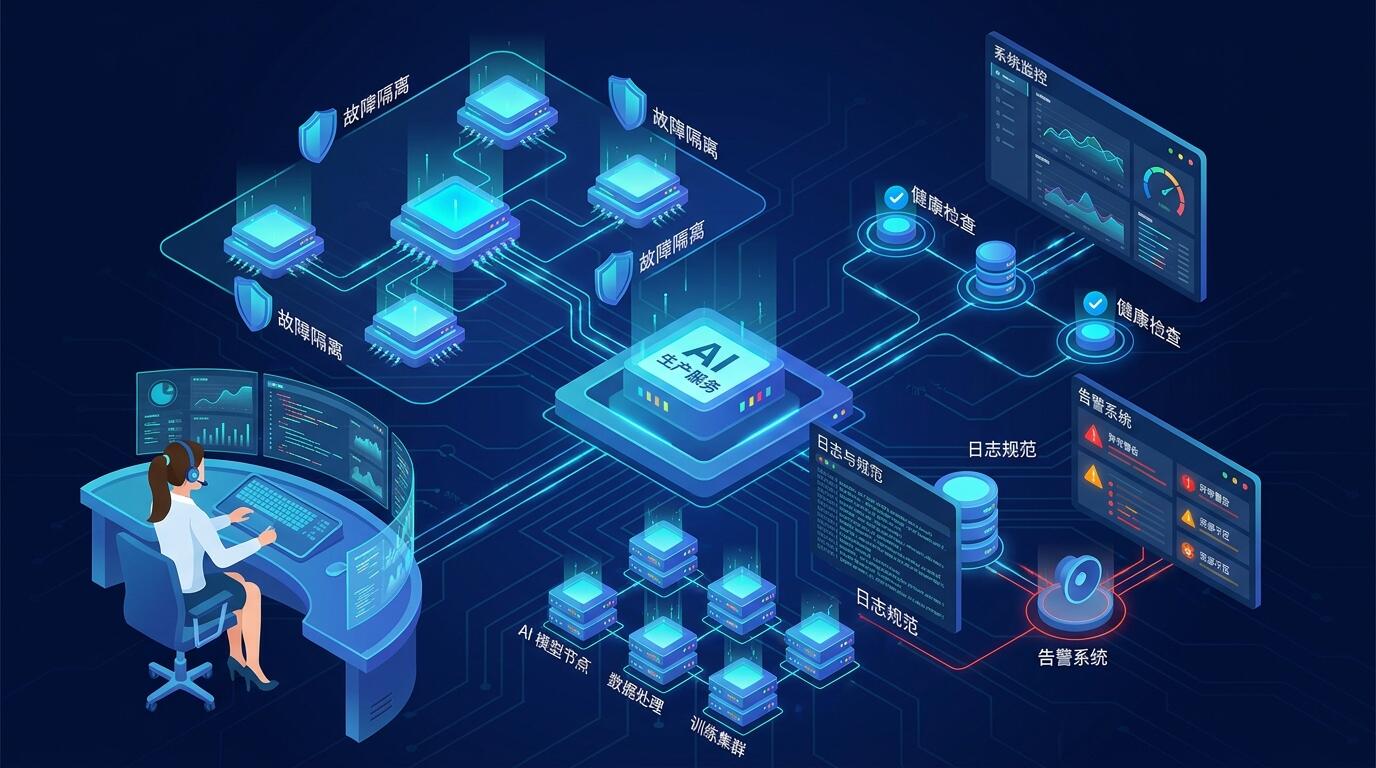
- 2026-10-17 独立运营多个生产服务的进阶技巧:本季度的稳定性经验 本文面向独立运营多个AI生产服务的工程师或极小团队,系统梳理了8条可立即落地的稳定性进阶技巧,涵盖故障隔离、健康检查、降级预案、变更管理、成本追踪、日志规范、自动化测试与灾难演练,强调以最低资源成本换取最高稳定性回报,帮助读者在资源受限下有效预防和快速响应生产故障。 阅读 →
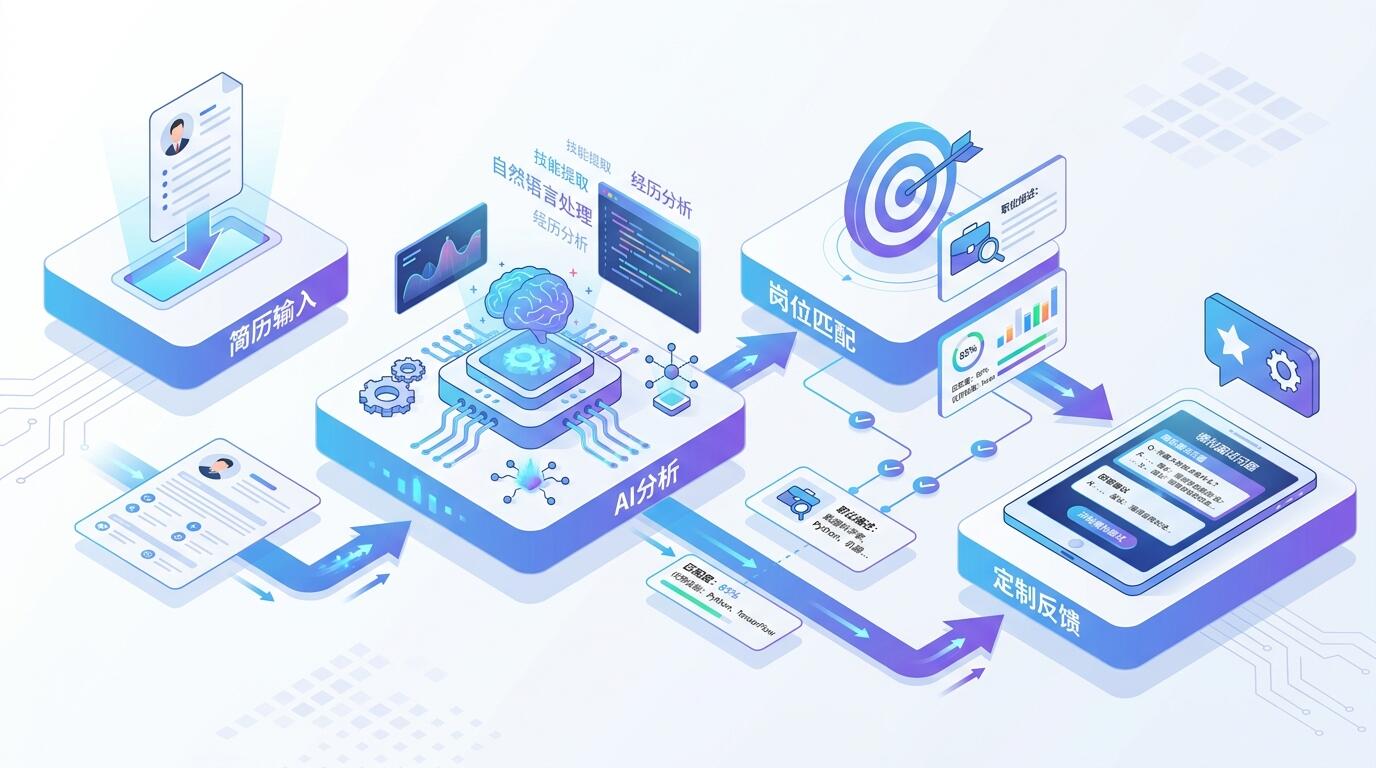
- 2026-10-16 interview产品访谈:如何把简历转化为岗位定制反馈 本文系统讲解如何将通用简历转化为岗位定制访谈准备材料,提出六步结构化方法论:简历拆解→JD解构→显式匹配映射→缺口问题预测→反馈评估→整合输出包。面向AI求职产品工程师、产品负责人及招聘负责人,核心结论是结构化处理优于整体输入,缺口比优势更值得重点准备,且访谈准备应多轮迭代而非一次性输出。 阅读 →
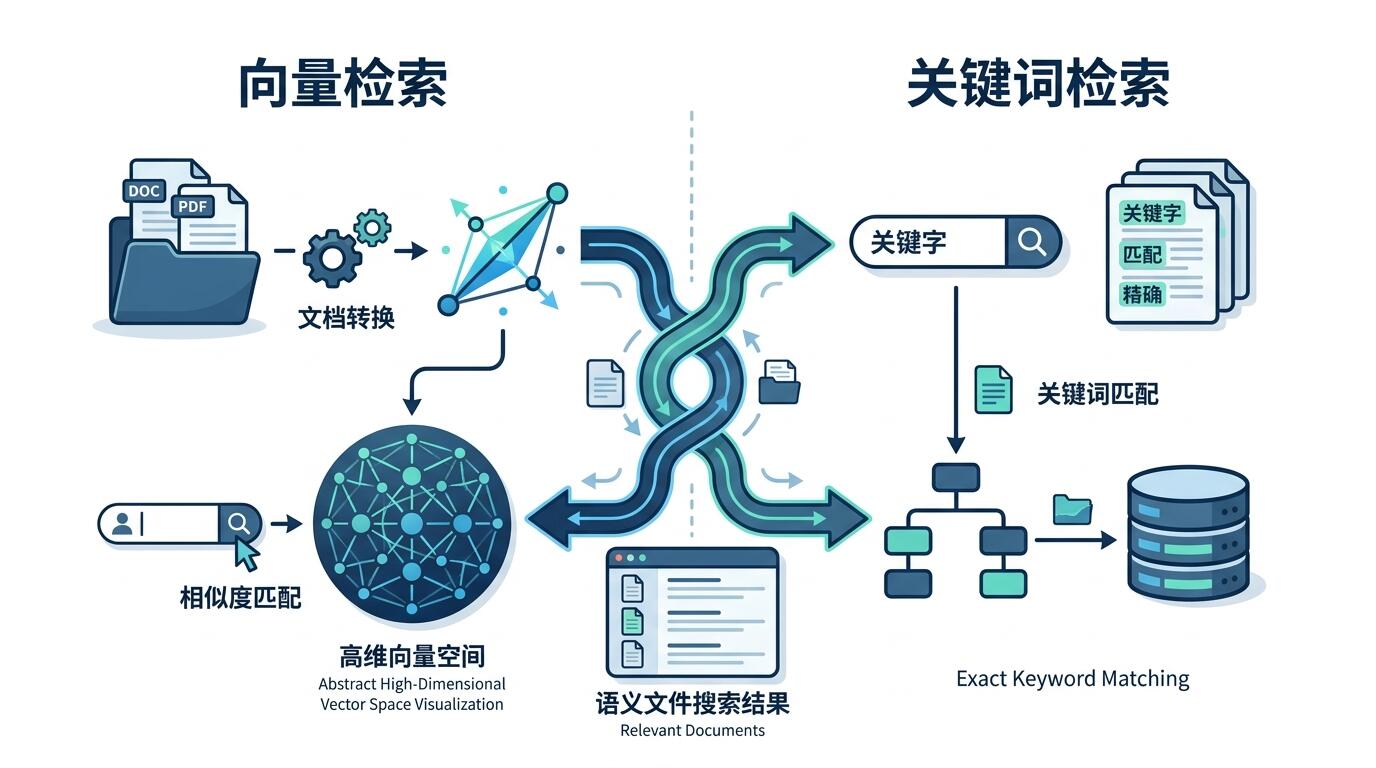
- 2026-10-16 把文件变成可语义搜索的内容:aipan的语义检索实践入门 本文面向个人开发者与企业技术团队,系统对比了文件语义搜索三条主流路径:纯向量检索(Dense Retrieval)、BM25关键词检索、混合检索(Hybrid Retrieval),从语义准确度、工程复杂度、成本和适用场景四大维度拆解选型逻辑。核心结论:技术路线应由真实查询模式驱动,混合检索综合效果最稳,小团队宜先用轻量方案验证后再扩展。 阅读 →
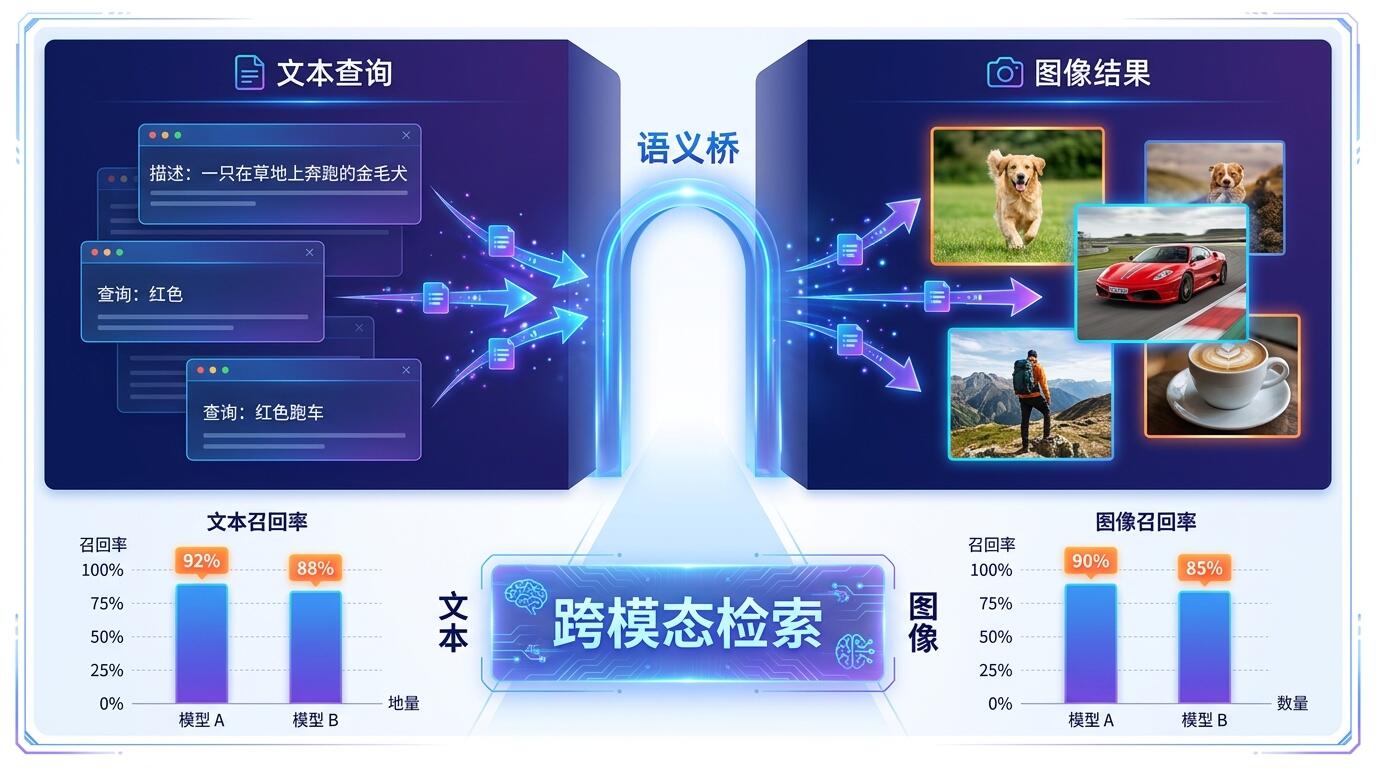
- 2026-10-16 面向初学者的多模态向量模型入门:召回率实测笔记 本文面向AI工程初学者,深度拆解多模态向量检索系统召回率偏低的根本原因,涵盖模态对齐质量、分布偏移、ANN索引损耗与评测设计偏差四大机制,并对比微调、困难负样本挖掘、混合检索等主流优化策略的权衡,核心结论是召回率瓶颈在于系统性失配而非模型本身。 阅读 →
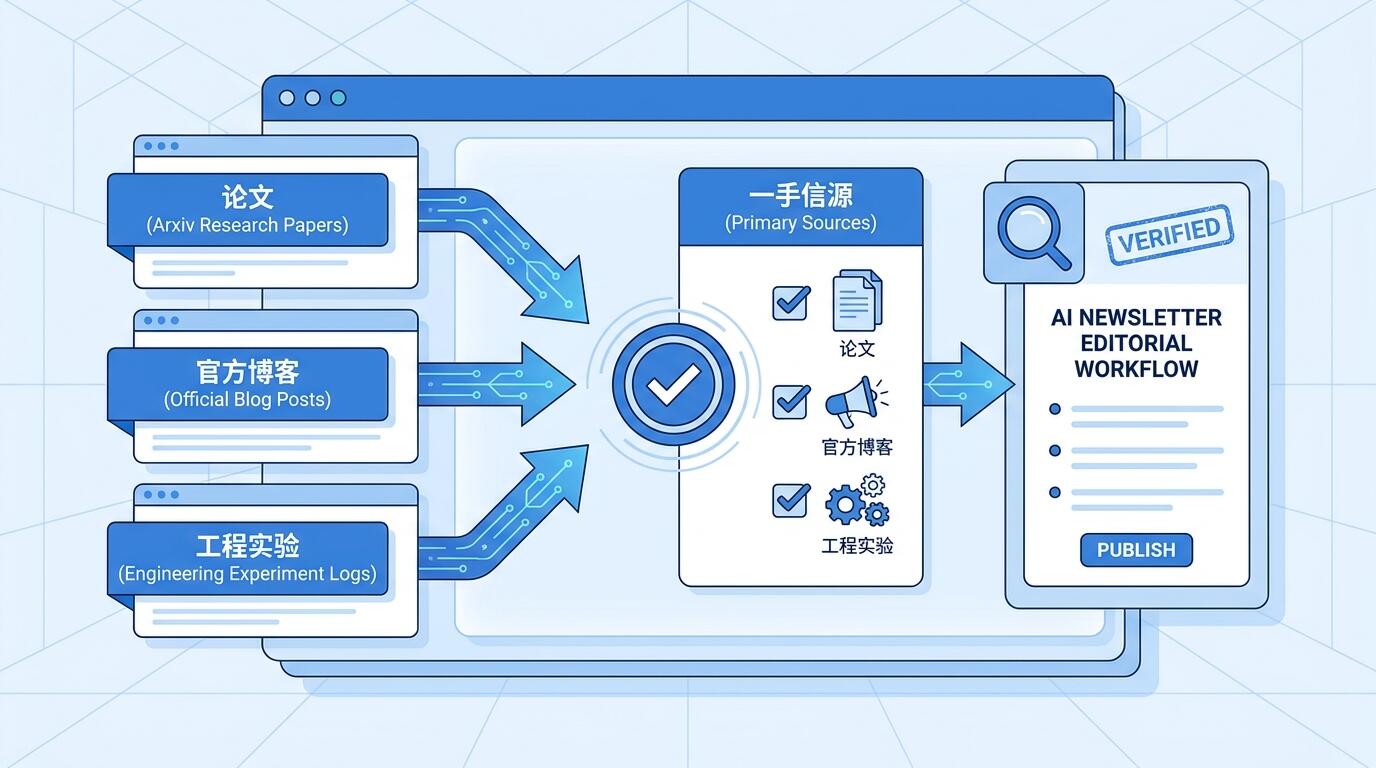
- 2026-10-15 案例研究:坚持一手信源原则如何塑造本季度的简报质量 本文以Darius AI双语简报的季度实践为案例,系统阐述"一手信源原则"如何提升AI简报质量。面向AI产品工程师与技术负责人,提出信源分级、监控体系、核查SOP、工程实验纳入等六步操作框架,核心结论:信源质量决定决策判断上限,透明勘误机制是长期信任的结构性资产。 阅读 →
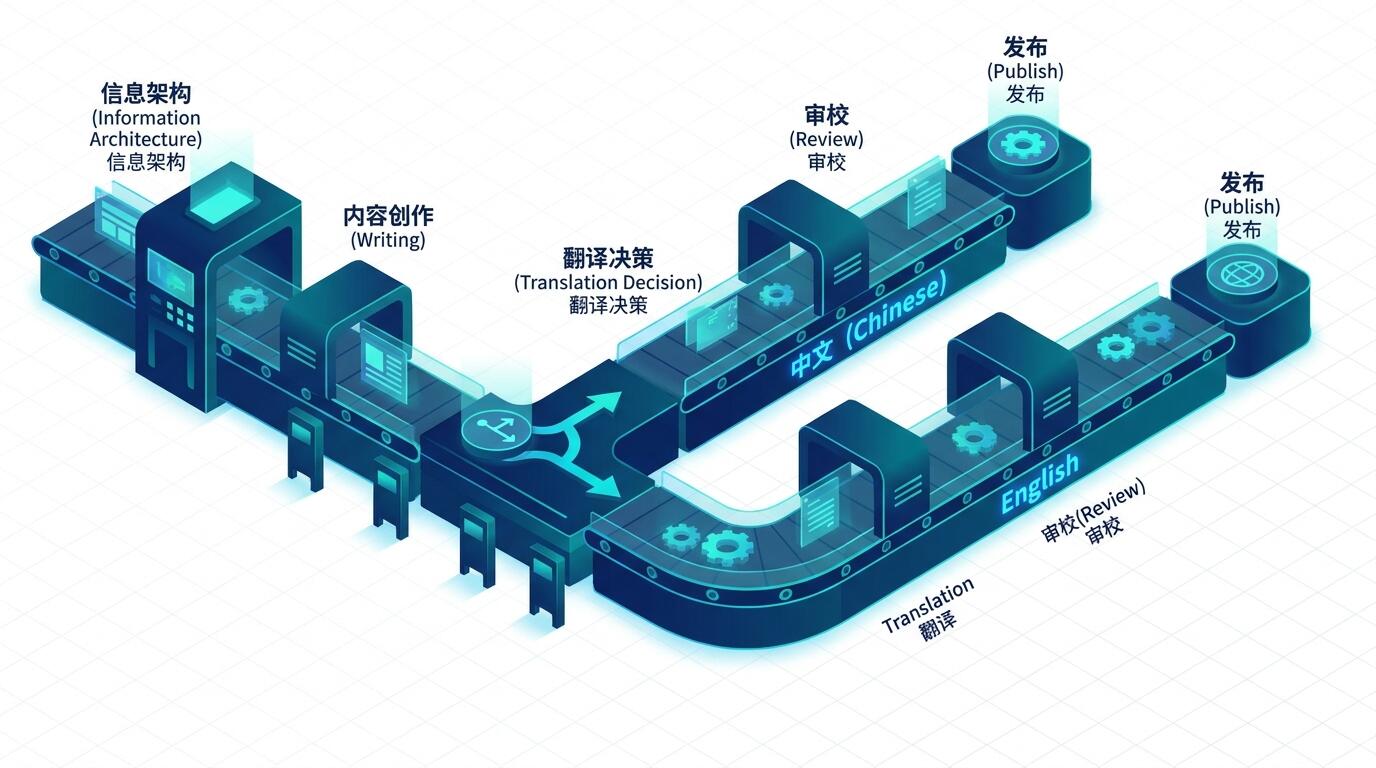
- 2026-10-15 翻译不是后处理:本季度双语出版的工程化实践笔记 本文以工程师视角系统阐述双语出版应从信息架构阶段介入,而非作为后处理翻译。面向有长期双语内容运营需求的技术团队,提出"结构先行、语言后分叉"核心方法论,并以Darius简报实际运营案例验证了该策略在质量、效率和维护成本上的综合优势。 阅读 →
- 2026-10-15 面向创始人的模型发布评估指南:本季度如何快速决策 本文面向AI创始人、技术负责人与独立开发者,提供一套6步可落地的模型发布评估框架,涵盖快速过滤、维度权重定义、测试集构建、并行对照实验、决策转化与归档复用。核心主张:建立系统化私有评估能力,优于依赖公开benchmark或盲目跟风迁移,可将模型决策从随机应激转变为可复用的工程基础设施。 阅读 →
- 2026-10-14 智能体流水线深度报告:检索、验证、发布三阶段全解析 本文以工程师视角系统拆解AI智能体流水线的检索、验证、发布三阶段底层机制,对比单智能体RAG、多智能体协作、工具调用三种架构的适用场景,并给出可落地的质量评估指标与演进建议,核心受众为AI产品工程师与技术负责人。 阅读 →
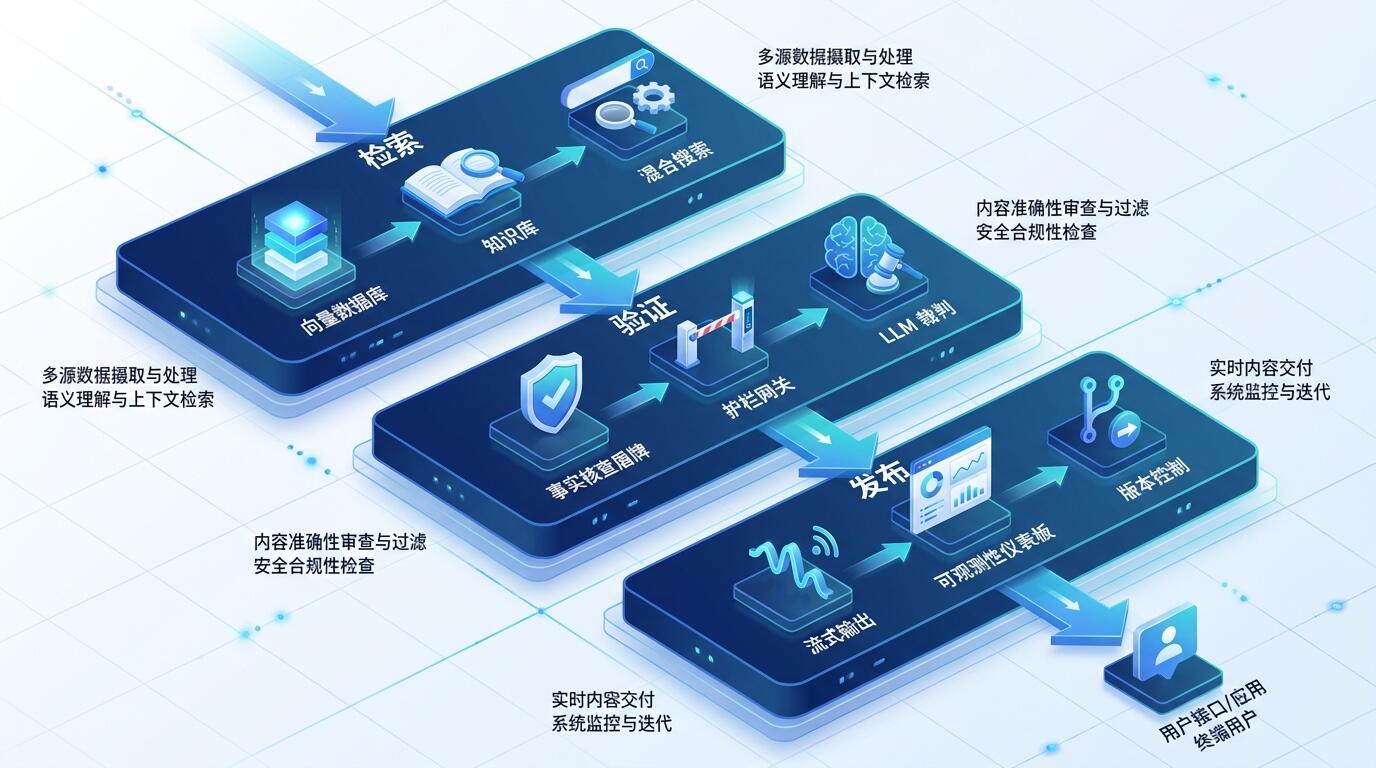
- 2026-10-14 给营销团队的启发:AI简报流水线能教会你什么 本文以AI简报流水线为核心案例,系统阐述营销团队如何借鉴其工程化思维,将内容生产转变为可复用、可扩展的系统工程。核心观点:内容生产应模块化、一稿多发、以节奏建立信任。适合中小型营销团队落地参考,实操性强。 阅读 →
暂无博客文章