面向营销人员的智能体流水线启示录:本季度可复用的方法论
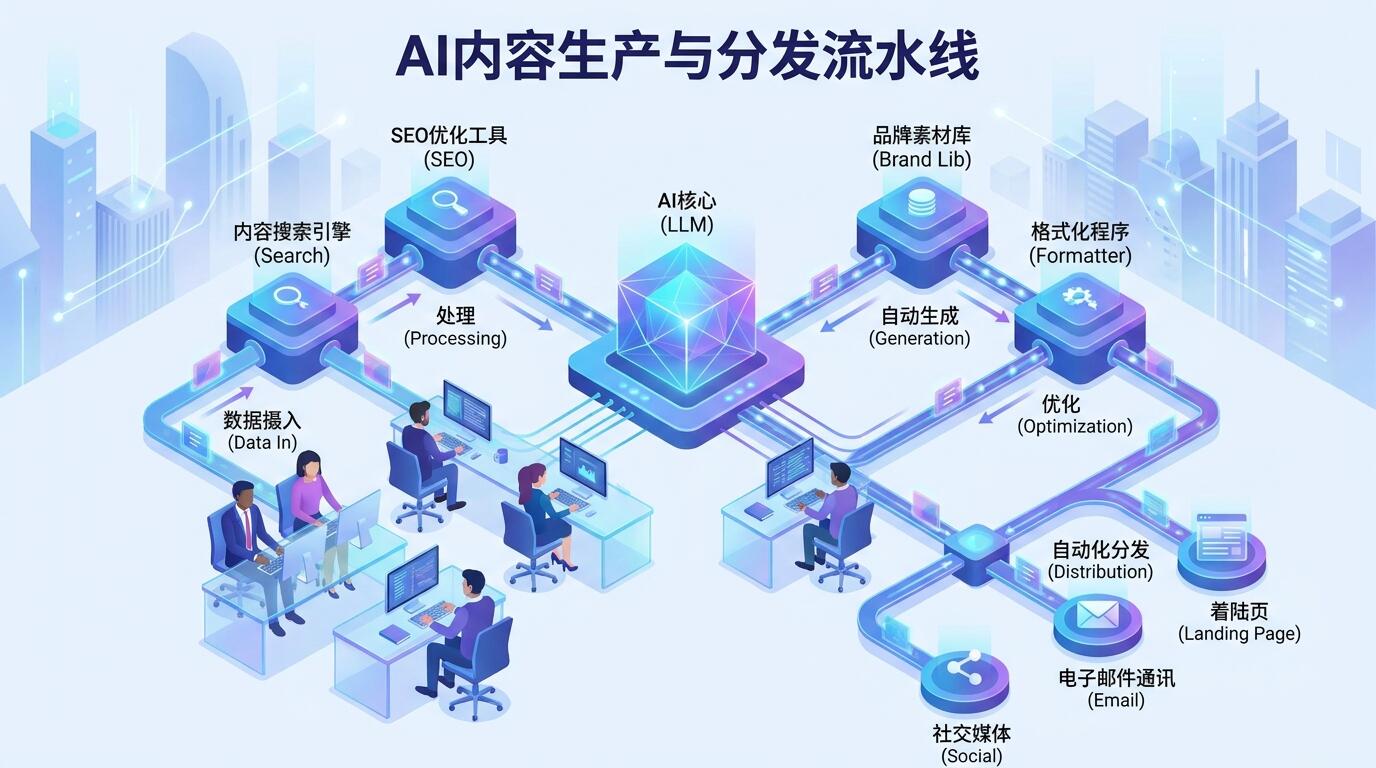
ALT: 营销人员使用智能体流水线进行内容生产与分发的自动化方法论示意图
智能体流水线:营销团队的三种路线,哪条真正可复用?
营销团队在引入 AI 智能体之后,往往会遭遇同一种尴尬:第一个月跑通了一条内容生产流水线,第二个月想把同样的逻辑复用到另一个品类,发现提示词失控、数据格式对不上、人工介入点漏掉了三处。这不是工具问题,而是方法论问题——大多数团队在"能跑"和"可复用"之间缺少一层设计意识。
本文聚焦三种在营销场景中已有生产环境验证的智能体流水线路线,从评估维度、适用场景到直接的对比结论,给你一套本季度可以落地的判断框架。比较的核心维度是:可复用性(Reusability)、可观测性(Observability)、维护成本(Maintenance Cost)、编排复杂度(Orchestration Complexity)与团队所需技能门槛(Skill Threshold)。
评估维度:判断一条营销智能体流水线是否值得投入
判断一套营销智能体流水线是否"值得",不能只看首次跑通的成功率,关键是五个维度的综合权衡。
可复用性是首要标准。一条流水线如果只服务于单一活动、单一语种或单一渠道,其工程投入很难摊薄。可复用性强的设计通常依赖参数化模板、可替换的 Retrieval 模块和标准化的输出 Schema。
可观测性决定你能否在流水线出错时快速定位问题。营销场景中,LLM 调用链路往往超过三层,没有 Tracing 和 Log 聚合,排查一个输出质量下降的问题可能耗费半天。OpenTelemetry 等可观测性标准已在工程圈广泛落地,营销团队的 AI 系统同样需要这一层。
维护成本在营销侧特别容易被低估。活动节奏快、内容策略频繁调整,意味着流水线的提示词、上下文数据和验证规则需要定期更新。如果每次调整都需要工程师介入,实际运营摩擦会显著高于预期。
编排复杂度与团队的工程能力强相关。过度依赖多智能体协作(Multi-Agent)的方案在小团队中往往因为调试成本过高而最终被抛弃。单智能体加工具调用(Single Agent + Tool Calls)的架构在多数营销场景中已经足够,且更易维护。
技能门槛是决策时常被忽视的隐性成本。一套需要营销运营人员掌握 Python 脚本调试的方案,与一套通过可视化配置页面即可调整参数的方案,在实际落地速度上差距显著。
三条路线:当前营销团队的主流智能体流水线选择
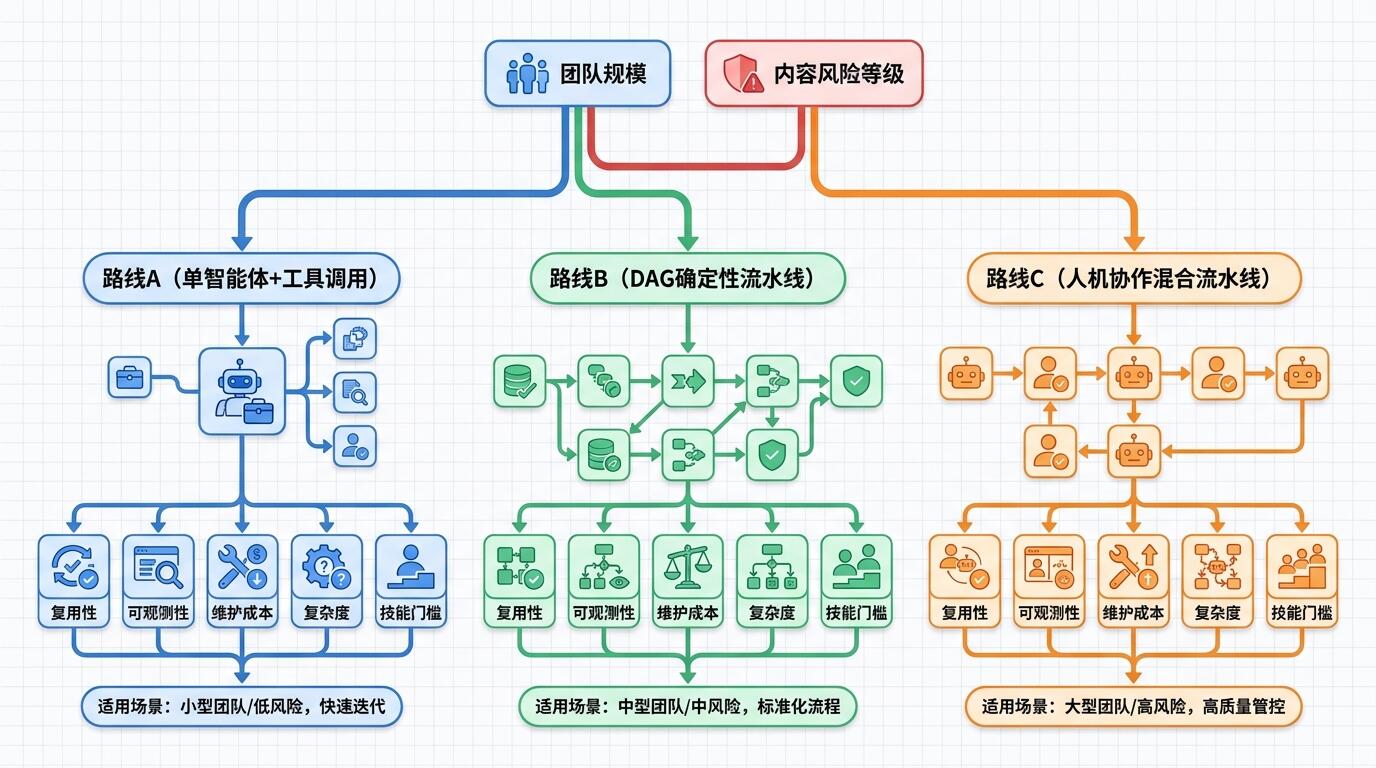
路线 A:单智能体 + 结构化工具调用(Single Agent + Tool Calls)
单智能体加工具调用是目前在营销内容生产场景中可复用性最高的路线。其核心结构是:一个主控 LLM 节点,通过函数调用(Function Calling)或工具路由(Tool Routing)调度若干专项工具——如联网检索、品牌语料库查询、SEO 关键词注入、格式化输出等。
这条路线的关键优势在于状态管理简单:整个会话上下文在单一智能体内流转,不存在多智能体之间的状态同步问题。在我们观察到的多个营销团队实践中,这种结构的 Debug 时间平均比多智能体方案少一半以上,且提示词改动只需修改一处主控节点。
可复用性的实现方式是参数化主提示词:将品牌名、目标渠道、语种、内容类型等抽象为变量,复用同一套工具集驱动不同活动的内容产出。
劣势在于,当任务复杂度超过单个上下文窗口可承载的范围时(例如需要同时处理大量竞品对比或长篇研究报告),这条路线会遇到瓶颈。
路线 B:DAG 编排的多步确定性流水线(Deterministic DAG Pipeline)
DAG(Directed Acyclic Graph,有向无环图)编排流水线的核心逻辑是将营销内容生产过程拆解为一系列有明确输入输出定义的节点,节点之间的依赖关系固定,执行顺序确定。常见工具包括 Apache Airflow、Prefect 或专为 LLM 场景设计的 LangGraph(由 LangChain 团队开发)。
这条路线的优势是可观测性极强:每个节点的执行状态、耗时、输入输出均可单独记录,失败时的重试粒度精确到节点级别。对于营销团队中批量内容生产的场景(例如为数十个 SKU 同时生成落地页文案),DAG 流水线的并行能力也远超单智能体方案。
它的弱点同样明显:初始设计成本高,每次引入新的内容类型或审核环节,都需要修改 DAG 拓扑。对于活动节奏快、内容策略变动频繁的营销团队,这种刚性结构有时反而成为瓶颈。这正是智能体流水线的检索、验证、发布三阶段设计中着重探讨的问题——三个阶段的边界划清之后,DAG 才真正发挥价值。
路线 C:人机协作混合流水线(Human-in-the-Loop Hybrid Pipeline)
人机协作混合流水线是指在智能体自动执行的各节点之间,设置明确的人工审核或决策点(Checkpoint),由营销人员或合规团队在特定步骤介入确认后再触发下一阶段。
这条路线在以下场景中几乎是唯一可行选择:涉及敏感品类(医疗、金融、法务相关)的营销内容、需要品牌一致性高度把控的全球化内容生产、以及内容发布失误成本极高的场景。
从可复用性角度看,人工介入点本身可以被模板化——例如定义标准的"品牌声音审核清单"作为每次人工介入的结构化输入,而非依赖审核者的个人判断。这套清单的设计质量直接决定了这条路线能否规模化。
维护成本上,混合流水线的挑战在于人工介入点的等待时间会打断流水线的整体节奏,需要在系统设计时明确异步队列机制,避免单点阻塞导致全链路停滞。
三条路线的横向对比
| 评估维度 | 路线 A:单智能体 + 工具调用 | 路线 B:DAG 确定性流水线 | 路线 C:人机协作混合流水线 |
|---|---|---|---|
| 可复用性 | 高(参数化易复用) | 中(结构变动成本较高) | 中(清单可复用,流程依赖人力) |
| 可观测性 | 中(需主动集成 Tracing) | 高(节点级日志天然完备) | 中高(人工节点引入不透明性) |
| 维护成本 | 低至中 | 中高(拓扑修改需工程介入) | 中(人工节点可吸收部分变动) |
| 编排复杂度 | 低 | 高 | 中 |
| 技能门槛 | 中(需懂提示词工程) | 高(需工程背景) | 低至中(人工节点可降低技术要求) |
| 适合团队规模 | 1-10 人小团队 | 10 人以上,有工程支持 | 全规模,敏感品类优先 |
从对比结果来看,三条路线的核心差异在于"灵活性"与"可预测性"之间的权衡。路线 A 的灵活性最高,适合快速迭代;路线 B 的可预测性和可观测性最强,适合规模化批量生产;路线 C 则是在内容风险较高时的安全阀。
实际上,许多成熟团队最终会走向"A 作为探索层,B 作为生产层,C 作为风控层"的组合架构——而不是在三者之间非此即彼地选择。这种分层设计思路在评估 AI 开发工具时的关键要点中同样有所体现:选工具之前先确认你的流水线层次,否则工具选型很容易走偏。
在可观测性维度上,三条路线的差距值得重点关注。DAG 流水线的节点级可观测性来自其天然的有向图结构,但单智能体方案和混合流水线都需要主动集成链路追踪(Trace)能力。工程上,建议使用兼容 OpenTelemetry 标准的追踪方案,无论底层选择 Langfuse、Weights & Biases 还是自建 Collector,追踪数据的 Schema 保持统一是日后迁移的前提。
场景推荐:根据你的实际处境选择路线
如果你是一个 3-5 人的营销团队,主要生产社交媒体内容和 SEO 文章,暂无专职工程师,选路线 A。从参数化提示词模板入手,把品牌 Tone of Voice、目标关键词、渠道格式都抽成变量,先跑通一条,再横向复制到其他内容品类。初期不要试图覆盖所有场景,先让一条流水线真正稳定运行,是比同时启动多条更务实的策略。
如果你的团队有工程支持,且需要每月批量生产数百条产品描述、邮件序列或多语言内容,选路线 B。在设计 DAG 拓扑时,将"内容类型"设计为可插拔的子图,而非硬编码进主流程,这是提升可复用性的关键架构决策。
如果你所在的行业有严格的合规要求,或者你的品牌处于高曝光阶段、内容发布风险较高,选路线 C。重点不在于智能体部分的设计,而在于人工介入点的标准化——把审核标准写成结构化清单,而不是依赖审核者的个人经验,这是这条路线能否规模化的核心。
如果你已经运行了一段时间的路线 A,发现瓶颈出现在并发量或复杂任务拆解上,可以考虑将路线 A 的主控节点迁移为路线 B 的 DAG 编排,同时保留路线 A 的参数化提示词模板作为每个 DAG 节点的执行逻辑。这种渐进式迁移比一次性重写代价小得多。
路线 A 的主要局限是上下文窗口瓶颈和并发能力;路线 B 的主要局限是初始设计成本和拓扑刚性;路线 C 的主要局限是人工等待时间带来的吞吐量约束。三条路线都没有"致命缺陷",选错的代价通常来自于对自身团队能力和内容生产规模的误判。
ALT: 营销团队根据规模、内容类型与风险等级选择智能体流水线路线的决策树对比示意图
常见问题
Q1:如何判断一条营销智能体流水线是否真的"可复用",而不只是看起来能跑?
可复用性的核心检验方式是:将流水线中的品牌名、目标渠道、语种、内容类型替换为另一个品类的参数,不修改任何工具调用逻辑或节点依赖关系,看输出质量是否仍然合格。如果每次复用都需要重新调试提示词结构或修改数据 Schema,说明流水线设计本身存在耦合问题,需要回到参数化设计层面重构,而非在输出层打补丁。
Q2:营销团队是否需要专职工程师才能维护智能体流水线?
不是必须的,但取决于你选择的路线。路线 A(单智能体 + 工具调用)在参数化设计完成后,非工程背景的运营人员通常可以独立调整提示词模板和内容变量,无需工程介入。路线 B(DAG 流水线)的拓扑修改则需要工程背景。路线 C(人机协作混合流水线)的维护重心在于人工介入点的标准化清单,运营人员可以主导维护。选型时评估团队能力,比选型后依赖外部工程支持更可持续。
Q3:从零开始搭建一条营销智能体流水线,大概需要多少时间才能进入稳定运行状态?
时间跨度因路线和团队能力差异较大,但一个共性的规律是:从第一次可运行原型到真正稳定的生产级流水线,通常需要经过至少两到三轮完整的"跑通-发现问题-修复-再跑通"循环。在我们持续观察的团队实践中,路线 A 的这个过程通常在数周内完成,路线 B 则需要更长的初始设计周期。关键不在于追求更快,而在于在每个循环中建立可观测性机制,让问题可被发现、可被定位,而不是靠肉眼排查输出结果。
总结
营销智能体流水线的核心价值不在于"AI 能做什么",而在于"这套系统能不能在三个月后还被你的团队稳定运行"。本文提炼的三条路线——单智能体工具调用、DAG 确定性流水线、人机协作混合流水线——分别针对不同的团队规模、内容生产节奏和风险容忍度。
三个关键判断点值得反复确认:第一,可复用性必须在设计阶段通过参数化实现,而非在输出层靠人工打补丁;第二,可观测性不是锦上添花,是流水线进入生产环境的前提条件;第三,维护成本的主体决定于你的团队构成,而非工具本身的能力。
下一步行动建议:选择与你当前团队规模和内容生产量最匹配的路线,先跑通一条,观察两到三个完整的迭代周期,再考虑扩展至其他路线的组合。不要在第一阶段就试图构建"完美"的全栈智能体系统——可复用的方法论从单点成功开始积累,而不是从宏大设计开始推导。
如果这篇文章对你有启发,欢迎订阅 Darius(Darius)——这是一份由真实 AI 产品构建者撰写的双语简报,每期精选 5–10 条锚定一手信源的 AI 动态,并附上来自生产环境的实战解读。无论你正在选型、调优还是扩容,Darius 帮你把噪音过滤掉,只留下真正值得关注的信号。
参考来源
- OpenTelemetry Project. "OpenTelemetry Specification".
https://opentelemetry.io/ - Apache Software Foundation. "Apache Airflow Documentation".
https://airflow.apache.org/ - IEEE. "IEEE Standards for Artificial Intelligence — Systems Engineering and AI".
https://www.ieee.org/ - NIST (National Institute of Standards and Technology). "AI Risk Management Framework".
https://www.nist.gov/ - ACM (Association for Computing Machinery). "Principles of Responsible AI Engineering".
https://www.acm.org/