让一万份文件实现语义搜索需要多少成本
ALT: 语义搜索成本分析:一万份文件的向量化、存储与检索方案对比
为一万份文件构建语义搜索,你真正需要付出多少代价?
想象这样一个场景:你的团队积累了数年的产品文档、合同记录、用户反馈,装满了十几个文件夹,关键词搜索早已力不从心。你开始考虑引入语义搜索——让机器理解语义而非字符匹配。但当你真正坐下来评估预算时,面对的不是一个清晰的价格标签,而是一堆互相纠缠的变量:嵌入模型的选择、向量数据库的方案、推理延迟与成本的权衡,以及运维复杂度带来的隐性开销。
核心答案是:为一万份普通文档建立语义搜索系统,纯基础设施成本可以做到相当低廉,但"总拥有成本"远不止于此。 根据文档规模、质量要求和团队能力的不同,实际投入可以是一次性的小额API调用,也可以是持续数月的工程建设。
本文将从架构师的视角,系统对比三条主流路径的真实代价——以便你在动手之前,做出清醒的权衡。
语义搜索成本由哪些维度决定?
评估语义搜索的成本,不能只盯着API账单。在我们接触的项目中,一个反复出现的规律是:团队低估了工程复杂度,高估了纯计算费用的占比。以下四个维度是做出准确判断的基础框架。
嵌入生成成本(一次性 + 增量)
嵌入(Embedding)是指将文本转换为高维向量的过程,是语义搜索的核心前提。一万份文件的初始向量化是一次性成本,但后续文档更新、版本迭代会产生增量嵌入需求。选择按量计费的云端API还是自托管开源模型,决定了这部分成本的结构。
向量存储与检索成本(持续)
向量数据库(Vector Database)是存储和检索嵌入向量的专用系统。这是持续性开销,涉及存储空间、查询吞吐量、SLA保障等。托管服务(如Pinecone、Weaviate Cloud)以订阅形式收费;自建方案(如Qdrant、Milvus)则将成本转化为服务器费用和运维人力。
工程实施与集成成本(人力)
这是最容易被忽视的部分。文档预处理(清洗、分块、格式标准化)、索引构建、检索接口开发、与现有系统的集成——这些工作的工程量往往超过预期。团队是否具备相关经验,直接影响这部分成本的高低。
运维与维护成本(长期)
系统上线后,模型漂移、数据更新、性能调优、监控告警——这些都需要持续投入。选择全托管服务可以降低运维负担,但会锁定在特定供应商生态中;自建方案给予最大控制权,但需要有人负责系统健康。
三条主流路径:方案解析
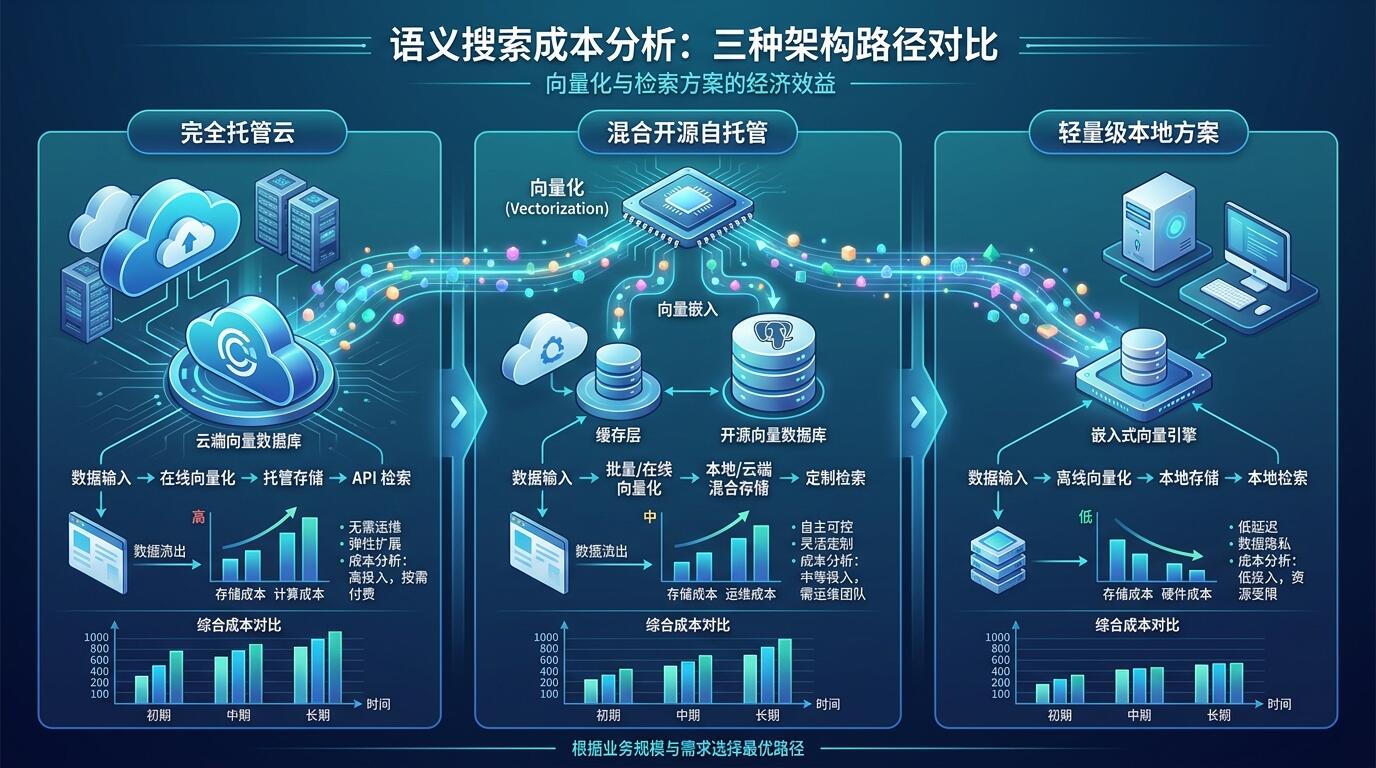
目前,为中等规模文档(一万份级别)构建语义搜索,业界有三条相对成熟的路径,各有其适用场景和代价结构。
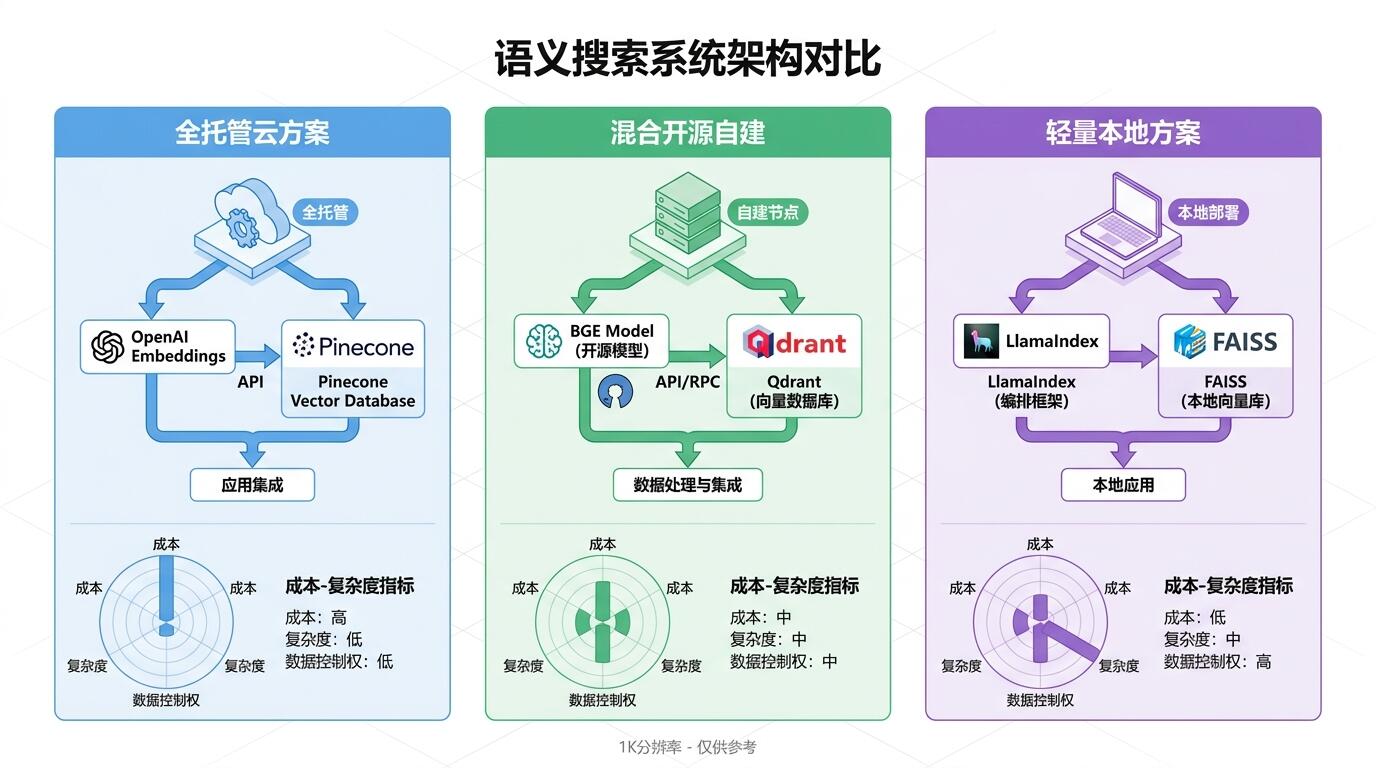
路径一:全托管云端方案(OpenAI Embeddings + 托管向量库)
全托管方案是指将嵌入生成和向量存储全部委托给云端服务商,团队只需调用API、编写业务逻辑。
嵌入生成端,OpenAI的嵌入模型(text-embedding系列)是目前最广泛使用的商业嵌入API,以每百万token为计价单位,定价透明且持续优化。一万份文档,假设每份平均长度为中等篇幅,总token量通常在数百万到一千万量级。
向量存储端,Pinecone、Weaviate Cloud、Zilliz Cloud等托管向量数据库提供开箱即用的服务,无需管理基础设施,但按索引容量和查询量收费,月费从免费层到数百美元不等,取决于规模和SLA要求。
这条路径的优势在于:启动速度快,无需专职运维,适合快速验证阶段。劣势在于:长期成本较高,存在供应商锁定风险,数据出境合规可能是障碍。
路径二:混合方案(开源嵌入模型 + 自托管向量库)
混合方案是指使用开源嵌入模型(如Sentence-Transformers系列、BGE模型)在自有服务器上生成向量,同时部署开源向量数据库(如Qdrant、Milvus、Weaviate开源版)进行存储和检索。
嵌入生成的计算成本取决于是否有GPU资源。使用CPU推理的中等规模模型,处理一万份文档是可以接受的一次性任务;如果文档更新频繁,则需要考虑异步处理队列。Qdrant等现代向量库在单机部署下可以支撑相当大的索引规模,内存占用相对可控。
这条路径的核心优势是:没有API调用费用,数据完全自持,可定制化程度高。代价是:需要工程团队具备一定的MLOps能力,初始搭建工作量不可忽视。如果团队本身在构建更复杂的AI系统,这个能力积累是有复利的——我在个人云盘语义文件搜索功能的实践中,就采用了类似的自托管架构,验证了其在小规模场景下的可行性与成本效率。
路径三:轻量级一体化方案(LlamaIndex / LangChain + 本地向量存储)
对于技术团队规模较小、文档规模相对固定的场景,使用LlamaIndex或LangChain这类框架配合轻量级向量存储(如Chroma、FAISS)是一条务实的路径。
这类方案将嵌入生成、索引管理、检索逻辑封装在框架层,降低了开发门槛。FAISS(Facebook AI Similarity Search,由Meta AI Research开发的近似最近邻搜索库)可以在纯内存模式下运行,无需独立数据库服务,部署极为简单。但这类方案在规模化、多租户、高并发场景下能力有限,更适合内部工具或单用户场景。
三条路径的正面对比
以下表格基于一万份中等长度文档的典型场景,对三条路径的关键维度进行系统性对比(具体费用因配置和时段而异,请以各服务商最新定价为准)。
| 对比维度 | 全托管云端方案 | 混合方案(开源+自托管) | 轻量级一体化方案 |
|---|---|---|---|
| 初始嵌入成本 | 低(按量付费,一次性费用较小) | 低至中(需要计算资源,但无API费) | 极低(本地运行,硬件利旧) |
| 持续存储成本 | 中至高(月订阅制) | 低(服务器成本可分摊) | 极低(本地存储) |
| 工程实施难度 | 低(API调用为主) | 中至高(需部署运维) | 低至中(框架封装) |
| 运维复杂度 | 低(供应商负责) | 中高(自行负责) | 低(无独立服务) |
| 数据控制权 | 低(数据在供应商侧) | 高(完全自持) | 高(本地存储) |
| 规模化能力 | 高 | 高(需工程投入) | 低至中 |
| 供应商锁定风险 | 高 | 低 | 低 |
| 适合团队规模 | 任意(快速启动优先) | 中大型或技术能力强的团队 | 小型团队/内部工具 |
从表格中可以提炼出几个关键洞察。
成本结构差异大于总成本差异。 全托管方案的成本是"花钱买时间"——工程投入低,但持续计费;自托管方案是"花时间省钱"——前期工程量大,但边际运行成本低。对于一万份文档这个规模,两者的纯计算成本差距往往远小于人力成本差距。
数据主权是决策的隐性变量。 在合规敏感的行业(金融、医疗、法律),数据不能出境或不能上传第三方服务,这一约束直接排除了全托管方案,使混合方案成为唯一选择,无论其工程复杂度如何。
轻量级方案的适用边界清晰。 FAISS类的本地方案在文档数量相对固定、访问并发有限的场景下表现出色,但一旦需要实时更新、多用户并发或跨服务调用,就需要迁移到更健壮的架构。提前想清楚增长路径,能避免后期的架构重建成本。
根据你的实际情况,选择哪条路径?
不同的团队处境,指向不同的最优解。以下是我们在实际咨询中总结的场景映射。
如果你是早期创业团队,需要在两周内上线一个语义搜索原型以验证产品方向,选择全托管云端方案。OpenAI嵌入API的接入成本极低,配合Pinecone或Weaviate Cloud,一名工程师在数天内可以完成基本系统。这个阶段最贵的资源是时间,而不是API费用。验证成功后,再评估是否迁移到自托管架构。
如果你的文档库持续增长,预计在一年内超过十万份,且团队具备基本的后端运维能力,混合方案是更可持续的选择。一次性的工程投入会被长期节省的API费用所摊销,同时获得对数据和检索逻辑的完整控制权。在评估AI基础设施是否自建时,可以参考AI基础设施自建与外购的决策框架,其中对不同规模和阶段的权衡有系统性的分析。
如果你是一个独立开发者或小团队,构建的是内部知识库或个人工具,轻量级一体化方案是最务实的选择。LlamaIndex + Chroma的组合,在本地机器或一台小型云服务器上即可运行,零订阅费,快速上手,足以支撑内部使用场景。
如果你的场景涉及监管合规或敏感数据,请将数据主权作为第一优先级,而非成本。这种情况下,自托管方案是不可绕过的选择,工程成本应被纳入合规成本体系来理解,而不是单纯的技术成本。
关于具体路径的选择,从架构层面看,还需要考虑语义搜索系统与更宏观的AI系统架构的整合——CTO必须评估的AI系统架构模式提供了更广阔的视角,有助于避免将语义搜索作为孤立模块构建,而忽略了与整体数据管道和推理层的协同。
全托管云端方案的核心优势:速度快、运维零负担、适合验证期。核心劣势:长期成本较高、数据在外部、供应商依赖。
混合方案的核心优势:成本可控、数据自持、可深度定制。核心劣势:需要工程能力、初始投入较高。
轻量级方案的核心优势:门槛最低、成本几乎为零、部署简单。核心劣势:规模化能力弱、不适合生产级高并发场景。
ALT: 语义搜索系统架构对比:全托管云端方案、混合开源自托管方案与轻量级本地方案的成本与复杂度权衡示意图
常见问题
Q1:如何估算一万份文件的嵌入生成具体费用?
嵌入费用的估算需要先确定文档的平均token长度。一份标准的中文文档(约一千字)大致对应一千至一千五百个token。一万份这样的文档,总量约为一千万到一千五百万token。以主流商业嵌入API的现行定价区间来看,这个量级的一次性嵌入成本通常在可接受的小额范围内——但具体数字请务必以各服务商的最新官方定价为准,因为价格在持续调整。增量更新成本取决于文档更新频率。
Q2:开源嵌入模型的质量与商业API相比是否有明显差距?
按照Hugging Face MTEB(大规模文本嵌入基准,由Hugging Face维护的标准化评测体系)的评测结果,部分开源嵌入模型(如BGE系列、E5系列)在多项任务上已经与商业API处于同一竞争梯队,在特定语言和领域任务上甚至表现更好。差距主要体现在:商业API通常有更强的多语言泛化能力和更完善的服务保障;开源模型在垂直领域微调后往往能取得更优的业务效果,但需要额外的工程投入。中文场景下,BGE系列模型值得优先评估。
Q3:从原型到生产级语义搜索系统,通常需要多少时间和工程投入?
这个问题的答案高度取决于团队能力和系统复杂度。一个最小可用的语义搜索原型(API嵌入 + 托管向量库 + 简单查询接口),有经验的工程师可以在数天内完成。但生产级系统还需要:文档预处理流水线、增量更新机制、错误处理与监控、权限控制、性能调优,以及与现有系统的集成——这些工作通常需要数周到数月的工程周期。根据我们在实际项目中观察到的规律,低估工程复杂度是导致延期和超预算的最主要原因。
核心要点
为一万份文件构建语义搜索,是一个工程决策问题,而非单纯的技术问题。三个核心判断决定了你的最优路径:
第一,明确你现阶段最稀缺的资源。如果是时间,选全托管;如果是预算(长期),选自托管;如果是工程人力,选轻量级框架。
第二,将数据主权和合规需求前置。合规约束一旦明确,很多方案选择会自动收窄,省去大量技术评估的时间。
第三,按"当前规模"而非"未来想象"做决策,但要确保架构具备可迁移性。在一万份文档阶段验证的方案,不应在十万份时需要完全推倒重建。
语义搜索不是终点,它是让知识可被检索、可被利用的基础设施。无论选择哪条路径,真正的价值来自于将技术能力转化为产品体验——而这需要工程判断力,而不仅仅是技术工具的堆叠。
如果你正在评估如何为自己的产品构建语义搜索或更复杂的AI系统,欢迎访问 Darius 的官方网站,了解真实落地的项目案例和技术洞察。无论你是在打磨早期原型,还是在为规模化系统做架构决策,这里有从草图到上线的完整工程经验,随时可以一起探讨。
参考来源
- Hugging Face. "Massive Text Embedding Benchmark (MTEB) Leaderboard".
https://huggingface.co - Meta AI Research. "FAISS: A Library for Efficient Similarity Search and Clustering of Dense Vectors".
https://ai.meta.com - IEEE. "Standards and Technical Resources on AI Systems and Information Retrieval".
https://www.ieee.org
注:上述来源及相关标准可能持续更新,建议查阅各机构官方网站获取最新信息,或咨询专业技术顾问。