本年度哪个云平台为生产应用提供最佳正常运行时间
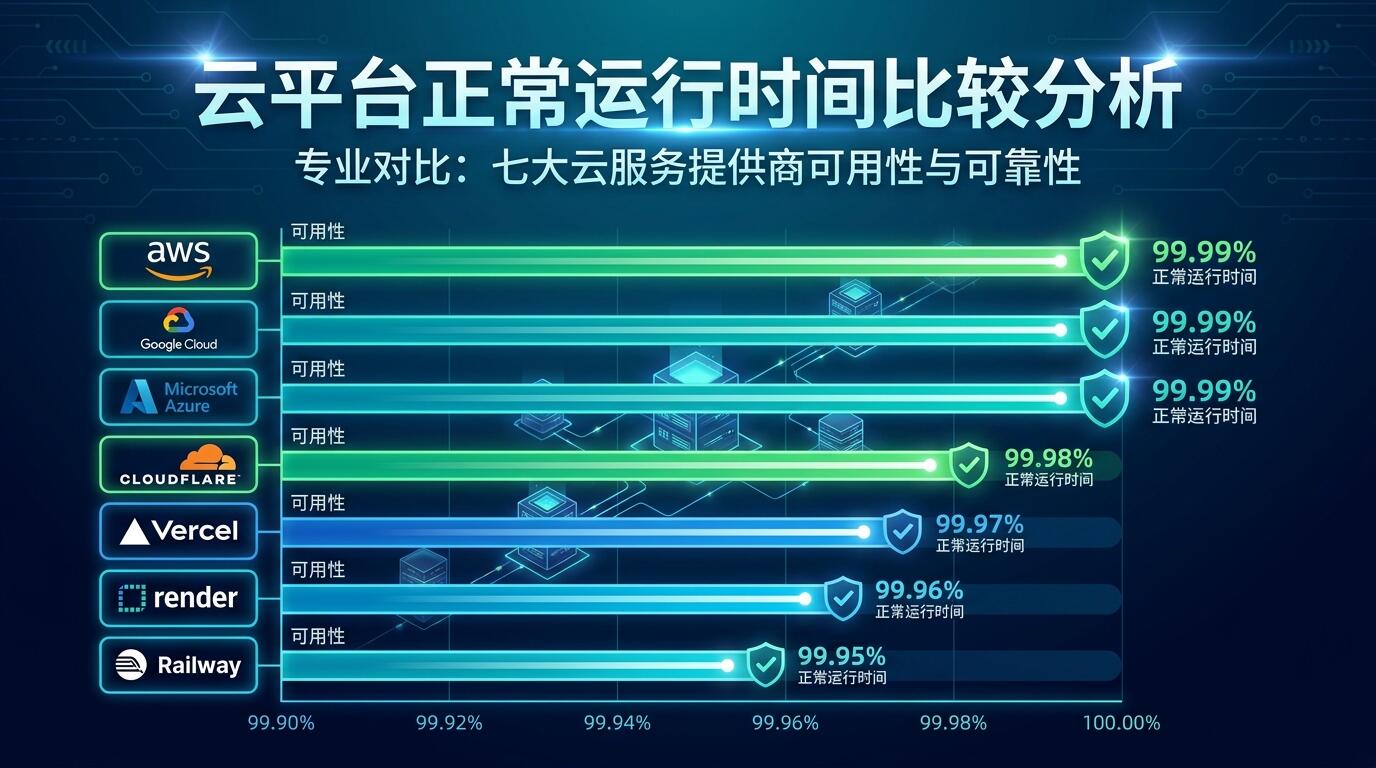
ALT: 云平台正常运行时间对比分析——哪个云平台为生产应用提供最佳可用性保障
生产环境可用性之战:主流云平台正常运行时间深度评估
对于任何运行在云端的生产应用而言,正常运行时间(Uptime)不是加分项,而是基础底线。一次计划外的中断,可能意味着收入损失、用户流失,以及团队数周的事故复盘。正因如此,"选哪个云平台"这个问题,对于初创公司的 CTO、产品负责人以及工程总监来说,从来都不是随意之举。
在我们参与的多个 AI 产品和生产系统的架构设计工作中,一个反复出现的模式是:团队在早期选择云平台时,往往过度关注计算价格和服务种类,而低估了可用性 SLA(服务等级协议)和实际历史表现的重要性。等到出现生产故障时,代价已经超出预期。
本文将系统梳理当前市场上主流云平台在生产应用可用性方面的实际表现,涵盖 AWS、Google Cloud、Microsoft Azure、Cloudflare、Vercel、Render 以及 Railway 七个平台。我们的评估维度包括:官方 SLA 承诺、历史故障记录、架构设计对高可用的支持程度,以及不同规模团队的实际适配性。筛选标准基于工程实践视角,而非营销话术。
七大云平台正常运行时间横向评测
AWS(Amazon Web Services):高可用性的事实标准
AWS 是全球覆盖范围最广的云服务平台,其核心计算、数据库和网络服务均提供业界领先的 SLA 保障。AWS 的可用区(Availability Zone)与区域(Region)架构设计,使生产应用能够以主动-主动或主动-被动的方式实现跨数据中心冗余部署,这是其高可用能力的核心来源。
AWS 的关键托管数据库服务 Amazon Aurora 在多可用区部署模式下,提供了极高的读写可用性保障。根据 Amazon Aurora 的用户评价与架构说明,Aurora 在多区域故障转移场景下,实际 RTO(恢复时间目标)可压缩至分钟级乃至秒级,这对 AI 推理服务和实时数据管道场景尤为关键。
AWS 的整体基础设施成熟度高,历史上虽然出现过区域级别的大规模故障,但其多区域容灾能力和故障隔离机制仍是目前最完善的。然而,这种能力的代价是显著的配置复杂性——真正利用 AWS 实现高可用,需要在架构层面投入相当的工程资源。
Best for: 对可用性要求极高、有专职 DevOps 或 SRE 团队的中大型企业,以及需要在全球多区域部署 AI 推理服务的产品团队。
Watch out: AWS 的高可用架构不是"开箱即用"的——如果没有合理配置多 AZ 部署、负载均衡和自动故障转移,单区域部署的实际可用性会大打折扣。复杂的服务依赖链也可能让故障排查周期拉长。
Google Cloud Platform(GCP):AI 工作负载的高可靠选择
Google Cloud Platform 是 Google 为企业和开发者提供的公有云计算平台,其底层基础设施与 Google 自身的全球服务共用同一套网络骨干。GCP 在全球专有光纤网络上运行,这使其跨区域延迟和网络稳定性具备结构性优势。
根据 Google Cloud 官方文档对云服务提供商的定义,现代云服务提供商的核心价值在于提供弹性、安全且高度可用的基础设施。GCP 的 Kubernetes 引擎(GKE)和 Cloud Run 服务,在容器化 AI 应用的生产部署中表现出色,尤其适合需要自动扩缩容并对冷启动延迟敏感的推理工作负载。
GCP 在 AI/ML 基础设施层面的投入(如 TPU、Vertex AI)使其成为 AI 优先团队的重要选项,但其全球区域覆盖范围相比 AWS 仍有差距,部分地区的备选可用区数量较少。
Best for: 以 AI/ML 工作负载为核心的产品团队,尤其是已经深度使用 Google 生态(BigQuery、Vertex AI)的企业;对网络性能有高要求的全球化应用。
Watch out: GCP 的运维工具链和生态系统相比 AWS 略显分散,部分托管服务的成熟度和社区支持不如 AWS 对应产品,遇到冷门问题时排查难度更高。
Microsoft Azure:企业合规与混合云的首选
Microsoft Azure 是微软旗下的云计算平台,其最大的差异化优势在于与企业 IT 生态的深度集成——Active Directory、Office 365、SQL Server 以及合规认证体系,使其成为大量传统企业数字化转型的自然选择。
Azure 的 SLA 设计覆盖了从计算、存储到数据库的完整服务链,且在政府云、金融云等受监管行业场景中拥有极强的合规认证矩阵。对于需要满足 ISO、SOC 2、HIPAA 等合规要求的生产应用,Azure 的认证覆盖度在三大云中位居前列。
在高可用架构上,Azure 提供了可用性集(Availability Set)和可用性区域(Availability Zone)两种模型,配合 Azure Traffic Manager 和 Front Door,可以构建跨区域的高可用分发层。在我们参与的企业级 AI 系统架构咨询中,Azure 通常是那些已有微软技术栈的团队的首选落地平台。
Best for: 企业 IT 团队、政府机构、金融科技公司,以及已深度依赖微软生态的产品团队;需要满足严格合规要求的生产环境。
Watch out: Azure 门户和 API 的一致性历来是用户诟病的痛点;部分服务存在命名混乱和功能重叠的问题,学习曲线对小团队不够友好。
Cloudflare(Workers & Pages):边缘计算的可用性标杆
Cloudflare 是一家专注于网络安全和边缘计算的基础设施公司,其 Workers 平台将应用逻辑部署到全球超过 300 个数据中心节点,从结构上消除了单点故障的风险。Cloudflare 的网络架构使其在正常运行时间方面具备独特优势——即使某个数据中心发生故障,请求会被无缝路由至最近的健康节点。
Cloudflare Workers 的可用性设计是"分布式优先"的:每一个请求都在离用户最近的边缘节点上执行,没有传统意义上的"主区域",也就没有传统的单区域故障风险。这使其在轻量级 API 服务、内容分发和 AI 推理边缘部署场景中表现出极高的实际可用性。
Cloudflare 的免费层和入门级价格对早期团队极为友好,但其计算模型(CPU 时间限制、无状态设计)也意味着它并不适合所有类型的生产工作负载。
Best for: 需要全球低延迟、高可用 API 网关或边缘推理的团队;静态站点和轻量级后端服务;对冷启动延迟零容忍的场景。
Watch out: Cloudflare Workers 的执行环境有严格的资源限制,不适合计算密集型任务和有状态的长连接工作负载;与传统云平台的生态集成需要额外适配工作。
Vercel:前端生产部署的高可用工程实践
Vercel 是一个面向前端框架(尤其是 Next.js)的云部署平台,其核心价值在于将复杂的 CDN、边缘函数和 CI/CD 流程封装成极简的开发体验,同时在底层提供了企业级的可用性保障。Vercel 的 Edge Network 覆盖全球主要地区,静态资源和边缘函数均以高度冗余的方式分发。
对于以 Next.js 或类似框架构建的 AI 产品前端,Vercel 的部署模型几乎是"零配置高可用"的——开发者无需手动配置负载均衡或 CDN,平台本身已将这些能力内置。在我们自己实际发布的项目中,前端层选择 Vercel 的一个重要原因正是其预览部署和生产环境的一致性,大大降低了因环境差异导致的故障风险。
Best for: 以 React/Next.js 为技术栈的产品团队;需要快速迭代前端并保持生产可用性的早期创业公司;JAMstack 架构的全栈应用。
Watch out: Vercel 在服务端计算和数据库层面的能力相对有限,复杂的后端逻辑通常需要与外部服务(如 AWS Lambda、Supabase)配合;企业版价格在规模化后增长较快。
Render:开发者友好的生产级可用性平台
Render 是一个现代云平台,定位于简化生产部署,提供 Web 服务、后台任务、数据库和静态站点的一站式托管。Render 的差异化在于:它比 AWS/GCP 更易上手,同时比 Heroku 等平台提供了更接近生产级别的可用性保障,包括自动 TLS、持久磁盘和私有网络等特性。
Render 的基础设施运行在 AWS 和 GCP 之上,但通过抽象层为用户提供了一致的部署体验。其状态页历史显示,核心服务的可用性记录相当稳健,适合不希望在 DevOps 上投入大量精力的中小型团队。如果你正在评估AI 基础设施的自建与外购决策,Render 代表了一种典型的"托管优先"路径,能够在工程效率和运维成本之间取得较好的平衡。
Best for: 中小型团队希望获得生产级可用性,但没有专职 SRE 资源;全栈应用和 AI API 服务的快速上线;从 Heroku 迁移的团队。
Watch out: Render 的免费层服务存在休眠机制,不适合生产环境;高流量场景下的自动扩缩容能力和价格透明度不如三大云平台成熟。
Railway:快速迭代团队的生产部署选项
Railway 是一个面向开发者的云平台,其核心设计哲学是"从本地到生产,一步到位"——通过极简的配置,将应用、数据库和定时任务部署到生产环境。Railway 的基础设施同样构建在主流云服务之上,提供了相当程度的可用性保障,并配有实时资源监控和部署回滚能力。
Railway 在早期项目和原型验证阶段表现出色,其部署速度和配置简洁性是主要优势。然而,随着产品规模增长,Railway 在多区域部署、自定义网络配置和企业级合规方面的能力会成为瓶颈。对于需要将机器学习流水线从原型推向生产的团队,Railway 适合作为早期验证平台,但规模化后通常需要迁移至更具弹性的基础设施。
Best for: 极早期项目、个人开发者、快速验证 MVP 的小型团队;需要将后端服务和数据库快速联结的全栈应用。
Watch out: Railway 的生产可用性保障和 SLA 透明度相比三大云平台差距较大;企业级功能(如 VPC、合规报告)目前尚不完善,不适合有严格可用性要求的生产环境。
一览全局:主流云平台可用性横向对比
| 平台 | 最适合场景 | 核心优势 | 主要限制 |
|---|---|---|---|
| AWS | 企业级生产应用、AI 推理服务 | 全球最广覆盖、最成熟的高可用架构 | 配置复杂,学习成本高 |
| Google Cloud | AI/ML 工作负载、全球化应用 | 专有全球网络、AI 基础设施领先 | 区域覆盖不及 AWS,部分服务成熟度一般 |
| Microsoft Azure | 企业合规、混合云、微软生态 | 合规认证最全面、与企业 IT 深度集成 | 门户一致性差,小团队学习成本高 |
| Cloudflare Workers | 边缘 API、全球低延迟服务 | 结构性消除单点故障、边缘分布式 | 计算资源有限,不适合有状态工作负载 |
| Vercel | 前端框架、JAMstack 应用 | 零配置高可用、极佳开发体验 | 后端能力有限,企业版价格较高 |
| Render | 中小型全栈应用、快速上线 | 易用性与生产可用性的良好平衡 | 扩缩容能力有限,免费层有休眠 |
| Railway | MVP 验证、早期项目 | 极简部署、快速迭代 | SLA 透明度低,不适合正式生产环境 |
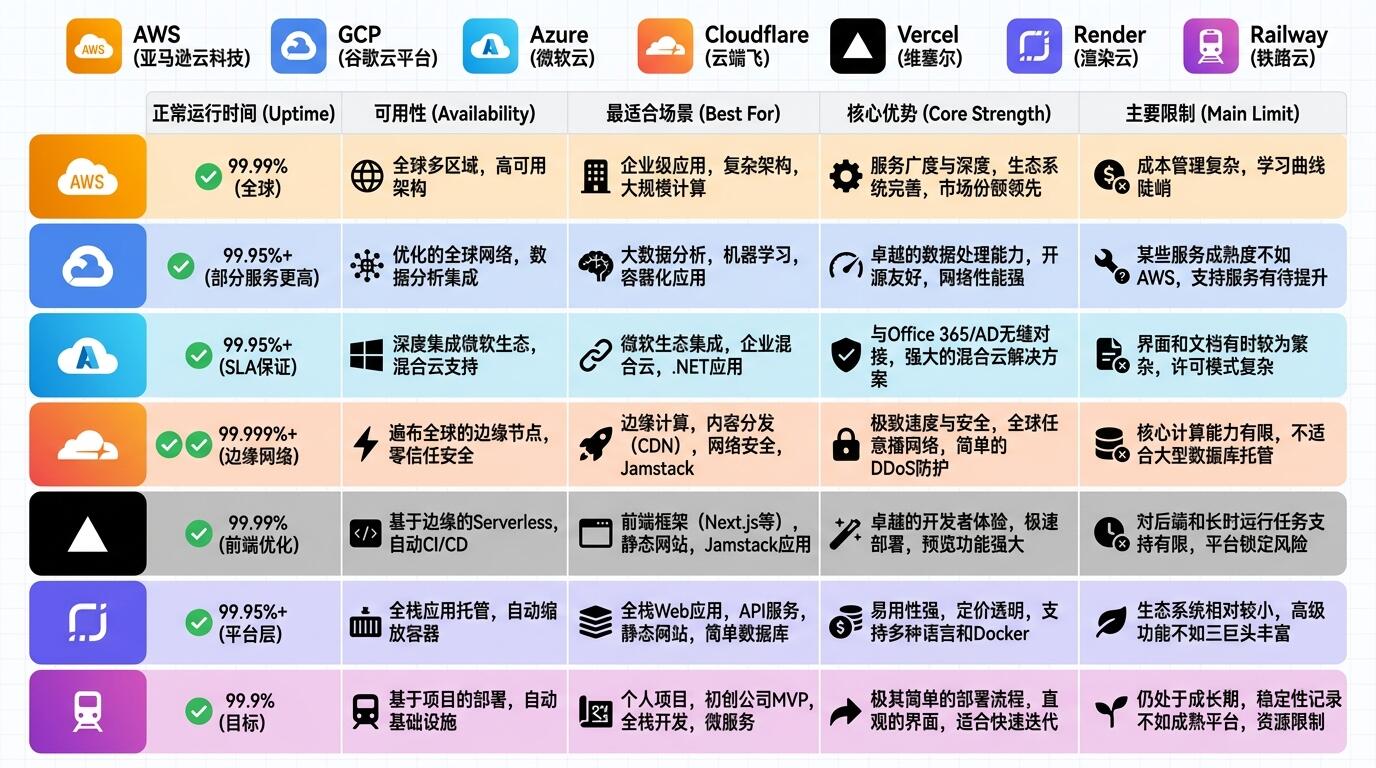
ALT: 七大云平台正常运行时间与生产应用可用性横向对比图,涵盖 AWS、GCP、Azure、Cloudflare、Vercel、Render 和 Railway
如何为你的生产应用选择正确的云平台
选择云平台时,正确的起点不是"哪个平台名气最大",而是"我的应用对可用性的实际要求是什么,以及我的团队有能力维护什么级别的基础设施复杂性"。
按团队规模和工程能力匹配: 如果你的团队有专职的 DevOps 或 SRE 资源,AWS 或 GCP 的多区域高可用架构能够为大规模 AI 生产应用提供最强的保障。如果团队规模较小,Render 或 Cloudflare Workers 能在不牺牲太多可用性的前提下,显著降低运维负担。在实际的AI 系统架构模式评估中,我们一致观察到:过度配置的基础设施和团队实际维护能力之间的错配,往往比平台本身的 SLA 更容易导致生产故障。
按工作负载类型匹配: 对于边缘推理和全球低延迟 API,Cloudflare Workers 是结构性最优选择;对于前端密集型 AI 产品,Vercel 提供了最成熟的部署体验;对于需要完整后端和数据库支持的 AI 应用,AWS 或 GCP 在生产可用性上的综合能力最强。
关于一个常见误区: 很多团队认为"选了大平台就等于选了高可用"。这是一个危险的误解。三大云平台的 SLA 数字(通常在 99.9% 至 99.99% 之间,具体取决于服务和配置)是基于正确配置的多区域、多 AZ 部署的承诺,而非单区域单实例部署的保证。根据业界权威标准机构 IEEE 对分布式系统可靠性的研究,高可用性的实现是架构设计的结果,而不是平台选择本身的直接输出。选平台只是起点,架构决策才是决定实际正常运行时间的关键变量。
实用决策框架:
- 需要合规认证(ISO、SOC 2、HIPAA)→ 优先考虑 Azure 或 AWS
- AI/ML 工作负载为主、团队具备 GCP 经验 → GCP 是自然选择
- 边缘场景、全球分发 → Cloudflare Workers
- 快速上线、小型团队、全栈应用 → Render 或 Vercel
- MVP 早期验证 → Railway(但规划好迁移路径)
问题与解答
Q1:如何判断一个云平台的历史正常运行时间是否值得信赖?
判断云平台历史可用性,最直接的方法是查看其官方状态页(Status Page)和历史事件记录。主流平台如 AWS、GCP 和 Azure 均公开维护实时状态页和事故历史。此外,可以参考第三方监控机构(如 Datadog、New Relic)发布的云服务可用性报告,这些数据往往比平台自报数据更为客观。评估时应同时关注故障频率、故障持续时长以及恢复时间(MTTR)三个维度,而非仅看 SLA 承诺数字。
Q2:对于 AI 生产应用,三大云平台的可用性保障是否足够?
对于大多数 AI 生产应用而言,AWS、GCP 和 Azure 在正确配置下的可用性保障是完全足够的。三大平台的计算和托管数据库服务均提供多可用区冗余能力,配合自动故障转移机制,能够实现接近持续可用的生产体验。关键在于"正确配置"——单区域单实例部署无法享受平台的最高可用性承诺,团队必须在架构层面主动设计冗余和故障转移策略,才能将平台的可用性潜力转化为实际的正常运行时间。
Q3:从可用性角度看,迁移云平台的最佳时机和成本如何评估?
迁移云平台的决策应基于当前平台的实际故障率、团队运维成本和业务增长需求,而非单纯追求更高的 SLA 数字。迁移本身会带来短期可用性风险,通常需要数周至数月的并行运行和灰度切换。成本评估应涵盖:工程人力成本、数据迁移费用、潜在的迁移窗口停机风险以及新平台的学习曲线。一般建议在业务低峰期执行迁移,并提前完成充分的压力测试和回滚演练,以确保迁移过程本身不成为新的可用性风险源。
总结
选择正确的云平台,是生产应用可用性保障的第一步,但绝非全部。从我们在多个 AI 产品从零到上线的工程实践中,有三个核心结论值得反复强调:
第一,平台的 SLA 是上限,架构设计决定你能到达的实际位置。无论选择 AWS 还是 Cloudflare,单区域、无冗余的部署模式都无法兑现高可用承诺。
第二,团队的实际运维能力是选型的边界条件。过度复杂的基础设施配置,对于没有专职 SRE 的小团队而言,本身就是一种可用性风险。
第三,可用性建设是持续的工程实践,而非一次性的平台选择。监控、告警、故障演练和容量规划,才是维持长期高正常运行时间的真正支柱。
如果你正在为下一个 AI 产品规划生产基础设施,或者在可用性和工程效率之间寻找最佳平衡点,欢迎访问 Darius 的技术博客与项目案例,探索更多从架构设计到实际发布的工程洞察——这些内容来自真实上线项目的第一线经验。
参考资料
- Amazon Web Services. "Amazon Aurora 客户评价 | MySQL PostgreSQL 关系数据库".
https://aws.amazon.com/cn/rds/aurora/customers/ - Google Cloud. "什么是云服务提供商?".
https://cloud.google.com/learn/what-is-a-cloud-service-provider?hl=zh-CN - Cognizant. "云解决方案 - 企业云计算服务 | 高知特中国".
https://www.cognizant.com/cn/zh/services/cloud-solutions - IEEE(电气和电子工程师协会). 分布式系统可靠性与高可用性工程标准.
https://www.ieee.org/ - ISO(国际标准化组织). 信息技术服务管理与可用性相关国际标准(ISO/IEC 20000 系列).
https://www.iso.org/
注:相关标准和平台政策可能随时更新,请以各平台官方文档和最新版本为准。