技术面试中评估AI工程能力的实用框架
ALT: 技术面试中评估AI工程能力的实用框架,帮助团队识别真正具备AI落地能力的工程师
为什么传统面试框架无法有效评估 AI 工程能力
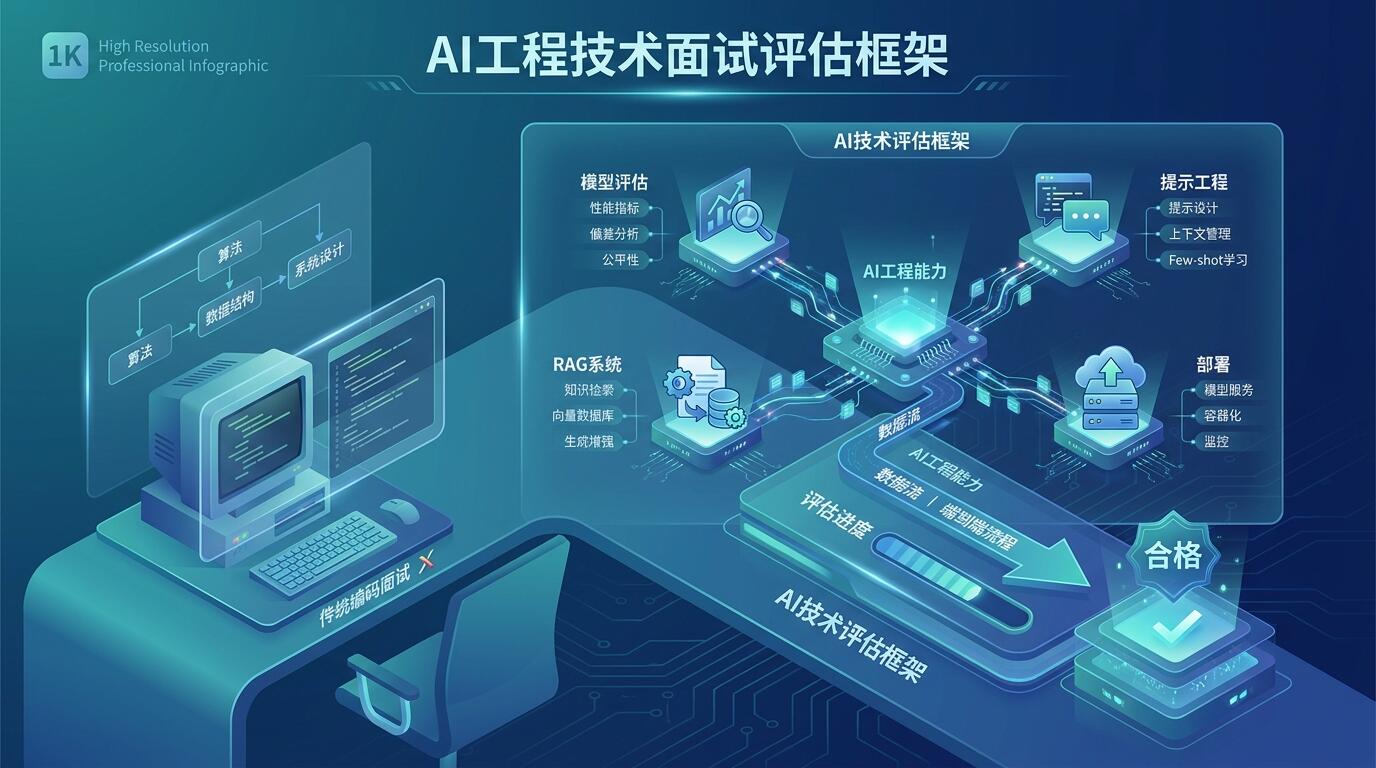
在招聘工程师时,大多数团队沿用的仍是十年前的面试套路——算法题、系统设计白板、代码风格审查。这套框架在评估传统后端或前端工程师时尚算有效,但面对今天 AI 工程(AI Engineering)这一新兴岗位,它几乎完全失效。
AI 工程师不仅需要会写代码,更需要理解模型推理链路、数据管线、提示词工程、评估体系与工程可靠性的整体权衡。在我们与多个技术创业团队合作的过程中,反复看到同一个模式:团队招到了一位能在 LeetCode 上拿满分的候选人,却发现他完全不知道如何设计一个稳定上线的 RAG(检索增强生成)系统。
本文提供一套务实的 AI 工程能力评估框架,帮助技术负责人、创始人与工程总监在面试中识别真正具备 AI 落地能力的人才。比较对象是两类主流面试方法:传统技术面试方法(算法 + 系统设计)与AI 工程专项面试方法(AI 架构 + 落地能力)。评判维度涵盖评估效度、覆盖关键能力、与岗位的实际相关性,以及对候选人的区分度。
评估维度:判断一套框架是否真正有效
一套面试框架是否值得信赖,取决于它能否真正度量岗位所需的能力,而不仅仅是候选人的刷题技巧。以下六个维度是我们用来评判两类方法的标准。
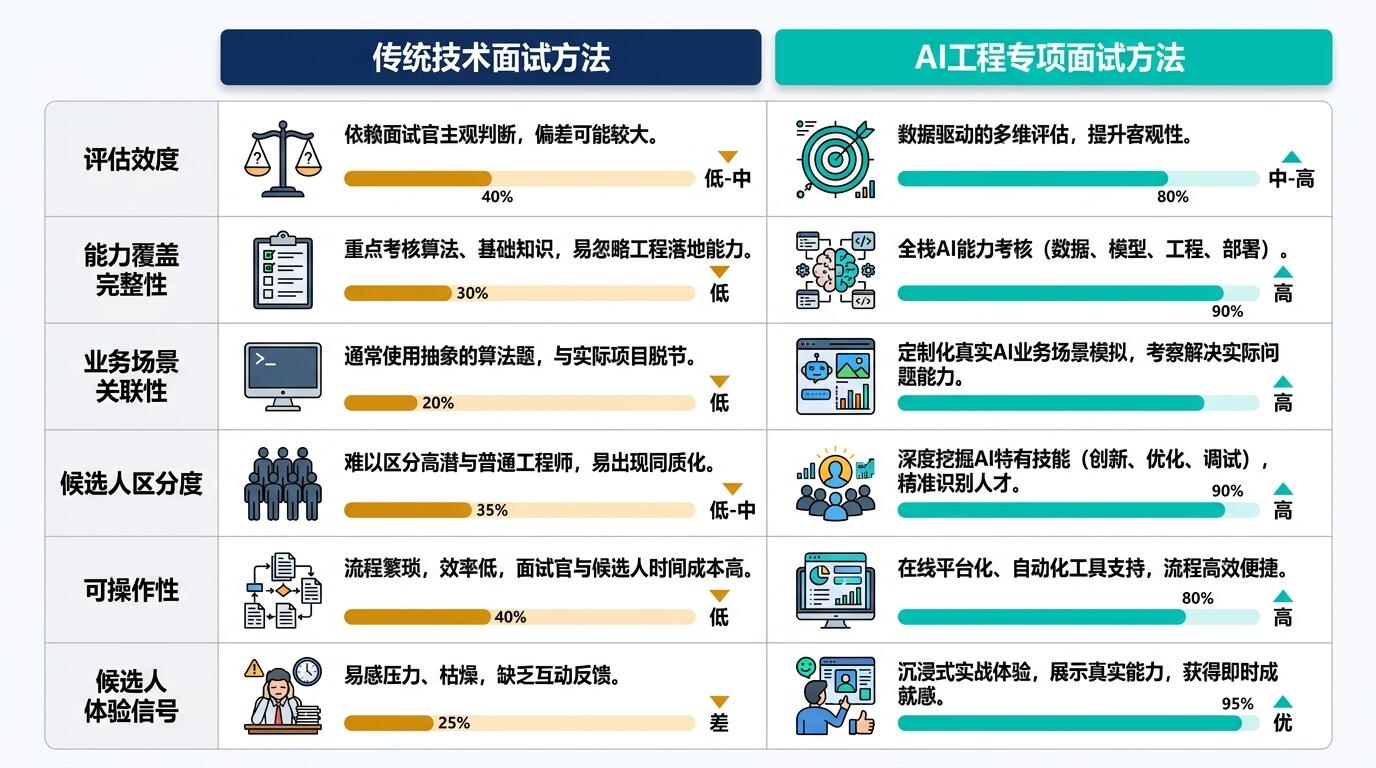
评估效度(Validity) 是最核心的维度。面试题目是否真实反映了候选人在岗位上会遇到的问题?如果题目与日常工作相差甚远,面试分数对实际表现的预测力就几乎为零。
能力覆盖的完整性 是第二个关键。AI 工程岗位横跨多个子领域:模型选型与评估、Prompt Engineering、向量数据库与检索、数据清洗与特征工程、部署监控与成本控制。一套评估框架必须能覆盖足够多的子领域,才能避免"单点盲区"。
与业务场景的关联性 决定了面试是否有现实意义。候选人解决的是抽象的"树形结构遍历",还是"如何在成本约束下让 LLM 输出更稳定"?前者与 AI 工程实践几乎脱节。
候选人区分度 是第四个维度。一套好的框架应当能有效区分"会聊 AI"与"能落地 AI"的候选人,避免让善于准备面试的人蒙混过关。
评估的可操作性 同样重要。框架是否能在有限的面试时间内高效执行,不依赖极其昂贵的专项环境搭建?对于初创团队而言,这一点尤为现实。
候选人体验与信号反馈 作为最后一个维度,评估框架本身也在向候选人传递信号——它体现了团队的工程成熟度与思维方式,能吸引或筛选掉不同类型的工程师。
两类面试方法的详解
传统技术面试方法:算法 + 系统设计
传统技术面试方法是指以算法题(如 LeetCode 风格题目)和系统设计(如"设计一个 URL 短链服务")为核心的面试体系。这一方法由大型科技公司(FAANG)在早期确立,随后扩散至整个行业。
它的优势在于:标准化程度高、面试官易于打分、能有效筛选基础编程能力与计算机科学基础。对于基础设施、编译器、数据库等领域的工程师,这套方法仍然相当有效。
然而对于 AI 工程岗位,传统方法存在显著短板。它无法覆盖模型评估、提示词优化、向量检索等核心能力;系统设计题通常假设确定性系统,而 AI 系统本质上是概率性的,设计逻辑完全不同;算法题的刷题程度与候选人的 AI 工程实践能力之间,关联性极弱。
典型信号:我们在与初创团队合作时发现,团队通过传统面试招到的"优秀候选人",往往在第一次被要求构建 AI Agent 时就陷入茫然——不知道如何处理 LLM 的输出不稳定性,也不知道如何设计评估管线来验证模型效果。
AI 工程专项面试方法:AI 架构 + 落地能力
AI 工程专项面试方法是一套以 AI 系统的设计、实现与上线能力为核心的评估框架,关注候选人在真实 AI 工程场景中的判断力与动手能力。
这一方法的典型题型包括:设计一个端到端的 RAG(Retrieval-Augmented Generation)系统并说明评估策略;在给定成本约束下选择合适的模型与推理方案;分析一段 AI 系统的失败日志并提出改进思路;设计 Prompt 模板并解释背后的工程考量。
它的优势显而易见:与 AI 工程岗位的实际工作高度吻合,能够识别候选人是否有真实的落地经验,对"会说 AI"与"能做 AI"的候选人有较强的区分度。
这一方法的挑战在于:题目设计需要面试官自身具备较高的 AI 工程经验,标准化打分相对困难,且没有像算法题那样成熟的题库可以直接套用。对于 AI 团队建设的方法论,可以参考如何打造一支真正高效的全栈工程交付团队中关于岗位能力模型构建的思路,其中的框架对 AI 工程岗位同样适用。
ALT: 传统技术面试方法与AI工程专项面试方法的对比矩阵,涵盖评估效度、能力覆盖等六大维度,帮助技术团队做出正确的招聘决策
两类方法的正面对比
| 评估维度 | 传统技术面试方法 | AI 工程专项面试方法 |
|---|---|---|
| 评估效度 | 对传统工程岗位有效;对 AI 岗位效度低 | 与 AI 工程岗位的实际工作高度匹配 |
| 能力覆盖完整性 | 覆盖算法与基础系统设计;遗漏 AI 核心子领域 | 覆盖模型选型、Prompt、RAG、评估、部署等主要子领域 |
| 业务场景关联性 | 抽象题目与 AI 实践场景关联弱 | 题目直接来源于真实 AI 工程场景 |
| 候选人区分度 | 区分刷题能力;无法区分 AI 落地能力 | 能有效区分"懂原理"与"能落地"的候选人 |
| 可操作性 | 极高;有成熟题库与评分标准 | 中等;需要面试官有较强的 AI 工程背景 |
| 候选人体验信号 | 向候选人传递"传统工程文化"信号 | 向候选人传递"AI 原生工程文化"信号 |
传统方法的关键局限在于它对 AI 系统的概率性本质视而不见。传统系统设计假设输入确定则输出确定,而 LLM 的输出天然带有随机性,这意味着 AI 系统设计必须将评估体系(Evaluation Pipeline)作为一等公民来设计——而这在传统面试框架中几乎从未出现。
AI 工程专项方法的核心价值在于它迫使候选人暴露真实的工程判断力。当被问到"如果你的 RAG 系统在生产环境中出现大量低质量检索,你会如何排查和改进",候选人要么能给出具体的诊断步骤(检查 embedding 质量、调整检索窗口、引入重排序层),要么只能泛泛而谈。这种区分度是传统题目很难达到的。
根据 IEEE(电气和电子工程师学会)在软件工程能力评估领域的相关实践指南,有效的技术评估框架应当将"任务相关性"作为核心设计原则——即面试题目应当尽量模拟候选人在实际岗位中会遇到的真实工程决策。AI 工程专项方法在这一原则上具有天然优势。
根据团队情况选择正确的方法
面试框架的选择不是非此即彼的,而应当根据团队的具体情境做出判断。
如果你的团队正在招聘第一位 AI 工程师,并且团队内部尚无成熟的 AI 工程经验,那么完全采用 AI 工程专项方法存在一个现实障碍:你很难设计出高质量的 AI 专项题目,也很难准确评判候选人的答案。此时建议的做法是:在传统系统设计题的基础上,增加一道"开放式 AI 落地场景题",并将候选人的自我项目经历和解题思路作为主要参考依据。
如果你的团队已有 AI 系统在生产环境运行,那么应当采用以 AI 工程专项方法为主、传统方法为辅的组合策略。编程基础仍然重要,但主战场应在 AI 架构设计与评估体系的讨论上。考虑将候选人直接带入你们现有系统的真实问题来讨论,这比任何题库都更有区分度。
如果你是技术创始人,正在快速组建早期 AI 产品团队,优先考察候选人的"落地本能"——他过去是否把 AI 真正做成了产品,而不只是写过 Demo。此时,一个工程师如何将三个产品想法全部落地上线的实战思路,可以给你提供一个很好的参照视角,帮助你理解"从想法到上线"所需要的工程综合能力。
如果你是候选人本身,正在准备 AI 工程方向的面试,本文的框架也适用于反向准备:确保你能清晰阐述一个你亲手做过的 AI 系统的架构决策、评估策略,以及遇到的具体失败和如何修复它。
传统方法的优势场景:当岗位对基础设施能力要求极高(如大规模分布式系统、底层 ML 框架开发),或者团队本身尚无足够 AI 背景来评判专项题时,传统方法仍是更稳健的选择。
AI 专项方法的优势场景:当岗位的核心职责是设计和实现 AI 应用系统(RAG、Agent、多模态管线等),或者团队已有成熟的 AI 工程文化时,专项方法能带来更高信号密度的评估。
常见问题
Q1:如何在面试中设计有效的 AI 系统设计题?
有效的 AI 系统设计题应当包含三个要素:明确的业务约束(如成本上限、延迟要求)、真实的不确定性(如模型输出质量波动),以及对评估体系的要求。建议将题目建立在你们产品的真实问题之上,而不是从网络上套用通用题目。好的题目没有标准答案,考察的是候选人的工程判断链路和权衡意识。
Q2:AI 工程能力评估中,Prompt Engineering 是否应该单独考察?
Prompt Engineering 是 AI 工程能力的组成部分,但不应作为唯一或核心考察点。它更像是一种工具技能,而非决定候选人价值的核心能力。更重要的是候选人是否理解为什么要这样设计 Prompt——背后的推理链路管理逻辑、输出格式控制策略、以及如何在 Prompt 变化时设计回归测试。将 Prompt 能力嵌入更大的系统设计题中考察,效果优于单独设题。
Q3:AI 工程专项面试是否需要额外的准备成本?
相对于传统面试,AI 工程专项面试的准备成本确实更高,主要体现在题目设计和评判标准的制定上。建议团队提前整理自己产品中出现过的真实 AI 工程难题作为题目素材,并由有实际 AI 落地经验的面试官主导。如果团队尚无此类经验,可以考虑引入外部技术顾问参与面试设计,这一额外投入通常在早期招聘决策质量上会有显著回报。
总结与行动建议
评估 AI 工程能力的有效框架,其核心原则只有三条。
第一,题目必须与工作现实匹配。AI 工程师面对的是概率性系统、不稳定的模型输出和持续演化的评估需求,面试题目必须能够反映这种现实复杂性,而不是用确定性问题掩盖岗位的本质特征。
第二,区分"知道"与"做过"。候选人能流利讲述 RAG 原理是一回事,能在生产环境中设计一个稳定、可评估、可维护的 RAG 系统是另一回事。面试框架应当创造足够的压力来暴露这一差距,而不是让善于表达的候选人蒙混过关。
第三,框架本身要持续迭代。AI 工程领域的技术演进极快,今天的最佳实践可能半年后就需要更新。将面试框架视为一个需要维护的工程制品,定期根据岗位需求和行业动态进行修订。如果你希望深入了解如何系统性地制定 AI 产品落地路径,面向工程团队的 AI 产品路线图制定方法提供了一套结合团队节奏的实践框架,值得参考。
无论你是正在招聘的技术负责人,还是准备面试的 AI 工程师候选人,这套框架都能帮助你更清晰地定义"AI 工程能力"的真正边界——它不是对 AI 概念的熟悉程度,而是将 AI 真正构建成可运行产品的系统性工程能力。
如果你正在寻找一位能够将想法真正落地为产品的 AI 架构师与全栈技术专家,欢迎访问 Darius 的个人主页,了解更多真实项目案例与技术洞见。无论是 AI 系统设计、架构规划还是全栈开发,Darius 都能为你提供从 0 到 1 的专业支持与实战经验。
参考资料与延伸阅读
- IEEE(电气和电子工程师学会). "Software and Systems Engineering — Software Testing".
https://www.ieee.org/ - ACM(美国计算机学会). "Computing Competencies for Undergraduate Data Science Curricula".
https://www.acm.org/ - MIT(麻省理工学院). "Responsible AI and Machine Learning Engineering Practices".
https://www.mit.edu/
注:相关标准与最佳实践文档持续更新,建议查阅各机构官方网站获取最新版本,或咨询专业技术顾问以获取针对特定场景的建议。