开源模型与商用API对比:面向小团队的本季度选型手册
ALT: 小团队在开源大模型与商用API之间进行技术选型的工程师决策示意图
开源还是商用API:小团队今天该怎么选
对小团队而言,在开源模型与商用API之间做选择,本质上是一道资源分配题,而不是技术信仰题。当前大模型生态的成熟度已经让两条路都具备真实的可落地性——开源路线的门槛在持续降低,商用API的能力天花板也在快速抬升,两者的边界比一年前模糊得多。
本文比较的是四个主流选项:以 Meta Llama 系列和 Mistral 为代表的自托管开源模型,以及以 OpenAI GPT-4o、Anthropic Claude 和 Google Gemini 为代表的商用API服务。评估维度聚焦于对小团队真正重要的六个方面:成本结构、工程复杂度、性能基线、数据隐私、弹性扩展与长期维护负担。
选型的真正标准:小团队应该用什么维度衡量
选型框架必须从团队的实际约束出发,而非从模型的技术指标出发。我们在构建和运营AI产品的过程中反复观察到一个模式:团队在选型上栽跟头,往往不是因为选错了模型,而是因为用错了评估维度。以下六个标准是我们认为对小团队最具决策价值的。
成本结构 是最直接的约束。商用API的计费以token为单位,成本随用量线性增长;自托管开源模型的主要成本是GPU算力,属于固定或阶梯型支出。两种结构在不同用量规模下的盈亏平衡点差异显著。
工程复杂度 决定了你付出的隐性成本。商用API几乎没有基础设施负担;自托管方案需要处理模型部署、推理优化(量化、batching)、服务可用性保障等一系列工程问题,这些工作对于人员有限的小团队可能占用大量精力。
性能基线 在大多数通用任务上,顶级商用API仍领先于同等推理成本下的开源模型,但差距在特定垂直任务经过微调后会显著收窄。对于明确的、边界清晰的业务场景,这一差距往往可以接受。
数据隐私与合规 是一票否决项。某些场景下数据不能出域,无论商用API性能多好,都不在考虑范围内。这是驱动团队转向开源自托管的最常见的非技术原因。
弹性扩展 考验的是流量突增时的系统行为。商用API天然支持弹性扩展;自托管需要提前规划GPU资源,冷启动和排队问题需要自己解决。
长期维护负担 是最容易被低估的因素。开源模型需要持续跟进新版本、处理依赖升级、维护推理栈;商用API将这部分负担转移给服务商,但也意味着你依赖对方的API稳定性和定价策略。
当前主流选项概览
自托管开源模型:Llama 与 Mistral 系列
Meta 的 Llama 系列是目前开源生态中使用最广泛的基础模型族。Llama 3 系列提供从 8B 到 70B 不等的参数规模,覆盖从边缘推理到服务端部署的多种需求,并支持商用授权(需满足特定条件)。Mistral AI 的模型以更小的参数量实现了较强的指令跟随能力,其 Mistral 7B 和 Mixtral 8x7B(混合专家架构)在资源受限场景下表现突出。
开源路线的核心优势是:模型权重在你手里,数据不出域,推理成本在高用量下可以远低于商用API,并且可以针对特定任务进行微调。代价是:你需要自己承担部署、优化和运维的工程负担。对于没有专职MLOps工程师的小团队,这个代价需要认真评估。
在实际构建产品时,我们发现开源路线最适合以下情形:任务边界明确、可以通过少量微调数据显著提升效果,或者数据合规要求使得外部API不可用。
商用API:OpenAI GPT-4o、Anthropic Claude、Google Gemini
OpenAI GPT-4o 是目前综合能力最强、生态最成熟的商用模型API。其多模态能力(文本、图像、音频)和函数调用支持使其在构建复杂智能体流水线时具有明显优势。定价以输入/输出token分开计费,成本透明但在高频调用场景下累计较快。
Anthropic Claude(当前为 Claude 3.x 系列)在长上下文处理、指令遵循精准度和安全性方面有突出表现。其 200K token 的上下文窗口对于需要处理长文档的场景是实质性优势。Claude 在拒绝有害请求方面的一致性也优于部分竞品,对于面向普通用户的产品而言可以降低内容风险。
Google Gemini 系列(包括 Gemini 1.5 Pro/Flash)的核心差异化是其超长上下文窗口和与 Google 工作区生态的深度集成。Gemini Flash 在速度和成本上有明显优化,适合对延迟敏感、调用量较大的场景。
商用API路线的本质是:用钱换工程时间。你不需要管理推理基础设施,可以立即获得最新模型能力,但你的成本结构与用量强绑定,且在数据主权上存在让渡。
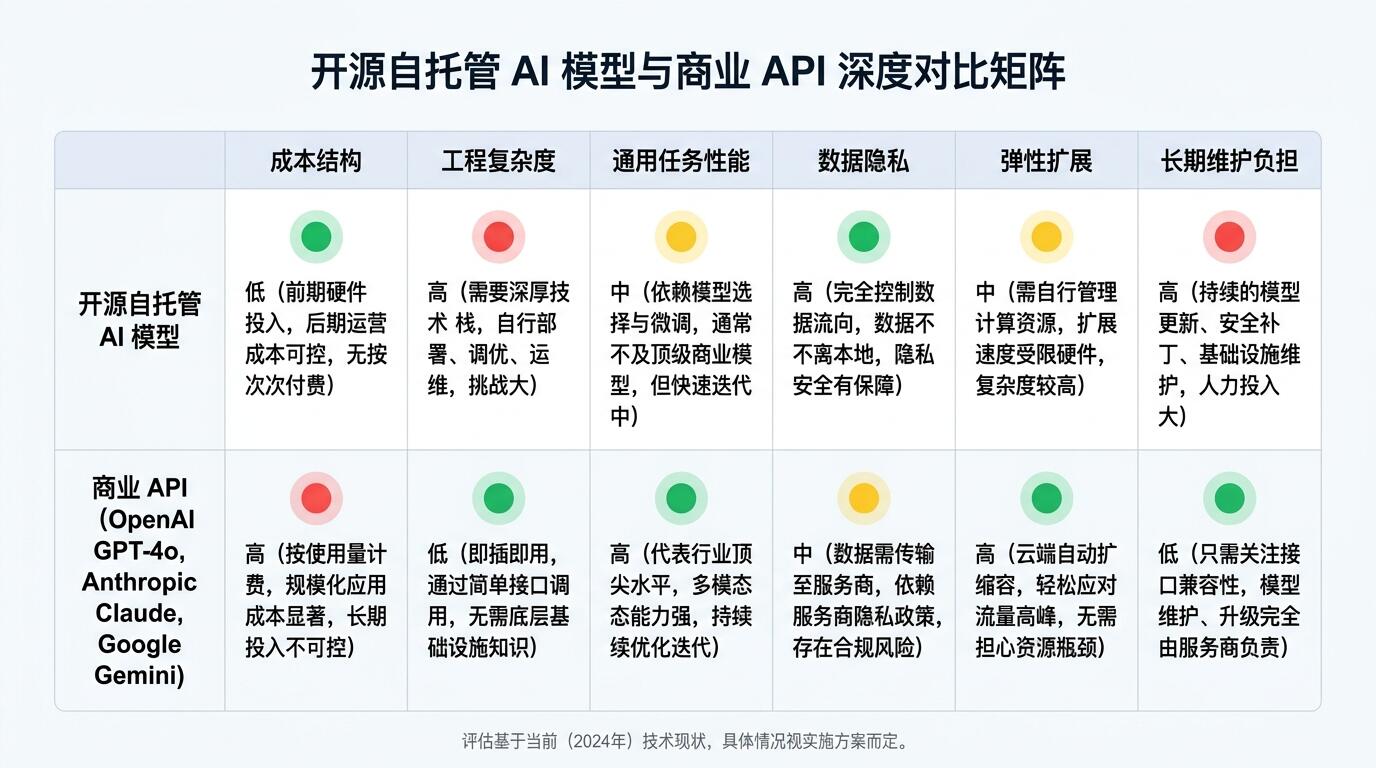
ALT: 开源大模型自托管方案与OpenAI、Claude等商用API在成本、性能、隐私、运维复杂度等维度的横向对比矩阵
六维横向对比:开源 vs 商用API
| 评估维度 | 开源模型(自托管) | OpenAI GPT-4o | Anthropic Claude | Google Gemini |
|---|---|---|---|---|
| 成本结构 | 固定GPU成本为主,高用量下有优势 | 按token计费,用量越大成本越高 | 按token计费,长上下文成本需注意 | 按token计费,Flash版本成本较低 |
| 工程复杂度 | 高,需自行管理部署、推理优化、可用性 | 低,REST API接入,数小时可上线 | 低,API接入体验与OpenAI相近 | 低至中,Google Cloud集成有一定学习曲线 |
| 通用任务性能 | 中等(70B量级接近GPT-4级别,小参数量有差距) | 高,当前综合评测领先 | 高,长文档和指令遵循尤为突出 | 高,超长上下文为核心优势 |
| 数据隐私 | 完全自控,数据不出域 | 数据传输至OpenAI服务器 | 数据传输至Anthropic服务器 | 数据传输至Google服务器 |
| 弹性扩展 | 需提前规划,扩容周期较长 | 天然弹性,自动扩展 | 天然弹性,自动扩展 | 天然弹性,与GCP深度集成 |
| 长期维护负担 | 高,模型更新、依赖维护需自行跟进 | 低,服务商负责模型迭代 | 低,服务商负责模型迭代 | 低,服务商负责模型迭代 |
对比表的核心结论可以概括为以下几点。
第一,工程复杂度差异是对小团队影响最大的单一因素。商用API的接入成本通常在一天内可以完成原型验证,而自托管方案从环境搭建到推理服务稳定运行,往往需要数天乃至数周,且需要持续投入运维精力。对于工程人手有限的团队,这个差异是实质性的。
第二,成本优势需要达到一定用量规模才能体现。在调用量较低的早期阶段,GPU固定成本通常高于商用API的按需计费。只有当日均调用量足够高时,自托管的单次成本才会低于商用API——这个临界点因模型规模和GPU型号而异,需要根据实际业务预测估算,而非假设开源一定更省钱。想进一步了解AI产品实际运营中的成本构成,可以参考我们的真实账单拆解。
第三,数据隐私不是技术问题,而是业务边界问题。如果你的业务涉及医疗、金融、政务等对数据出域有明确限制的场景,自托管几乎是唯一路径,无论工程成本多高。如果你的业务数据没有合规限制,这个维度不应该成为驱动选型的主要因素。
具体场景的选型建议
不同的团队情况对应不同的最优解,以下是我们在实践中总结的场景映射。
如果你是1-3人团队,正在验证产品假设,优先选择商用API(任意一家)。原因很简单:你现在最宝贵的资源是工程时间,而不是推理成本。商用API让你在数小时内完成第一个可用原型,快速获取真实用户反馈。在产品方向未确定前,花时间搭建自托管推理服务是错误的资源分配。这与我们在评估AI开发工具时强调的原则一致:先验证需求,再优化成本。
如果你的业务涉及敏感数据且有合规要求,选择开源自托管,并将工程复杂度的代价纳入成本计划。没有其他捷径。可以考虑使用已有托管方案(如 AWS Bedrock 自带模型、Azure OpenAI 的私有部署选项)来降低运维负担,但需要确认这些方案是否满足你的数据主权要求。
如果你的核心场景是长文档处理(法律文件分析、研报摘要、代码库问答等),Claude 3.x 系列的长上下文能力是明显优势。Gemini 1.5 Pro 在这个方向同样有竞争力,且与 Google Drive/Workspace 生态集成更顺畅。
如果你需要构建多步骤 Agent 系统,GPT-4o 目前在函数调用的稳定性和工具调用的生态支持上仍然是首选。Anthropic 的 tool use API 也在快速成熟,值得同步关注。
如果你的场景边界明确,且有能力准备微调数据集,开源模型是值得投入的长期资产。一个经过良好微调的 7B-13B 模型,在特定垂直任务上往往可以超越通用的 GPT-4o,同时推理成本大幅降低。但请确保你有足够的高质量标注数据,以及微调和评估的工程能力。
关于混合策略:我们在实际运营中观察到,越来越多的小团队采用"商用API起步、关键路径逐步替换"的节奏——先用商用API验证产品,积累真实调用数据后,再针对高频、低复杂度的子任务引入开源模型替换,保留商用API处理复杂的兜底场景。这个策略在工程资源和成本之间取得了较好的平衡。
常见问题解答
开源模型自托管的实际工程门槛有多高?
对于4B-8B量级的小参数模型,使用 Ollama 等工具在单张消费级GPU上完成本地部署已经相当成熟,技术门槛大幅降低。但生产级自托管涉及更多:需要处理并发请求管理、模型量化(GPTQ/AWQ等)、推理框架选型(vLLM/TGI等)、服务监控和故障恢复。这些工作加在一起,对于没有专职工程师的小团队仍然是显著的持续投入。评估时要诚实计算人力成本,而不只是GPU成本。
商用API的数据隐私是否真的有风险?
主流商用API服务商(OpenAI、Anthropic、Google)均提供企业协议(Enterprise Agreement)和数据处理协议(DPA),在协议层面可以约定不使用用户数据训练模型。问题的关键不是服务商是否可信,而是你的业务所在行业是否允许数据传输至第三方服务器。金融、医疗、政务等强监管行业通常有明确的法规约束,需要法务团队参与评估,而不是仅凭技术判断。
在什么用量规模下自托管的成本才会低于商用API?
这个临界点没有统一答案,取决于模型规模、GPU型号和实际利用率。粗略估算:如果你每天的调用量对应的商用API费用可以覆盖GPU的日摊销成本(包括机器折旧、电费、运维人力),那么自托管开始具备成本优势。通常来说,中低并发、偏交互式的场景,商用API的灵活计费更经济;高并发、批处理为主的场景,自托管的固定成本摊薄效果更好。建议在选型前做一次基于真实业务预测的简单成本模型,不要依赖直觉判断。
总结
本文的核心结论可以浓缩为以下几点,供直接用于团队决策:
- 工程时间是小团队最稀缺的资源。在产品早期验证阶段,商用API几乎总是正确选择,因为它将工程复杂度降至最低,让团队聚焦于产品本身。
- 数据合规要求是唯一的强制性因素。如果数据不能出域,自托管是必须路径,无论成本多高。其他所有因素都可以权衡,这一点不能。
- 开源模型的成本优势需要规模支撑。不要在用量验证之前就假设自托管更省钱——在用量达到一定规模前,固定GPU成本通常高于商用API的弹性计费。
- 垂直任务微调是开源模型的核心价值。如果你的场景边界足够清晰、有微调数据,开源模型经过微调后可以在特定任务上超越通用商用模型,同时大幅降低推理成本。
- 混合策略是很多团队的实用路径。商用API快速验证,积累数据后针对高频子任务引入开源替换,是在速度与成本之间取得平衡的可行方案。
下一步建议:梳理你当前或近期的核心AI调用场景,估算月均调用量和对应的商用API费用,再对比等效GPU资源的月均成本——这个简单的成本模型就能让你的选型决策从直觉变成数据支撑的判断。
如果你正在构建 AI 产品,或需要将纷繁的 AI 动态转化为真正可执行的工程决策,Darius 简报正是为你而写——每一条资讯都经过在生产环境中运营真实 AI 产品的视角筛选与解读。访问 Darius,订阅双语简报,与同样在一线造产品的工程师保持同频。
参考资料
- 火山引擎开发者社区. "按需择台:面向不同团队的AI大模型API聚合平台选型指南".
https://developer.volcengine.com/articles/7668611079539540006 - 经济观察网. "开源模型还是商业模型?阿里云智能张翅提出金融企业选择参考框架".
http://www.eeo.com.cn/2024/0527/663376.shtml - Datawhale. "附录E:模型提供商选型指南 | Hello Claw".
https://datawhalechina.github.io/hello-claw/cn/appendix/appendix-e.html - IEEE(电气电子工程师学会). AI系统工程与可靠性相关标准与技术资源.
https://www.ieee.org/