多模态向量模型迁移实录:召回率变化背后的工程细节
ALT: 多模态向量模型迁移工程实录,召回率变化背后的技术细节与优化路径
为什么换了一个更强的多模态模型,召回率反而下降了
你把文本+图像检索系统里的 embedding 模型从老版本换成了一个在各大 benchmark 上得分更高的多模态向量模型,上线后却发现真实用户查询的召回率不升反降——这不是个别案例,而是我们在多个生产环境中反复见到的迁移模式。
问题不出在新模型本身,而出在迁移过程中大量被忽略的工程细节:向量空间的分布差异、索引重建策略、查询侧与文档侧的预处理不对称,以及离线评测指标与线上真实召回之间的鸿沟。这篇文章的核心结论是:多模态向量模型迁移不是一次模型替换,而是一次向量空间的整体重构,工程团队需要在每个环节都重新对齐,才能让新模型的能力真正转化为业务收益。
现阶段多模态检索正处于快速演进期,CLIP 家族、BLIP-2、LLaVA 以及各厂商闭源的多模态 embedding API 层出不穷。每隔几个月就会有"更强"的模型出现,迁移需求因此持续存在。越早建立一套系统化的迁移方法论,越能在下一次模型升级时少踩坑。
多模态检索的现状:为什么迁移比纯文本更复杂
多模态向量检索的基本原理是将文本、图像(乃至音频、视频)映射到同一个向量空间,使得语义相近的跨模态内容在距离上也更接近。以 CLIP(Contrastive Language–Image Pretraining,由 OpenAI 提出)为代表的对比学习框架奠定了这一范式的工程基础。
然而与纯文本检索相比,多模态迁移面临三个额外的复杂度维度。第一,模态对齐质量——不同模型对"文本-图像语义一致性"的建模方式存在本质差异,同一张图用两个模型编码后,其最近邻文本集合可能几乎没有交集。第二,向量维度与度量空间——新模型的输出维度、归一化策略和适用距离函数(余弦 vs. 点积 vs. L2)往往不同,直接复用旧索引必然出错。第三,查询分布的隐性偏移——多模态查询(如"图片+文字描述"的混合查询)对模型的依赖比纯文本更深,模型切换后,原先调优好的查询重写逻辑、权重融合参数全部需要重校。
目前行业内主流的多模态 embedding 方案大致分为两类:一类是开源骨干模型的本地部署(如 OpenCLIP、SigLIP),另一类是厂商提供的托管 API(如各大云厂商的多模态 embedding 服务)。两类方案在迁移时面临的挑战有所不同,但核心工程问题是共通的。
召回率变化的根本原因:向量空间迁移的机制拆解
召回率在模型迁移后下降,本质上源于向量空间的不兼容性,具体体现在以下几个机制层面。
向量分布漂移:新旧空间的几何结构不同
向量分布漂移是最直接的原因。不同模型训练数据、损失函数和温度参数各异,导致输出向量在超球面上的分布密度完全不同。旧模型可能在某类图像区域(如产品图)上聚类紧密,而新模型可能将同类图像分散在更大的球面范围内。如果只替换了查询侧的编码器而没有重建文档库的向量索引,查询向量与文档向量就来自两个不同的几何空间,ANN(Approximate Nearest Neighbor,近似最近邻)搜索的结果将严重失真。
这个问题的严重程度往往超出预期。我们在实际迁移过程中见过的一种典型场景:离线评测用新模型对评测集全量重编码,看起来 Recall@10 有明显提升;但线上文档库因为量级太大(数千万条)没有及时重建,导致上线后召回的几乎全是噪声结果。
查询侧与文档侧的预处理不对称
预处理不对称是另一个隐蔽的陷阱。多模态模型对输入的预处理(图像 resize 策略、裁剪方式、文本 tokenizer、最大序列长度)极为敏感。新模型往往对应新的官方预处理流程,如果工程团队只更新了推理模型权重,沿用了旧的图像预处理 pipeline,就会让新模型"吃到"它从未见过格式的输入,导致向量质量大幅劣化。
一个具体的例子:某些较新的多模态模型要求图像保持原始宽高比并 padding 至固定尺寸,而旧的 pipeline 对图像做了强制正方形裁剪。切换模型但不更新预处理,产品图的向量质量可能直接退化到随机水平。
索引参数的过时:HNSW 图结构与新分布不匹配
索引参数失配是技术负责人容易忽略的一层。基于 HNSW(Hierarchical Navigable Small World)图结构的向量索引,其 ef_construction、M 等参数在构建时是针对特定向量分布调优的。旧模型的向量分布紧凑,旧索引的参数可能已经过拟合到这个分布;新模型如果分布更稀疏或更高维,直接重用旧参数构建的新索引在搜索效率和精度上都会下降,需要重新调参和压测。
评测集的分布偏差:离线指标不代表线上真实召回
离线-线上评测鸿沟是迁移决策中最难量化的风险。大多数团队的评测集是在旧模型时代积累的,标注的"相关"结果隐含了旧模型的检索偏好。用这个评测集衡量新模型,可能系统性地低估或高估新模型的真实能力。更糟糕的情况是:新模型在评测集上表现很好,但它检索到的是评测集里没有标注过的"正确但未知"的结果,被误判为召回失败。
多向量融合权重的失效
在混合检索场景(文本向量 + 图像向量 + 稀疏检索)中,融合权重是在特定模型组合下调出来的经验值。替换其中一个模型后,原有的加权融合公式就失去了校准基础,需要在新模型上重新做权重搜索(通常通过网格搜索或贝叶斯优化)。
迁移策略的多角度比较:如何在工程成本与效果之间取舍
不同规模的团队和不同体量的文档库,适合的迁移策略差异显著。以下表格从四个视角对比主流策略:
| 迁移策略 | 优势 | 代价与风险 | 最适合场景 |
|---|---|---|---|
| 全量重索引 + 灰度切流 | 新旧向量空间完全隔离,无混用风险;可做 A/B 对比 | 存储翻倍,重建耗时长,需维护双索引 | 文档库体量可控(千万级以下),对召回质量要求高 |
| 增量重索引 + 双写 | 平滑过渡,减少存储峰值压力 | 过渡期内新旧向量混存,需要路由层隔离;工程复杂度高 | 文档库持续高频更新,无法停服重建 |
| 向量适配层(线性映射) | 无需重建文档库,快速上线 | 映射误差不可忽视,适用范围有限(模型架构接近时效果较好) | 新旧模型架构相似,时间窗口极紧 |
| Shadow 模式评测先行 | 零风险,用真实流量评估新模型效果 | 不影响线上结果,需要额外计算资源并行运行双模型 | 迁移决策前的验证阶段,适合所有团队 |
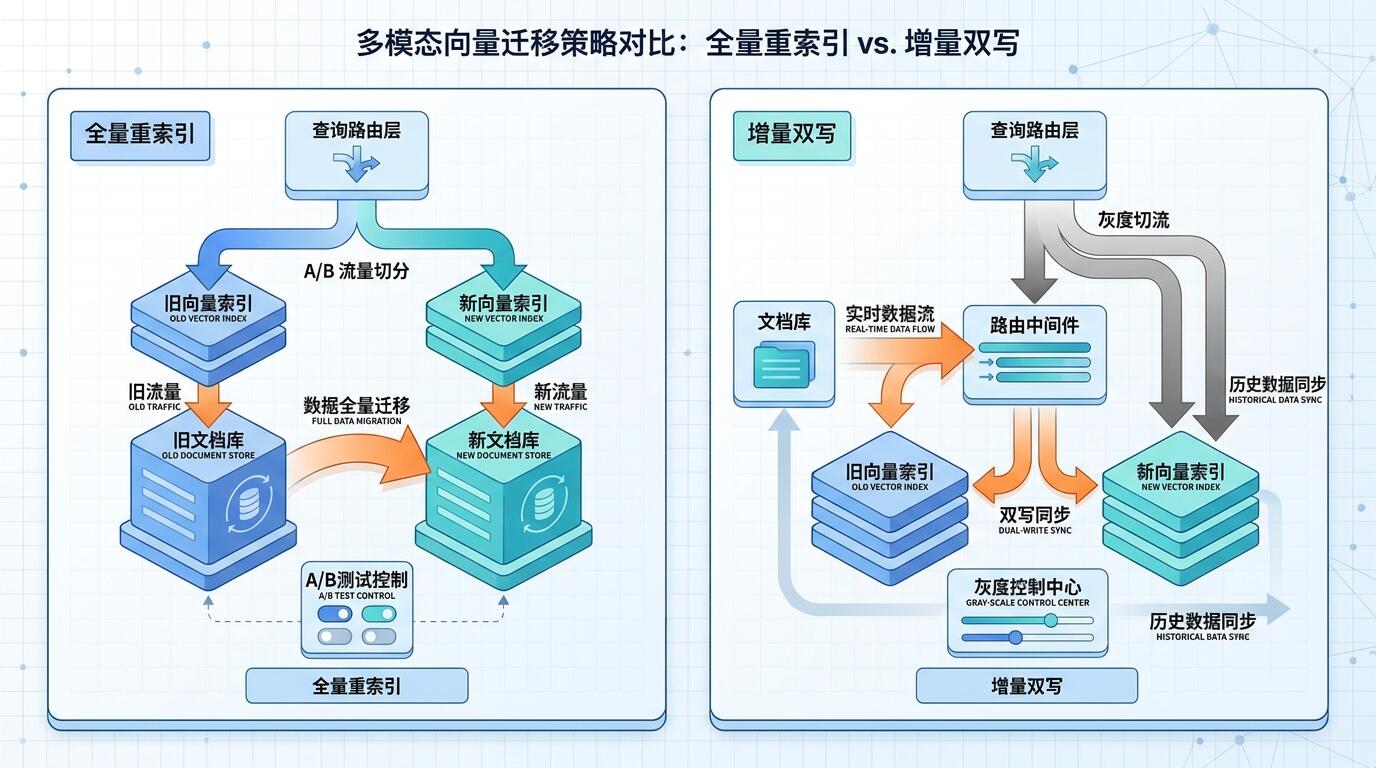
ALT: 多模态向量模型迁移中全量重索引与增量双写策略的工程架构对比,展示向量空间隔离与灰度切流路径
在实际操作中,我们见到的效果最稳定的路径是:先跑 Shadow 模式收集真实召回数据,再决定是否值得承担全量重索引的成本。很多团队在 Shadow 阶段就发现新模型在其领域数据上并没有 benchmark 上看起来那么强,省去了一次代价高昂的线上迁移。
另一个值得记录的细节:向量适配层(将新模型的向量通过线性变换投影到旧模型的向量空间)在理论上有吸引力,但在实践中有较明显的上限——它只能减少线性可纠正的分布差异,对非线性的语义空间结构差异无能为力。除非新旧模型出自同一架构家族且训练数据高度重叠,否则不建议作为长期方案。
多模态检索迁移的工程趋势与对构建者的启示
多模态检索正在从"能用"快速走向"好用"的阶段,这一过渡期的主要特征是:模型迭代速度快于工程基础设施的成熟速度。这意味着迁移将会是常态,而不是偶发事件。
从我们持续跟踪的行业动态来看,几个趋势值得提前准备。第一,模型标准化压力:越来越多的企业开始要求 embedding 服务提供向量空间稳定性承诺(即同一服务在版本升级后保持向量兼容),这将推动 API 提供商建立更严格的版本管理机制。第二,评测基础设施的价值凸显:拥有高质量领域评测集的团队在迁移决策上拥有信息优势,这个资产的战略价值正在被低估。第三,向量数据库的迁移工具链日趋成熟:主流向量数据库(如 Milvus、Weaviate、Qdrant)已经开始提供双索引管理、灰度路由等迁移友好的功能,降低了工程实施的难度。
对于正在构建多模态检索产品的工程师和技术负责人,有几个具体的行动项值得优先投入:
- 在评测体系里明确区分"模型能力评测"和"系统召回评测",前者用标准 benchmark,后者必须用真实业务查询日志构建。
- 建立预处理配置的版本化管理,确保模型版本与预处理逻辑强绑定,避免静默不对齐。
- 为文档库建立向量重建的 SOP,包括优先级分层(高价值文档先重建)和进度监控机制。
- 在架构设计阶段就将双索引运行成本纳入预算,避免在迁移窗口期措手不及。
常见问题解答
如何判断多模态模型迁移是否导致了召回率下降?
判断迁移是否造成召回率下降,最可靠的方法是在迁移前后用同一批真实用户查询做对比评测,而非依赖 benchmark 数据集。具体做法是:从线上查询日志中抽取代表性样本,人工标注相关文档,分别用新旧模型检索后计算 Recall@K。如果线上也有条件,可以用 Shadow 模式让新旧模型并行运行,直接对比真实流量下的返回结果差异。离线 benchmark 表现提升但线上下降,往往说明评测集分布与业务分布存在偏差。
向量适配层能否替代全量重索引,在多模态迁移中达到相同效果?
向量适配层无法完全替代全量重索引,但在特定条件下可以作为临时方案。适配层通过学习一个线性(或低秩)变换将新向量映射到旧向量空间,适用于新旧模型架构接近、训练数据高度重叠的情况。当模型架构差异较大时,非线性的语义空间结构差异无法被线性映射纠正,召回质量损失较明显。建议先在小规模测试集上量化适配层的召回损失,再决定是否接受这一折中。
全量重索引通常需要多长时间,如何估算成本?
全量重索引的耗时与成本取决于文档库体量、模型推理速度(是否有 GPU 加速)以及向量数据库的写入吞吐。无法给出通用数字,但可以提供估算框架:先用小批量测试推理速度(QPS),再根据文档总量推算完成时间;成本上需考虑 GPU 算力费用、存储翻倍的临时开销,以及维护双索引期间的查询额外延迟。对于大体量文档库,分优先级分批重建(先高价值、高频访问文档)是降低风险的常见策略。
总结
Key Takeaways:
- 多模态向量模型迁移的核心挑战不是模型本身,而是向量空间的整体重构——查询侧、文档侧、索引层、融合权重,每一层都需要重新对齐。
- 召回率下降最常见的直接原因是文档库向量未及时重建,导致查询向量与文档向量处于不兼容的几何空间。
- 预处理不对称是迁移中最隐蔽的陷阱,模型版本必须与预处理配置强绑定管理。
- Shadow 模式是迁移前验证效果最低风险的方法,建议将其纳入所有多模态检索迁移的标准流程。
- 高质量的领域评测集是迁移决策的信息基础,这个资产的建设应优先于模型升级本身。
下一步行动:审查你当前的多模态检索架构,确认预处理配置是否已版本化管理,并评估是否具备在真实查询日志上运行 Shadow 评测的能力。这两件事做好,绝大多数迁移风险都能提前识别。
如果你正在构建多模态检索或其他 AI 产品,欢迎访问 Darius 双语简报——每期由在生产环境中运营多款 AI 产品的工程总监亲自筛选与解读,帮你跳过噪音、直达对构建者真正有价值的信息。
参考资料与延伸阅读
- IEEE. "IEEE Transactions on Pattern Analysis and Machine Intelligence — Multimodal Representation Learning".
https://www.ieee.org/ - ACM. "ACM Digital Library — Approximate Nearest Neighbor Search and Vector Indexing".
https://www.acm.org/ - arXiv (Cornell University). "CLIP and Contrastive Language–Image Pretraining: Research Papers on Multimodal Embeddings".
https://arxiv.org/
注:上述参考资源可能持续更新,请以各机构官方发布的最新版本为准。