分块与元数据:为什么生产环境中检索质量会悄悄下降
ALT: RAG 检索增强生成系统中分块策略与元数据设计影响生产环境检索质量的工程分析
为什么你的 RAG 系统在上线后会越来越难用
生产环境中 RAG 系统的检索质量下降,往往不是模型的问题,而是分块策略与元数据设计在一开始就埋下了隐患。这是一个我在同时运营多款 AI 产品过程中反复碰到的规律:系统在 demo 阶段表现良好,上线后用户开始抱怨答案不准、上下文缺失、重复内容频繁出现,而这些问题往往无法通过换模型、调 prompt 来根本解决。
这个话题值得现在深入分析,原因很简单:随着 RAG 架构在企业和独立产品中的大规模落地,越来越多的团队开始发现,他们的检索系统在 demo 环境中的表现与生产环境中存在肉眼可见的落差。分块(Chunking)与元数据(Metadata)是影响检索质量的两个最底层变量,却是最容易在工程实践中被低估的环节。本文的目标,是把这个问题的根因说清楚。
从原型到生产:检索系统是如何一步步走偏的
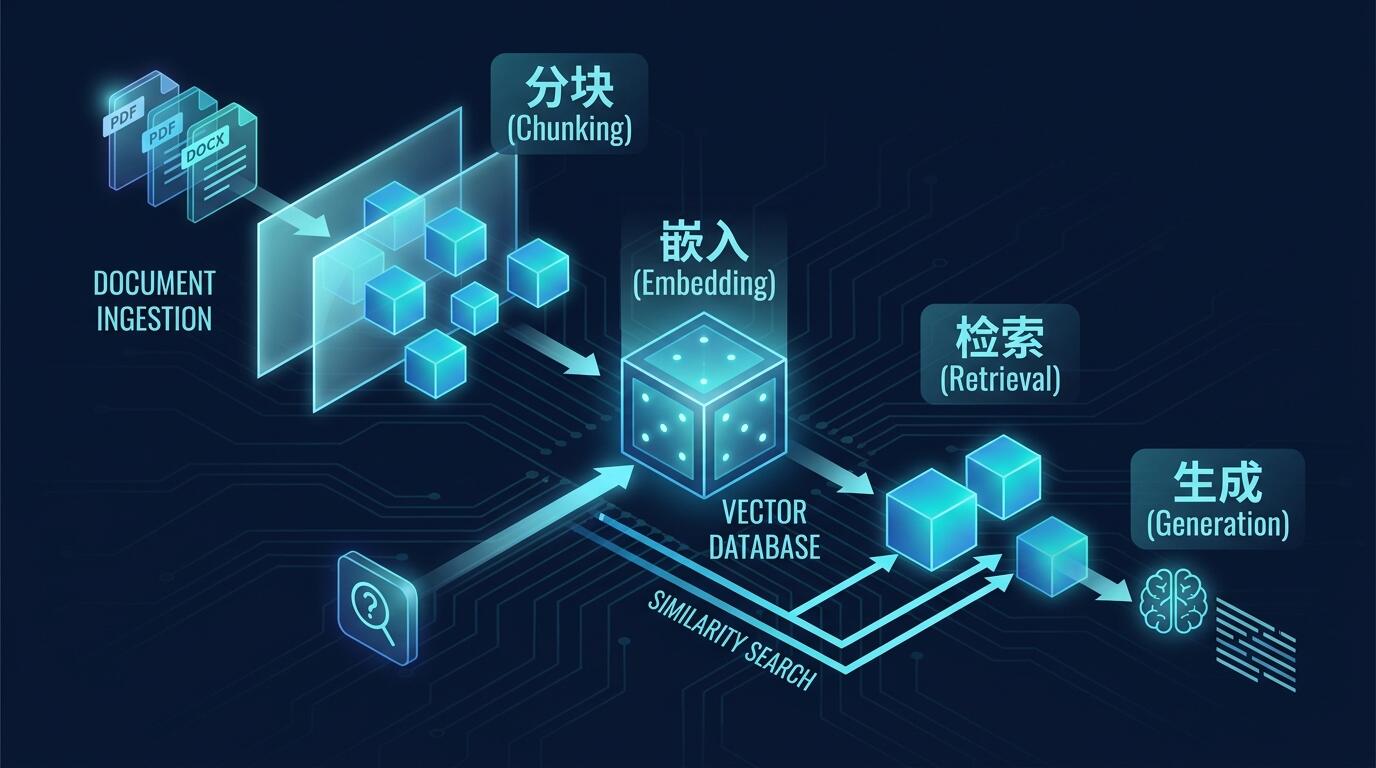
检索增强生成(Retrieval-Augmented Generation,RAG) 是一种将外部知识库与大语言模型结合的架构模式,其核心流程是:将文档切分成若干块(chunk),对每个块做向量化嵌入,存入向量数据库,在用户提问时通过相似度检索召回相关块,最后交由语言模型生成答案。
这个流程在纸面上非常清晰,但在实际工程中,原型阶段往往使用的是干净的测试文档、固定长度的简单切块、手写的几条元数据。这些条件在生产环境中几乎不会成立。
生产环境的文档来源是混乱的。PDF 里有表格、图注、页眉页脚;Markdown 文件有嵌套列表和代码块;Word 文档有脚注和修订痕迹;从网页爬取的内容有导航栏和广告文字混入正文。当这些内容被简单按字数切块,一个完整的概念会被拦腰截断,一段上下文连贯的描述会被分散到互不关联的多个块中,而检索系统对此一无所知。
更隐蔽的问题发生在时间维度上。知识库在持续更新,但旧的块不会自动失效。用户检索到的可能是半年前的政策描述、已经废弃的 API 版本、或者已经被更新文档覆盖但依然存在于向量库中的陈旧内容。这种退化是渐进的,没有报错,没有告警,只有用户体验的缓慢恶化。
我在为个人云盘构建语义文件搜索功能的过程中就踩过类似的坑:文件更新后向量库没有同步失效旧版本的嵌入,导致检索结果中新旧内容并存,用户无法判断哪个是最新的。这个问题不是模型层的缺陷,是数据管道的设计缺口。
检索质量下降的根因拆解
分块粒度不匹配语义边界
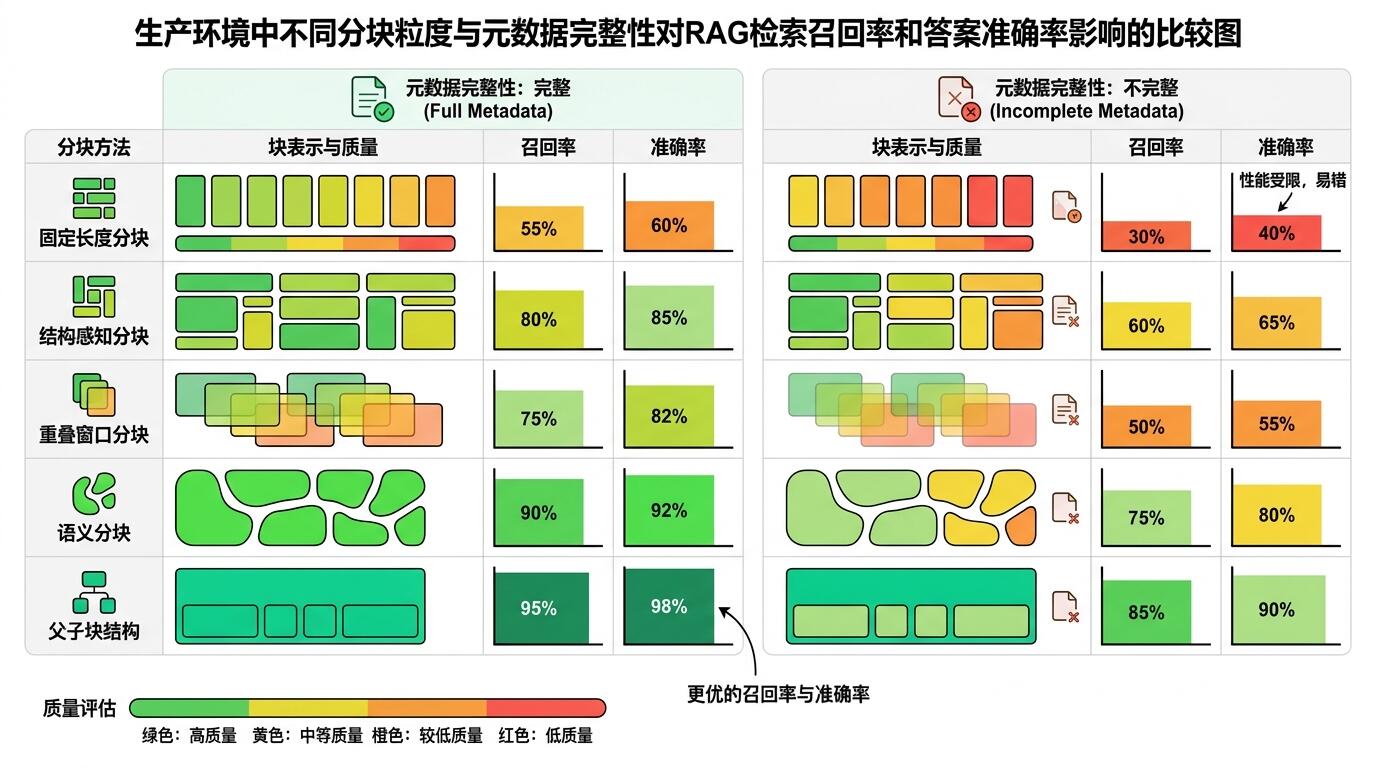
固定长度分块(fixed-size chunking) 是最常见的实现方式,也是最常见的失败原因之一。按字数或 token 数机械切块,不考虑段落边界、句子完整性或语义连续性,会导致两类核心问题:语义截断和语义混合。
语义截断是指一个完整的概念被切在两个块之间。比如一段描述某项技术原理的文字,前半句在块 A,后半句在块 B,检索时两个块都无法独立表达完整含义,召回任意一个都会让语言模型产生误解。语义混合则相反:一个块里包含了来自不同主题的内容,使得这个块的向量表示模糊,在多个主题上都能被召回,但在任何一个主题上都不够精准。
更进一步,重叠窗口分块(overlapping chunks) 是一种常见的补救方案,通过在块之间保留一定的重叠文本来缓解语义截断。但它带来的副作用是块数量急剧膨胀,相同内容被多次嵌入,检索结果中重复召回的概率上升,生成阶段的上下文窗口被冗余信息占据。
理想的分块应当以语义单元为边界,结合文档结构(标题、段落、列表项)进行切分。这被称为结构感知分块(structure-aware chunking),在 Microsoft Azure 的 RAG 架构指南中有系统性的阐述。
元数据缺失导致检索无法过滤
元数据(Metadata) 是附加在每个块上的结构化标注信息,包括文档来源、创建时间、文档类型、所属章节、版本号等。在检索时,元数据可以作为过滤条件,将相似度搜索的范围限定在特定的文档集合或时间区间内。
生产环境中最常见的问题是:块有了,元数据没跟上。原因是多方面的——文档入库流程没有强制要求元数据字段;不同来源的文档元数据格式不统一;知识库更新时旧块的元数据没有同步修订。结果是用户提问"最新的退款政策是什么",系统返回了两年前的版本,因为检索时根本没有时间维度的过滤机制。
元数据缺失的另一个后果是检索结果缺乏可解释性。当系统返回一个答案,用户或运营人员想要追溯"这个答案来自哪份文档的第几章"时,如果元数据不完整,溯源链条就断了。这对需要合规审计的场景来说是致命的。
嵌入模型与分块策略不匹配
嵌入模型(Embedding Model) 有其有效的输入长度范围。一些模型在处理短片段(几十词)时表现最好,另一些在处理中等长度段落(几百词)时语义捕捉更准确。当分块的长度与嵌入模型的有效感受野不匹配时,生成的向量无法准确表达块的核心语义。
这在实践中常常被忽视,因为嵌入模型通常不会因为输入过长而报错,只是悄悄地截断或压缩语义信息,导致检索召回的相关性下降,但表面上系统运行正常。
知识库腐化:静态设计遭遇动态现实
生产环境的知识库不是静态的。文档在更新,政策在迭代,产品在演进。一个在六个月前设计良好的分块方案,在知识库经历多轮大规模更新后,往往会出现块之间语义重叠加剧、同一概念有多个版本并存、旧块持续干扰新内容召回的问题。
这种知识库腐化(knowledge base drift)是生产环境中检索质量下降的最隐蔽原因,因为它是渐进发生的,没有单一的触发点,也没有系统层面的自动告警。只有当用户反馈频率上升,或者人工抽查检索结果时,才会发现问题已经积累到相当严重的程度。
不同分块策略的对比与适用场景
不同的分块策略在成本、质量与工程复杂度之间有明确的取舍。以下对比基于我们在实际系统中的观察,以及 NVIDIA 开发者博客和 Microsoft Azure RAG 指南中记录的工程实践。
| 策略 / 方法 | 优势 | 代价与局限 | 最适合的场景 |
|---|---|---|---|
| 固定长度分块 | 实现简单,工程成本低,处理速度快 | 语义截断风险高,不感知文档结构 | 快速原型,文档结构高度一致的场景 |
| 结构感知分块 | 尊重语义边界,召回精准度明显提升 | 需要解析文档结构,实现复杂度上升 | 有明确层级结构的技术文档、法规文件 |
| 重叠窗口分块 | 缓解语义截断,上下文连贯性更好 | 块数量膨胀,重复召回率上升,存储成本增加 | 叙事性长文、需要上下文连续的问答场景 |
| 语义分块(基于模型判断边界) | 最贴近语义真实边界,质量最高 | 计算成本高,需要额外的分块模型或 API 调用 | 对检索质量有强要求、文档结构不规则的场景 |
| 父子块结构(Parent-Child Chunks) | 兼顾召回精度与上下文完整性 | 系统设计复杂,索引与检索逻辑需要定制 | 需要精细召回又需要丰富上下文的企业知识库 |
这张表背后有一个核心结论:没有一种分块策略是万能的。选择哪种策略,取决于你的文档类型、更新频率、对检索精度的要求,以及你愿意在工程复杂度和运营成本上投入多少。
在智能体流水线的检索阶段设计中,我们发现一个被频繁低估的事实:分块策略的选择不是一次性的技术决策,而是需要随知识库演化持续调整的工程实践。
ALT: 不同分块粒度与元数据完整性对 RAG 生产环境检索召回率和答案准确性的影响对比示意
从这里往哪走:给构建者的实际判断框架
检索质量问题的解决方向,不是无限度地提升分块复杂度,而是在质量、成本与可维护性之间找到合适的工程均衡点。以下是我在生产系统中形成的几个判断基准。
首先,建立检索质量的持续监控机制,而非只在上线前做评估。 检索质量的退化是渐进的,没有监控就没有感知。可以从最基础的指标入手:定期抽样检索结果做人工评估,跟踪用户的负反馈频率,记录答案溯源失败的比例。这些指标成本低,但信号价值高。
其次,元数据标准化优先于分块策略精细化。 在很多情况下,补全并规范化现有块的元数据(来源、版本、时间戳、所属章节)比重新设计分块策略能更快地改善检索质量。元数据过滤可以将一个模糊的相似度搜索问题变成一个有约束的精确检索问题。
第三,为知识库更新设计失效机制。 文档更新时,对应的旧块应当被明确标记为过期或直接删除重建,而不是默默与新块共存。这需要在数据入库流程中设计版本管理逻辑,而不是事后补救。
第四,在正式投入高成本的语义分块方案之前,先量化当前方案的质量瓶颈在哪里。 如果问题主要来自元数据缺失,换分块策略不会有显著效果;如果问题来自语义截断,调整元数据无济于事。诊断先于优化,这个顺序不能颠倒。
对于想在评估 RAG 相关工具时建立系统性判断框架的读者,可以参考评估 AI 开发工具的关键要点,其中有关于工具选型时检索层评估维度的具体讨论。
常见问题
Q1:如何判断当前的分块策略是否是检索质量下降的主因?
判断的基本方法是分层排查。先检查召回的块内容本身是否完整、是否包含答案所需的关键信息;如果块内容本身是完整的但答案仍然错误,问题可能在生成层;如果召回的块内容明显被截断或语义混乱,则分块策略是主要怀疑对象。建议构建一个包含标准问答对的评估集,定期自动化跑召回指标,而不是依赖主观感受。
Q2:元数据字段越多越好吗?
不一定。元数据字段过多会增加索引维护成本,同时在检索时如果过滤条件设计不当,反而会造成召回率下降。实践中建议从最高频使用的过滤维度入手,比如文档来源、时间戳、文档类型,先验证这些字段的过滤有效性,再根据实际需求逐步扩展。字段的价值取决于它是否真的被检索逻辑所使用,沉睡在元数据中的字段不创造任何价值。
Q3:重建向量库的成本有多高,是否值得定期执行?
成本主要来自两部分:重新嵌入所有文档的计算费用,以及停机或双写期间的系统复杂度。对于中小规模知识库,增量更新(仅重建变更文档对应的块)通常比全量重建更经济。对于大规模知识库,建议在架构设计阶段就规划好文档版本管理和块失效机制,使增量更新成为常规操作,而不是等问题积累后再做全量重建。
总结
生产环境中 RAG 系统检索质量的下降,根源几乎都可以追溯到三个层面:分块粒度与语义边界不匹配、元数据设计缺失或不规范、知识库更新缺乏有效的版本管理机制。这三个问题共同作用,导致检索质量在上线后渐进退化,而不是在某个明确的节点突然失败。
核心结论是:
- 分块不是一次性的预处理步骤,而是需要随知识库演化持续维护的工程实体。
- 元数据的完整性和规范化,往往比切换更复杂的分块算法更能快速提升检索精度。
- 检索质量的监控机制应当在系统上线前就建立,而不是在用户开始抱怨后才去补。
接下来最实际的行动是:为你的生产检索系统建立一个最小可行的评估集,定期跑一次召回质量检查。不需要复杂的框架,一个包含二三十个标准问答对的 CSV 就够了。这个投入极低,但能给你一个可持续观测检索质量变化的基准线。
如果你正在构建 AI 产品,不想在信息噪音中浪费时间,欢迎订阅Darius 双语 AI 简报——每期精选 5–10 条有一手来源支撑的 AI 动态,并附上来自真实生产系统的实战解读。与同样在一线构建 AI 产品的工程师一起,把最新的模型发布、论文与政策变化转化为真正有用的行动参考。
参考资料与延伸阅读
- NVIDIA Developer Blog. "寻找实现准确AI 响应的最优文本分块策略".
https://developer.nvidia.cn/blog/finding-the-best-chunking-strategy-for-accurate-ai-responses/ - Microsoft Azure Architecture Center. "在Azure 上开发RAG 解决方案- 分块阶段".
https://learn.microsoft.com/zh-cn/azure/architecture/ai-ml/guide/rag/rag-chunking-phase - NageOffer AI 基础知识库. "Chunk 分块策略决定检索质量".
https://nageoffer.com/ai/basics/rag/rag-core/chunking-strategies/ - IEEE (电气与电子工程师协会). IEEE 标准与技术出版物:信息检索与自然语言处理相关研究.
https://www.ieee.org/ - ACM (国际计算机学会). ACM Digital Library:检索增强生成与向量数据库相关学术文献.
https://www.acm.org/
注:技术规范与最佳实践随工程发展持续演进,建议以各官方来源最新版本为准。