人机协作中的编辑判断:本季度自动化出版的平衡之道
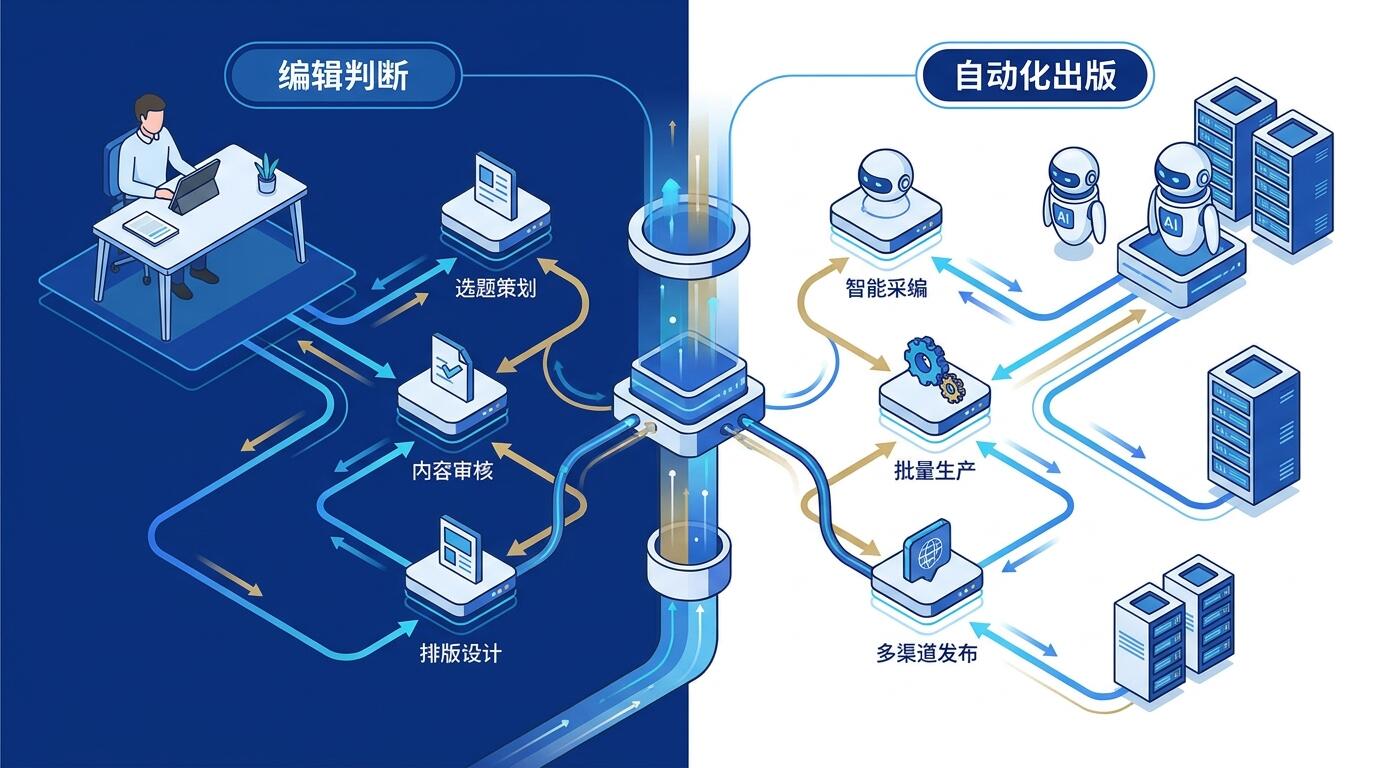
ALT: 人机协作编辑判断与自动化出版平衡之道的工程师视角对比分析
自动化出版的真实张力:编辑判断与 AI 生成之间该如何划界
自动化出版正在从"实验性尝试"变成许多内容团队的日常操作基础设施。生成式 AI 降低了内容生产的边际成本,也让"用机器替换人工编辑"的冲动变得前所未有地真实。然而在我们实际运营 AI 简报产品的过程中,一个反复出现的认知是:降低成本和保持判断力,是两件方向相反的事情,必须主动设计才能同时成立。
本文比较三种在内容团队中常见的人机协作模式——全自动发布、人工审核兜底、以及编辑主导的 AI 辅助——并从工程实践角度评估它们各自的适用边界、风险分布和决策成本。核心判断标准是:在实际生产环境中,哪种模式能让编辑判断力得到最有效的复用,同时将 AI 的速度优势落到实处。
判断维度:如何评估一种协作模式是否可持续
评估人机协作模式是否适用于出版场景,不能只看吞吐量。以下六个维度是我们在实际产品迭代中反复回归的评估框架。
事实准确性的可追溯性。 AI 生成内容的最大风险不是质量低,而是错得自信。一个好的协作模式需要明确"谁对事实负责",并在流程层面留下可回溯的审核节点。
叙事连贯性与语气一致性。 自动化工具擅长段落级别的流畅,却难以跨期维持品牌语气。编辑判断在这里的价值是隐性的,但一旦缺失,读者会感知到。
异常内容的识别与拦截成本。 幻觉内容、过时数据、政治敏感表述——AI 并不擅长自我识别这类风险。不同协作模式在"异常内容进入发布流程"的概率上差异显著,这个差异的成本需要显式估算。
编辑决策的可复用程度。 一位资深编辑的判断力是稀缺资源。协作模式是否能把这种判断力结构化为可复用的规则或 prompt 约束,决定了团队的规模化上限。
发布频率与质量之间的动态平衡。 高频发布会稀释单篇质量,低频发布会降低读者黏性。好的协作模式应该让这个权衡显式化,而不是让它隐藏在"我们有 AI 兜底"的乐观预设里。
迭代与调整的响应速度。 当模型输出漂移、当热点话题突然出现,协作模式能以多快的速度响应?这个维度测试的是流程的弹性,而不仅仅是平均性能。
三种模式的实际形态
全自动发布模式
全自动发布模式是指从内容选题、生成到发布的全链路由程序驱动,人工只在出现投诉或重大错误后介入。这种模式在新闻聚合、财报摘要、体育数据快讯等高度结构化内容领域有真实的商业案例,彭博社的 Cyborg 系统和美联社早期的财报自动化是经常被引用的参考。
这种模式的核心假设是:内容的事实来源足够可靠,且格式足够标准化,使得生成过程的风险可以被充分约束。一旦这个假设不成立——比如内容依赖多源交叉验证,或需要叙事层面的判断——全自动模式的风险就会呈非线性上升。
在我们观察到的实际案例中,全自动模式最常见的失效形式不是生成了明显错误的内容,而是生成了"看起来正确但无法核实"的内容,并因为没有审核节点而顺利进入了发布。这种失效往往要到读者反馈才会被发现,修复成本远高于事前拦截。
人工审核兜底模式
人工审核兜底模式的逻辑是:AI 负责生产,人工负责最后一关的质量把控。表面上看,这是一个风险分散的设计,但在实际运行中,这种模式容易产生一种危险的心理状态——"反正有人审"——导致审核环节流于形式。
这种模式的核心挑战在于审核的认知负荷。当内容量足够大,或发布频率足够高,审核者会进入"扫描模式"而非"阅读模式",对细节的敏感度会系统性下降。我们把这个现象称为"橡皮图章效应":人工节点存在于流程中,但实际发挥的判断力已经接近于零。
另一个常见问题是审核标准的模糊性。如果没有明确的审核 checklist,审核者会倾向于只拦截最显眼的错误,而放过那些需要领域知识才能识别的细节问题。这使得"人工审核兜底"在统计上的表现好于它在实际上的效果。
编辑主导的 AI 辅助模式
编辑主导的 AI 辅助模式是指编辑保持对内容方向、选题判断和叙事框架的控制权,AI 承担草稿生成、信息整理、格式化等执行层任务。这是三种模式中对编辑判断力要求最高、也最能实现判断力复用的模式。
这种模式的核心设计点在于:明确哪些决策是编辑专属的,哪些是可以委托给 AI 的。一份运作良好的 AI 辅助出版流程,通常会有一套结构化的 prompt 系统,将编辑的隐性判断("我们不在简报里发未经核实的独家"、"技术解读不超过三段")显式化为可传递的约束。
Darius 双语 AI 简报的运作方式接近这个模式:每期选题由编辑基于对行业动态的持续追踪完成,AI 辅助完成初稿整理和格式对齐,最终发布内容经过编辑的叙事判断和事实核查。这个流程的设计目标不是最大化吞吐量,而是保证每条内容都能对得起附在后面的"实战解读"标签。
三种模式的横向对比
| 评估维度 | 全自动发布 | 人工审核兜底 | 编辑主导 AI 辅助 |
|---|---|---|---|
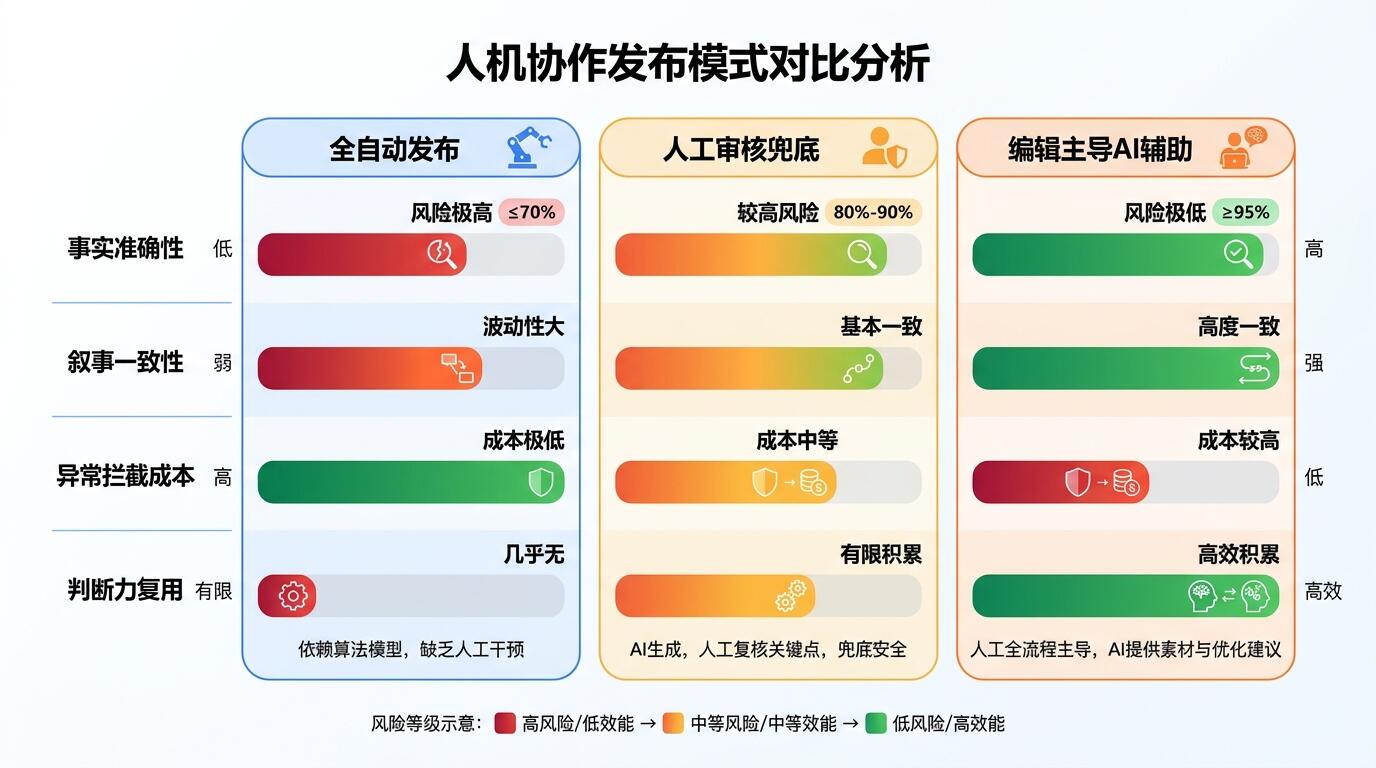
| 事实准确性可追溯性 | 低(无人工节点) | 中(节点存在但效能递减) | 高(编辑对事实负责) |
| 叙事一致性维护 | 低(跨期漂移显著) | 中(依赖审核者经验) | 高(编辑持续介入) |
| 异常内容拦截成本 | 高(事后修复) | 中(审核质量参差) | 低(事前约束为主) |
| 编辑判断力复用程度 | 无 | 低(判断集中在末端) | 高(结构化为 prompt 约束) |
| 发布频率支撑能力 | 高 | 中(受审核带宽限制) | 中(受编辑精力限制) |
| 流程调整响应速度 | 低(需重新训练或改 prompt) | 中 | 高(编辑可即时介入) |
这张对比表揭示了一个并不直觉的结论:人工审核兜底模式在几乎所有维度上都处于中间位置,但它的中间位置并不意味着"最安全"——它意味着在两个方向上都没有做到最好,却同时承担了两个方向的组织成本。
全自动模式的优势只在非常窄的条件下成立:内容来源结构化、事实风险低、读者对准确性的容错率高。一旦这三个条件同时成立,全自动才能真正发挥其吞吐量优势。否则,它只是把审核成本从事前转移到了事后,且事后成本通常更高。
编辑主导的 AI 辅助模式的主要代价是规模化边界:它的上限受制于编辑的精力和时间。这个代价是真实的,但对于大多数专注于质量而非量的内容产品来说,这是一个可接受的约束——前提是这个约束被显式承认,而不是被"未来 AI 会更好"的幻觉所掩盖。
ALT: 全自动发布、人工审核兜底与编辑主导AI辅助三种模式的风险分布与编辑判断力复用对比示意图
你的情况适合哪种模式:场景对应建议
不同团队和产品类型对协作模式的适配需求差异显著。以下是基于实际产品运营经验的场景映射。
如果你运营的是财报摘要、数据快讯或高度标准化的结构化内容,且来源数据有明确的可靠性保证,全自动模式是值得认真评估的选项。核心要做的事是:在上线前用真实数据做充分的边界测试,明确定义"异常输出"的判断标准,并建立投诉响应的快速通道。不要因为"AI 已经够好了"而跳过这些步骤。
如果你的团队规模较大,内容量高但编辑资源有限,人工审核兜底模式可能是现实约束下的选择。但要避免这个模式最常见的失效:审核标准不明确、审核者认知负荷过高。具体建议是把审核 checklist 做到条目级别,定期抽样评估审核者的实际识别率,而不是假设"有人审"等于"审得好"。
如果你的产品定位依赖内容的深度判断、叙事质量或品牌语气的一致性,编辑主导的 AI 辅助模式是目前最可靠的选择。关键是把编辑判断力显式化——不要让它停留在个人经验里,而是通过 prompt 系统、选题框架和审核 checklist 把它变成团队层面的可复用资产。这样做的副作用是:当编辑离开或精力分散时,流程仍然能维持基线质量。
如果你正在从零开始搭建内容自动化系统,建议的顺序是:先跑编辑主导模式,在实际运营中积累足够多的"好输出"和"坏输出"样本,再逐步将编辑判断规则化,最终决定哪些环节可以安全地降低人工介入比例。跳过这个积累阶段直接上全自动,几乎是所有踩坑案例的共同起点。
常见问题
Q1:如何判断当前的人机协作流程是否出现了"橡皮图章效应"?
橡皮图章效应的核心特征是:审核者通过了内容,但无法事后说明拦截了哪些具体问题。一个简单的诊断方法是定期在内容流中注入已知的错误样本(事实错误、语气偏差、格式问题),观察审核者的实际识别率。如果识别率持续低于预期,说明审核环节已经流于形式,需要重新设计审核结构或降低审核频率以换取审核质量。
Q2:AI 辅助写作是否会导致品牌语气的长期漂移?
语气漂移是一个真实风险,但它是可干预的。语气漂移通常发生在 prompt 描述不精确、或编辑对单次输出的修改没有被反馈回 prompt 系统的时候。有效的对策是建立"语气锚点文档"——用真实发布过的高质量内容片段作为风格示例,定期与当前 AI 输出做对比评估,发现偏移时及时调整 prompt 约束。语气一致性不是自动保持的,它需要被当作一个需要主动维护的系统指标。
Q3:编辑主导模式在成本和效率上与全自动相比差距有多大?
编辑主导模式的效率成本主要体现在编辑的时间投入上,这个成本是真实且不可完全消除的。但"效率差距"的实际大小高度依赖内容类型和质量标准。对于需要领域判断、多源核查或品牌一致性的内容,编辑主导模式的"慢"换来的是可测量的质量保证;对于标准化内容,效率差距会更显著。建议的做法是对内容进行分层:将标准化程度高的内容逐步移向自动化,将依赖判断力的内容保留编辑主导,而不是对所有内容采用同一种模式。
最终思考
人机协作中的编辑判断问题,本质上是一个关于"稀缺资源如何分配"的工程问题。在自动化出版场景中,稀缺的不是算力,不是生成速度,而是可信赖的判断力——那种能分辨"这条信息值得放进简报"和"这条信息看起来对但我无法核实"的能力。
三个值得带走的核心判断:
第一,没有一种协作模式是普遍最优的。模式选择的前提是对自己内容的风险分布有清醒认识——什么类型的错误是你的读者无法容忍的,什么类型的误差是可接受的。
第二,人工节点的价值不在于"存在",而在于"有效运作"。一个流于形式的审核环节不仅不能降低风险,还会制造虚假的安全感,这比没有审核环节更危险。
第三,编辑判断力是一种需要显式管理的资产。将它结构化为 prompt 系统、选题框架和审核标准,是让它在团队规模化时不因人员变动而流失的唯一可靠方式。
下一步行动建议:审视你当前的发布流程,找到判断力最薄弱的节点——不是生成质量最差的节点,而是"谁对这里的输出负责"最模糊的节点。从那里开始重新设计。
如果这篇文章对你有帮助,欢迎订阅 Darius(Darius)——这是一份由真正在生产环境中跑着 AI 产品的工程师写给构建者的双语简报,每期精选 5–10 条 AI 要闻,条条附有一手来源与实战解读,帮你把行业噪音过滤成真正可用的判断。直接访问 Darius 网站即可订阅,和同样在一线构建 AI 产品的从业者一起,保持对这个快速演变领域的清醒认知。
参考资料与延伸阅读
- IEEE. "Guidelines on Ethical Considerations for AI in Automated Content Systems".
https://www.ieee.org/ - Reuters Institute for the Study of Journalism, University of Oxford. "Journalism, Media, and Technology Trends and Predictions".
https://reutersinstitute.politics.ox.ac.uk/ - ACM (Association for Computing Machinery). "Principles and Best Practices for AI-Assisted Publishing and Human-AI Collaboration".
https://www.acm.org/ - UNESCO. "Recommendation on the Ethics of Artificial Intelligence".
https://www.unesco.org/
注:上述文件及标准可能持续更新,建议查阅各机构官方渠道获取最新版本。