为什么同样的输入LLM评测会给出不同分数
ALT: LLM evaluation inconsistency explained — why identical prompts yield different benchmark scores
同样的提问,为何LLM评测会给出截然不同的分数?
大语言模型(LLM)评测分数的不一致性,是当前AI工程实践中一个被严重低估的问题。在我们与多个技术团队的合作中,反复出现同一个困惑:把同一段Prompt原封不动地输入模型,前后两次评测得到的分数却相差甚远。这不是偶然现象,而是LLM底层机制与评测方法论共同作用的必然结果。
理解这一现象,是构建可靠AI系统的前提。如果你正在评估不同模型的能力、设计自动化评测流水线,或者向业务方汇报AI产品的质量指标,那么读懂LLM评测的"分数漂移"背后的逻辑,将直接影响你的架构决策和产品可信度。
LLM评测的现状:一个被误解的基准游戏
LLM评测,是指通过标准化输入和评分标准衡量大语言模型输出质量的过程,是当前AI产品开发中不可或缺的环节。然而,"评测分数"这个概念在业界普遍被过度简化。
现实情况是,LLM的输出并不像传统软件那样具有确定性。传统程序在相同输入下永远产生相同输出;而大语言模型的生成过程本质上是概率性的,每次推理都是在一个高维概率空间中进行采样。这意味着,即便输入完全一致,模型的输出也可能每次不同,评测分数自然随之波动。
与此同时,业界在基准测试上的竞争日趋激烈。各大模型厂商在公开榜单上刷新MMLU、HumanEval、GSM8K等基准的分数,但这些数字背后的可重复性却鲜有人深究。部分研究者已经指出,相同模型在不同评测框架下的得分差异,有时超过了不同模型之间的差距本身——这使得"分数"作为决策依据的可靠性大打折扣。
对于工程团队而言,这个问题的代价是真实的:基于不稳定评测结论做出的模型选型,可能导致生产环境中的实际表现与预期严重背离。
分数为何漂移:深层机制拆解
LLM评测分数的不一致性,来源于多个相互叠加的机制层。以下逐层剖析其根本原因。
采样温度与生成随机性
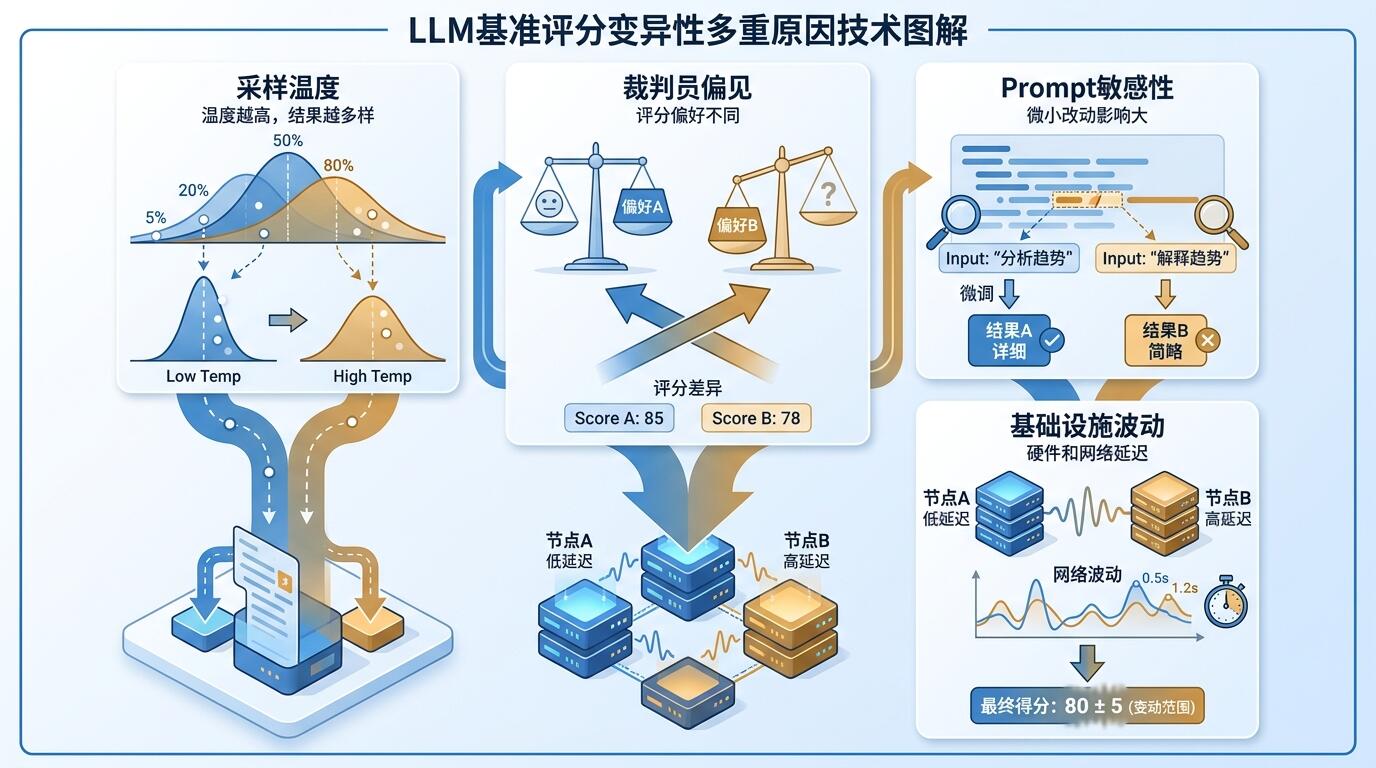
温度参数(Temperature)是控制LLM生成多样性的核心超参数。当温度大于0时,模型在每次生成时会从概率分布中随机采样,而非选取概率最高的token。根据火山引擎开发者社区的技术分析,这一随机采样机制是导致相同提示词每次输出不同的根本原因之一。
即便将温度设置为接近0,也并不等于完全确定性。许多推理框架在底层实现中仍保留了一定的随机性来源,包括浮点运算的精度误差、批处理时的并行计算顺序,以及某些模型服务层的负载均衡导致的节点差异。换句话说,"温度=0"更多是工程上的近似,而非数学上的保证。
评测框架的实现差异
评测框架是指用于自动化运行基准测试并计算分数的软件系统。不同框架在细节实现上的差异,往往被忽视,却是分数漂移的重要来源。
具体体现在以下几个维度:Prompt模板的格式差异(是否添加system prompt、few-shot示例的数量和内容)、输出解析逻辑的差异(如何从模型的自由文本输出中提取答案)、以及评分规则的差异(精确匹配 vs. 语义匹配 vs. LLM-as-Judge)。同一个模型用不同框架评测,往往得到显著不同的结论,这正是当前基准比较缺乏可信度的核心原因之一。
裁判员模型(LLM-as-Judge)的主观性
裁判员模型(Judge Model)是一种用另一个LLM来评价目标LLM输出质量的评测范式,因其能处理开放性生成任务而被广泛采用。阿里云PAI平台的技术文档明确指出,裁判员模型在评测打分中扮演着关键角色,但其本身也是一个具有随机性的语言模型。
裁判员模型的分数不稳定性来自多个方面:裁判模型自身的输出随机性、评分Prompt的措辞对结果的强烈影响(研究者称之为"评分位置偏差"和"冗长偏差")、以及裁判模型对不同输出风格的隐性偏好。更为复杂的是,当被评测模型和裁判员模型属于同一系列时,往往存在系统性的分数虚高——即所谓的"自我偏好"(self-preference)问题。
上下文窗口与Prompt工程的细微变化
上下文敏感性是LLM的固有特性:模型对Prompt中极细微的变化异常敏感。测试人员社区的工程实践经验表明,即便是措辞上的微小改动,也可能导致模型输出截然不同的结果。
在评测场景中,这意味着:Prompt中多一个空格、换行符的位置不同、few-shot示例的顺序调整,都可能触发不同的输出分布,进而影响最终得分。当评测套件在不同时间、不同环境下运行时,这些细微差异往往难以完全控制,导致结果的可重复性下降。
基础设施层的不确定性
推理基础设施(包括GPU集群、分布式服务、量化方案)也是分数漂移的隐性来源。当模型以批量推理方式运行时,不同批次的样本组合可能因并行计算顺序的不同而产生细微的数值差异。此外,模型量化(如INT8、INT4)在降低计算成本的同时,会引入数值精度损失,不同量化配置下的评测结果不具有直接可比性。
多角度对比:不同评测方案的取舍
对于工程团队而言,理解分数不稳定性的根源之后,下一步是选择适合自己场景的评测方案。以下对比了几种主流评测范式的优劣:
| 评测方案 | 优势 | 局限性 | 最适合场景 |
|---|---|---|---|
| 确定性基准(选择题/精确匹配) | 可重复性高,消除生成随机性 | 无法评估开放性生成质量,覆盖任务类型有限 | 知识问答、代码正确性验证 |
| 裁判员模型(LLM-as-Judge) | 能评估语义质量和复杂推理,接近人类判断 | 受裁判模型自身随机性和偏见影响,成本较高 | 长文生成、对话质量、创意任务 |
| 人工评估 | 最接近真实质量感知,可捕捉细微偏差 | 成本高、速度慢、评审员主观性难以消除 | 产品上线前的关键质量门控 |
| 多次运行取均值 | 通过统计手段抵消随机波动,提高稳定性 | 成本成倍增加,极端异常值仍可能拉偏均值 | 正式模型评选、严肃的能力对比 |
| 固定种子推理 | 在支持的框架中可实现较高可重复性 | 依赖框架支持,分布式部署中难以全面实施 | 内部回归测试、版本迭代对比 |
从工程实践的角度来看,我们在协助团队设计评测方案时,最常见的误区是过度依赖单一指标的单次运行结果。真正可靠的评测体系,往往是多种方案的组合:用确定性基准建立底线,用裁判员模型覆盖开放任务,用多次统计运行获取置信区间,而非一个点估计。
这种系统性思维与CTO在评估AI系统架构模式时需要考量的可观测性和可靠性原则是一致的——评测本身就是AI系统可观测性体系的一部分。
前景与实践启示:评测可信度如何成为竞争优势
LLM评测领域正朝着标准化和可重复性方向发展,但这个过程远未完成。可以预见的趋势包括:评测框架的统一化(减少因框架实现差异带来的分数不可比性)、元评测(meta-evaluation)研究的兴起(即评估评测方法本身的可靠性),以及基于置信区间的报告规范逐步取代单点分数。
对于正在构建AI产品的工程团队,以下启示具有直接的实践价值:
第一,把评测结果当分布而非点值。 在做模型选型或版本对比时,对同一测试集运行多次,计算均值和标准差。一个均值略低但方差极小的模型,在生产环境中往往比均值高但表现极不稳定的模型更可靠。
第二,锁定并记录评测环境。 固定Prompt模板、few-shot示例、温度参数、随机种子(在支持的情况下),以及推理框架的版本。评测配置的版本管理,和代码版本管理同等重要。
第三,区分"基准分数"与"任务相关分数"。 公开排行榜上的MMLU分数与你的具体业务场景的相关性,往往低于你的预期。真正有价值的评测,是在你的真实数据分布上进行的,而非通用基准。
第四,对LLM-as-Judge方案保持审慎。 如果使用裁判员模型,需要定期校准其与人工评估的对齐程度,并明确记录所使用的裁判模型版本和评分Prompt。避免用同系列模型互评,以减少自我偏好偏差。
在构建能够突破原型阶段的机器学习流水线时,将评测稳定性纳入流水线设计的早期考量,而非事后补救,是区分工程成熟度的关键标志之一。
ALT: LLM benchmark scoring variability analysis — temperature sampling, judge model bias, and prompt sensitivity factors causing inconsistent evaluation results
常见问题解答
Q1: 如何减少LLM评测分数的随机波动?
减少评测分数随机波动的有效方法,是通过多次运行取统计均值,并尽可能锁定推理环境。具体措施包括:将温度参数设为接近0的值、在支持的框架中固定随机种子、对同一测试样本重复评测多次并计算置信区间,以及避免在不同硬件环境或量化方案之间直接比较分数。评测配置(包括Prompt模板和评分规则)需要版本化管理,以确保结果的可复现性。
Q2: LLM-as-Judge评测范式是否可靠?
LLM-as-Judge是一种有用但需谨慎使用的评测范式。其核心局限在于:裁判模型本身具有输出随机性,且存在对长篇幅答案的偏好偏差和自我偏好问题(同系列模型互评时分数虚高)。提升其可靠性的关键措施包括:定期与人工评估结果进行校准,使用与被评测模型不同系列的裁判模型,以及对评分Prompt进行严格的版本控制和偏差测试。
Q3: 评测环境的哪些因素会影响分数的可重复性?
影响LLM评测可重复性的环境因素主要包括:推理框架及其版本、模型量化方案(FP16 vs. INT8等)、批处理大小与并行计算配置、Prompt的精确格式(包括空白符和编码),以及裁判员模型的版本与评分Prompt措辞。在分布式推理环境中,负载均衡导致不同请求路由到不同节点,也会引入额外的不确定性。完整记录上述所有配置,是使评测结果具有可比性的最低要求。
结语
Key Takeaways:
- LLM评测分数的不一致性不是偶然的bug,而是采样机制、评测框架实现差异、裁判员模型偏见和基础设施不确定性共同作用的必然结果。
- 将评测结果视为统计分布而非单一点值,是提升决策质量的根本思维转变。
- 不同评测方案(确定性基准、裁判员模型、人工评估)各有适用边界,成熟的评测体系是多种方案的合理组合。
- 评测配置的版本管理与代码版本管理同等重要——这是AI产品工程可信度的基础。
- 公开基准分数与业务场景相关性有限,在真实数据分布上构建任务相关评测,才是可靠模型选型的依据。
如果你的团队正在为如何建立可靠的AI评测体系、或如何在架构层面保障AI产品质量而烦恼,这恰恰是端到端AI系统设计中最值得深入投入的环节之一。
如果你正准备将AI产品从概念推向生产,Darius 提供 AI 架构咨询、系统设计和全栈开发的端到端支持。访问 Darius 的项目与洞见,查看真实落地的工程案例——无论你是早期创始人还是正在扩张的工程团队,欢迎联系,一起构建真正能运转的产品。
参考文献
- 火山引擎开发者社区. "为什么相同提示词,大模型每次返回结果不一样 | AI科普系列".
https://developer.volcengine.com/articles/7502283277103333415 - TesterHome 技术社区. "总有疑问,为什么每次大模型输出的内容不同?".
https://testerhome.com/topics/42022 - 阿里云 PAI 平台. "大语言模型输出结果评测打分 — 裁判员模型".
https://help.aliyun.com/zh/pai/judge-model/
注:上述技术规范与平台文档可能随版本更新,请以各平台最新官方文档为准,或咨询专业工程顾问。