AI API依赖的隐性成本及应对策略
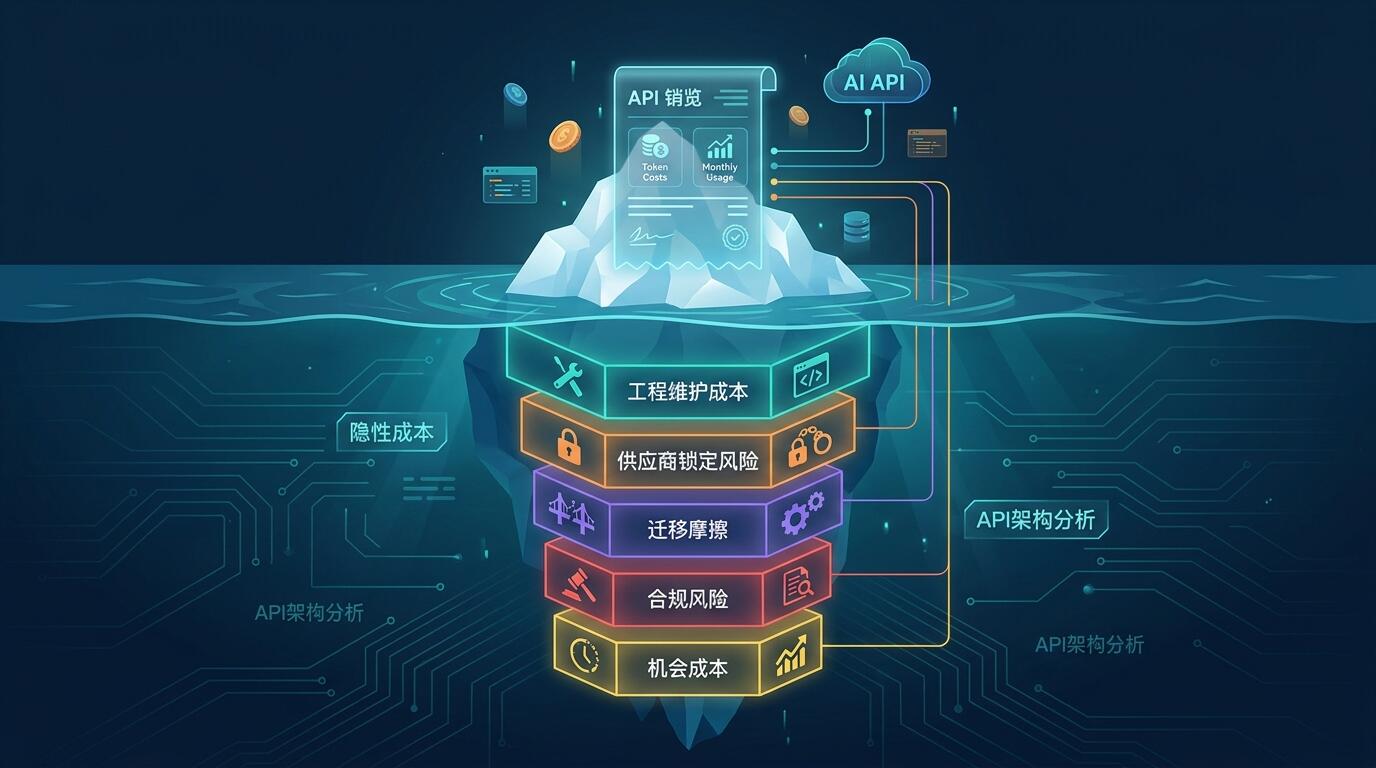
ALT: AI API依赖的隐性成本分析与应对策略,帮助技术团队优化架构设计
你为什么越用越贵:AI API依赖的隐性成本真相
表面上看,接入一个 AI API 只是在代码里加几行调用、按月付一张账单,但在实际工程实践中,这张账单往往只是冰山一角。AI API 依赖的真正成本,绝大部分藏在那些不会出现在账单明细里的地方——延迟抖动导致的产品体验损耗、供应商锁定带来的迁移摩擦、提示词工程的持续人力投入,以及一旦模型策略调整就可能引发的系统级重构。
在与多个技术团队合作的过程中,我们反复看到同一个模式:初期选型时只算了 token 单价,上线之后才发现真正的成本压力来自运营侧、架构侧和组织侧。这篇文章的目标,是把这些隐性成本逐一拆开来看,并给出可以落地的应对策略——不是泛泛的"做好成本管理",而是具体的架构决策与工程取舍。
比较的核心维度将围绕以下三类典型的 API 依赖策略展开:单一供应商深度绑定、多供应商路由分发、以及混合部署(托管 API + 私有模型)。评判标准包括成本可预测性、迁移难度、延迟与可靠性、工程维护负担,以及长期的架构灵活度。
评估 AI API 依赖策略的核心维度
选择 AI API 架构策略,不能只看当下的价格表。以下六个维度,是真正决定长期总拥有成本(TCO)的关键因素。
Token 成本与计费模型的可预测性。 不同供应商的计费粒度差异显著——有的按输入/输出 token 分开计价,有的按请求数计费,有的有最低消费或并发限制。当业务量波动时,一个固定单价的模型实际账单可能比预期高出数倍。根据腾讯云智能体开发平台的企业 AI Agent Token 成本优化实践,Token 消耗量往往受系统提示词冗余、上下文窗口管理不当等因素大幅放大,而这些是纯粹的工程浪费。
供应商锁定程度与迁移成本。 当你的代码深度依赖某一家 API 的特定参数格式、函数调用协议或私有 embedding 向量时,迁移到另一家的代价不是"换个 API endpoint"这么简单,而是涉及提示词体系重写、向量数据库重建、测试集重跑。这部分成本很少被预先量化,但在我们参与的项目中,它往往是最被低估的一项。
延迟稳定性与 SLA 可靠性。 对于面向用户的产品,P99 延迟比平均延迟更重要。公有 API 的延迟往往随全球负载波动,且各家 SLA 的赔偿条款差异很大。系统设计时如果没有做降级与缓存,任何一次上游抖动都会直接影响终端用户体验。
提示词工程与维护人力成本。 这是最容易被忽视的隐性成本之一。每次模型升级、系统提示词都需要重新测试和调优;多个业务场景下的提示词管理如果没有版本控制,会迅速变成工程债务。
合规与数据主权风险。 将用户数据发送给第三方 API,在数据敏感行业(金融、医疗、政务)意味着合规压力。这种风险一旦被监管部门关注,重构成本可能是灾难级的。
架构灵活度与未来演进能力。 AI 模型市场的变化速度极快。一个过度耦合特定供应商的架构,会让团队丧失快速跟进新模型能力的窗口期,付出的是机会成本。
三种主流 AI API 依赖策略
单一供应商深度绑定
单一供应商深度绑定,是指团队将所有 AI 能力(文本生成、embedding、函数调用等)集中在一家 API 提供商上,深度使用其专有特性。这是最常见的初期选择,因为上手最快,文档和社区支持最集中。
典型代表是深度依赖 OpenAI GPT 系列 API 并使用其 Assistants API、Functions、Fine-tuning 等专有功能的系统架构。这种策略在项目早期能快速验证产品方向,但随着业务规模扩大,其隐性成本会逐步浮出水面:迁移壁垒越来越高、对供应商定价策略的谈判筹码越来越低,且一旦供应商发生策略调整(如 API 功能下线、定价大幅提升),整个系统的稳定性都会受到威胁。
根据 ShowAPI 对企业引入 AI 隐形成本的分析,许多企业在早期没有意识到供应商锁定的代价,直到需要迁移时才发现底层数据格式、调用协议与自研系统的耦合程度已经非常深,迁移成本远超预期。
多供应商路由分发
多供应商路由分发策略,是在应用层维护一个模型路由层(Router),根据请求类型、成本阈值、延迟要求,动态将请求分发到不同的 AI API 供应商。
这种策略的核心优势是成本套利与风险对冲:把简单任务路由到价格更低的模型,把高精度需求路由到更强的模型;当某一家 API 出现故障或延迟飙升时,自动切换到备用供应商。代价是架构复杂度的增加——你需要维护多套提示词版本(因为不同模型的响应特性不同)、多套输出解析逻辑,以及一套可靠的路由决策引擎。
在我们实际参与的系统设计工作中,这条路走得好的团队通常有一个共同特征:他们提前定义了清晰的接口抽象层,不把任何模型特有的 API 格式暴露给上层业务逻辑。这让路由层的切换对业务代码透明。
混合部署(托管 API + 私有模型)
混合部署策略是指将部分 AI 能力自部署在私有基础设施(本地 GPU 集群或私有云)上,同时保留对公共 API 的访问作为补充或备用。
这种策略在数据合规要求高、请求量大到自建成本低于 API 费用、或需要对模型本身做定制化微调的场景下尤为适用。其主要挑战在于运维复杂度和初期资本投入:GPU 硬件成本、模型推理服务的运维人力、以及持续的模型更新管理,都是不可忽视的开销。
CSDN OPC 平台收录的实战分析指出,从 API 调用切换到自部署模型,真正的隐性成本往往不在算力本身,而在于从零搭建 MLOps 流程、监控体系和故障恢复机制所需的工程投入,这些是很多团队在决策阶段没有充分评估的部分。
三种策略的正面对比
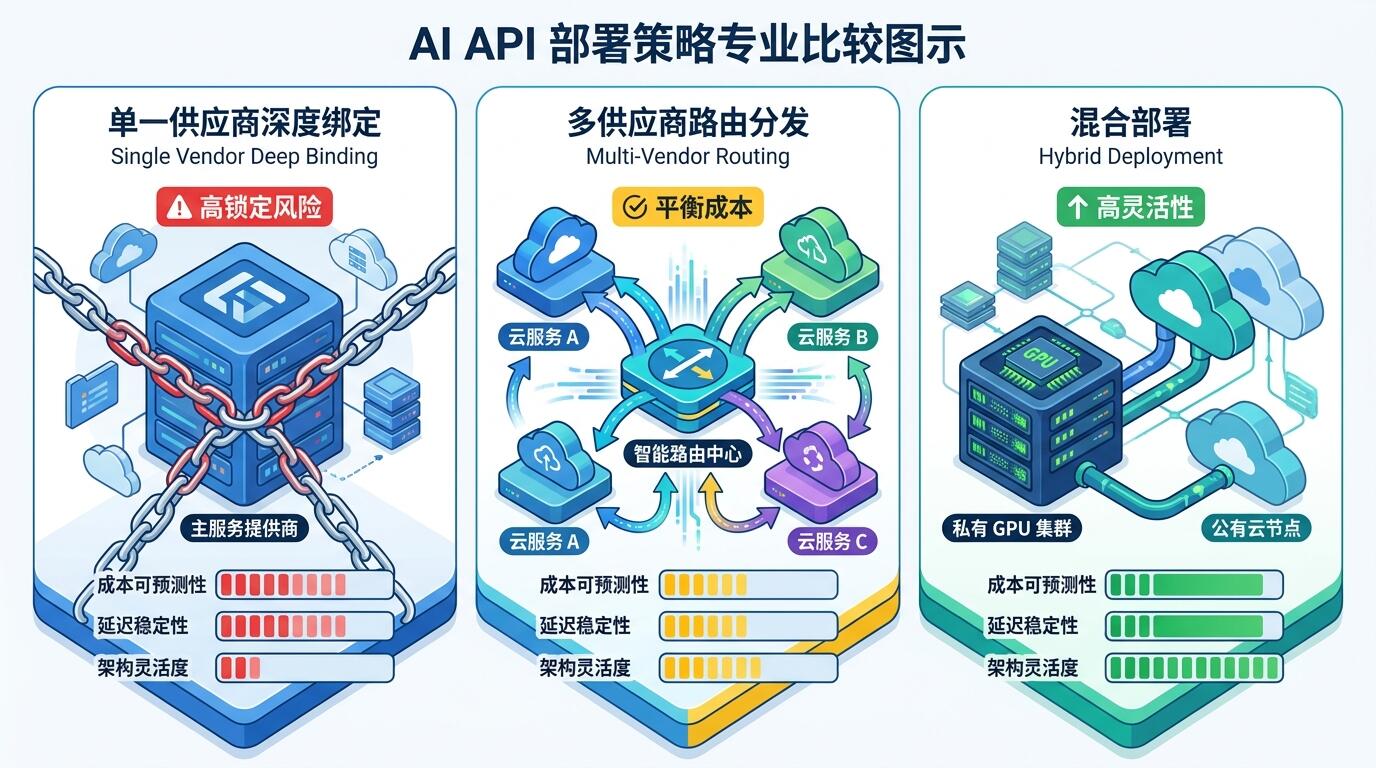
ALT: 单一供应商、多供应商路由、混合部署三种AI API策略的成本、延迟与架构灵活度全面对比
| 评估维度 | 单一供应商深度绑定 | 多供应商路由分发 | 混合部署 |
|---|---|---|---|
| Token 成本可预测性 | 低(受单一定价策略影响大) | 中(可套利但路由决策有成本) | 高(自建部分成本固定化) |
| 供应商锁定风险 | 高 | 低 | 极低 |
| 迁移难度 | 高 | 中 | 低(自建部分完全自主) |
| 延迟稳定性 | 依赖单一供应商 SLA | 中高(可故障转移) | 高(自建部分可控) |
| 工程维护负担 | 低(初期) | 中高(路由逻辑复杂) | 高(运维/MLOps 复杂) |
| 数据合规能力 | 弱 | 中 | 强 |
| 架构灵活度 | 低 | 中 | 高 |
| 适合团队规模 | 小团队 / 早期验证 | 中型团队 / 成长期产品 | 大型团队 / 合规敏感场景 |
从这张对比表可以看出,三种策略并没有绝对的优劣之分,核心是与团队当下的阶段和约束条件匹配。
单一供应商策略的最大优势是速度,但代价是灵活性。 在早期产品验证阶段,这笔交易通常是划算的。问题在于,很多团队在产品规模化之后没有及时重构架构,导致技术债务越积越深,最终迁移成本高到让人望而却步。
多供应商路由策略是大多数成长期产品的最优解,前提是团队要为路由层的工程复杂度买单,并建立起规范的提示词版本管理机制。这条路走对了,能在成本控制和可靠性之间取得较好的平衡。
混合部署策略最适合数据敏感或请求量大到自建经济性明显的场景。 但它需要团队有成熟的 MLOps 能力,不适合作为初期架构选择,除非合规要求已经成为硬约束。
哪种策略适合你:场景化决策建议
如果你是一个两三人的初创团队,正在验证产品方向,选择单一供应商深度绑定是合理的。此阶段的核心目标是速度,而不是架构完美性。但有一个前提建议:从第一天起就在业务代码和 AI 调用之间加一层薄薄的抽象接口,即使现在只接了一家供应商,未来迁移时也能把伤害降到最低。
如果你的产品已经上线并在增长,月度 API 账单已经成为不可忽视的成本项,这是引入多供应商路由策略的信号。重点不是"多接几家 API",而是建立一套清晰的模型能力分级体系:哪些任务用重型模型,哪些用轻量模型,并用路由规则把这套判断自动化。腾讯云智能体开发平台在企业 Token 成本优化实践中也印证了这一思路——通过任务分级和 Token 预算管理,往往能在不降低产品质量的前提下显著压缩成本。
如果你处于金融、医疗或政务行业,或者业务规模已经大到自建推理集群经济上可行,混合部署是值得认真评估的路径。这里的决策关键不是"要不要自建",而是"自建哪一层"——通常的合理起点是先自建 embedding 和向量检索层(这部分请求量大、对延迟敏感且不涉及高度动态的生成能力),再逐步把高频的生成任务迁移到私有推理服务。
对三种策略的整体建议:
- 单一供应商绑定:适合快速验证,但要从一开始就做接口抽象,避免深度耦合专有特性
- 多供应商路由:成长期产品的优先选择,核心投入在路由层的工程质量和提示词版本管理
- 混合部署:合规敏感或规模化场景的长期选择,需要配套成熟的 MLOps 体系
常见问题解答
Q1: 如何量化评估现有 AI API 架构的隐性成本?
评估 AI API 隐性成本需要从四个维度入手:Token 实际消耗量(对比理论最优消耗,找出冗余部分)、工程人力投入(提示词维护、模型升级适配、故障处理)、迁移壁垒(评估切换到另一家供应商所需的代码改动范围)、以及合规风险敞口(是否有数据外发的合规压力)。这四项加总,往往比账单金额高出数倍,是决策时必须纳入的真实成本。
Q2: 多供应商路由策略是否会增加系统复杂度到难以维护的程度?
多供应商路由确实会增加架构复杂度,但这种复杂度是可控的。关键在于在设计初期就定义好统一的模型接口抽象层,让上层业务逻辑对具体供应商无感知;同时建立标准化的提示词版本管理和 A/B 测试框架。如果团队规模有限,可以从"主备切换"的简单路由模式起步,而不必一开始就构建复杂的动态路由系统,根据业务增长逐步演进。
Q3: 什么时候自建私有模型推理服务比使用 API 更经济?
是否自建在经济上取决于请求量规模与模型推理硬件利用率。通常的判断基准是:当公有 API 的月度账单已经足够支付一台专用推理 GPU 服务器的折旧成本时,自建的经济性开始显现。但这个计算需要把运维人力、MLOps 基础设施、模型更新成本一并纳入。在实际工作中我们建议,除非合规是硬约束,否则先通过优化 Token 使用效率和引入多供应商路由来控制成本,再评估是否有必要走向自建。
总结与行动建议
AI API 依赖的隐性成本是一个系统性问题,不是靠"选便宜的供应商"能够解决的。真正的应对策略需要在架构层做决策,而不仅仅是在采购层做选择。
核心要点:
- 账单上的 Token 费用只是 AI API 总成本的一部分,工程维护、迁移摩擦、合规风险和机会成本同样重要
- 接口抽象层是最低成本的防锁定手段,无论当下使用哪家供应商,都应该从第一天起就做
- 任务分级与模型路由是成长期产品控制成本的核心工程杠杆
- 混合部署不是"终极解法",而是特定场景下的合理选择,需要配套 MLOps 能力
- 隐性成本的本质是技术债务的一种形式——提前识别并纳入架构决策,比事后重构便宜得多
下一步建议:对现有系统做一次"AI API 成本审计"——梳理 Token 消耗的实际去向、评估供应商锁定的深度、以及量化工程维护的真实人力投入。这个过程本身,往往就能暴露出最值得优先处理的优化点。
如果你正在寻找一位能够将 AI 创意从零转化为真实运行产品的技术伙伴,Darius 或许正是你需要的人。访问 Darius 的技术作品集与案例,了解更多关于 AI 架构、系统设计与全栈开发的实战思考。让我们一起把想法变成现实。
参考资料
- 腾讯云智能体开发平台. "企业AI Agent Token 成本优化实战指南".
https://adp.tencentcloud.com/zh/blog/enterprise-token-economics-agent-cost-optimization - CSDN OPC. "AI智能体开发隐性成本全解析:从API费用到长期维护的实战".
https://opc.csdn.net/6a2d1982662f9a54cb7e13c0.html - ShowAPI. "AI引入的隐形陷阱:企业忽视的隐性成本分析".
https://www.showapi.com/news/article/69a22ca84ddd79ab670e9655 - IEEE. IEEE Standards Association — 人工智能系统工程与架构相关标准.
https://www.ieee.org/
注:相关标准与行业实践持续演进,建议参阅各机构最新发布的官方文件或咨询专业顾问。