面向小团队的本季度嵌入式搜索功能定价避坑指南
ALT: Small team guide to avoiding pricing pitfalls in embedded search functionality this quarter
小团队如何在采购嵌入式搜索功能时不踩定价陷阱
嵌入式搜索功能的定价结构,是当前 AI 产品采购中最容易让小团队超支的环节之一。这篇指南要回答的核心问题是:在签合同之前,你需要弄清楚哪些定价细节,才能在后续几个月里不被意外账单打乱节奏?
本文面向正在为自己产品集成搜索能力的工程师、技术负责人和独立开发者。如果你的团队规模不大、预算有限,但需要在这个季度做出供应商选择,这篇文章会帮你把常见的定价误区系统梳理一遍。
开始之前:你需要准备什么
嵌入式搜索功能,在这里指的是通过 API 或 SDK 集成到你自己产品中的搜索服务,通常包含向量检索、关键词检索、或两者混合的语义搜索能力。它不是你自己部署的 Elasticsearch,也不是用户直接访问的独立搜索引擎产品,而是嵌入在你产品体验里的一层能力。
在开始比价之前,你需要先把自己的使用场景量化清楚。这个环节大多数小团队会跳过,但它直接决定你后续能不能看懂供应商的报价单。
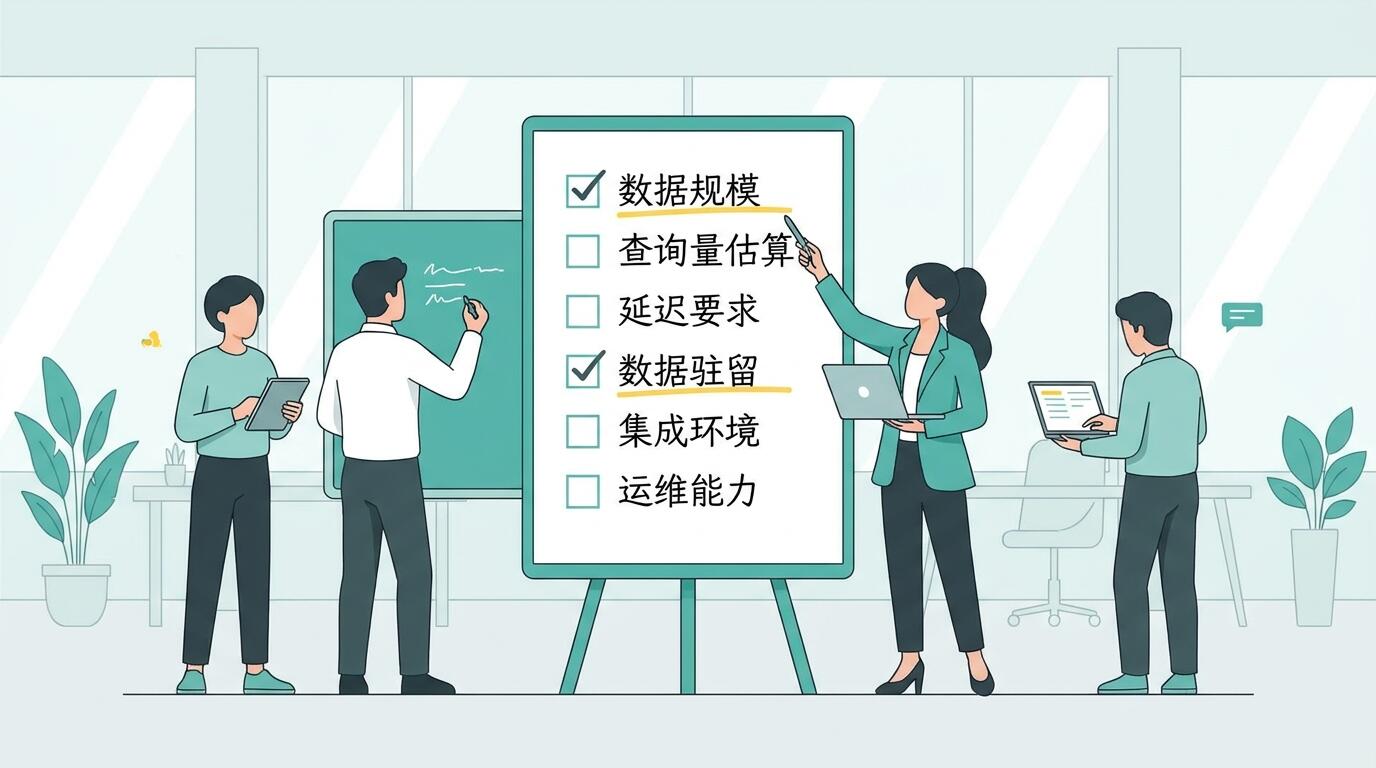
开始前的准备清单:
- 明确你的数据规模:当前需要索引的文档数量,以及预期六个月后的增长量。
- 估算查询量:每日活跃用户大概会发起多少次搜索请求,峰值与均值差距有多大。
- 确定延迟要求:你的用户场景能接受的最大响应时间是多少,这会影响你能不能用批量处理来降低成本。
- 确认数据驻留要求:你的数据能否存储在境外服务器?某些行业或客户合同会对此有明确限制。
- 列出集成环境:你的后端语言、框架,以及是否需要 SDK 而非纯 REST API。
- 了解你团队的运维能力:你们有没有人能维护一个自托管的开源方案,这决定了你的备选项范围。
这套准备工作的完成质量,直接影响你后续步骤的判断精度。粗略估算可以,但数量级不能错。
ALT: Engineering team preparing technical requirements checklist before evaluating embedded search API pricing options for a small AI product
分步骤:系统规避嵌入式搜索定价陷阱
第一步:识别供应商常用的计费维度组合
大多数嵌入式搜索服务的账单,并不是一个简单的"每次查询多少钱",而是多个计费维度叠加的结果。你在比价时,必须把每个供应商的所有计费项都列出来,才能做真正的横向对比。
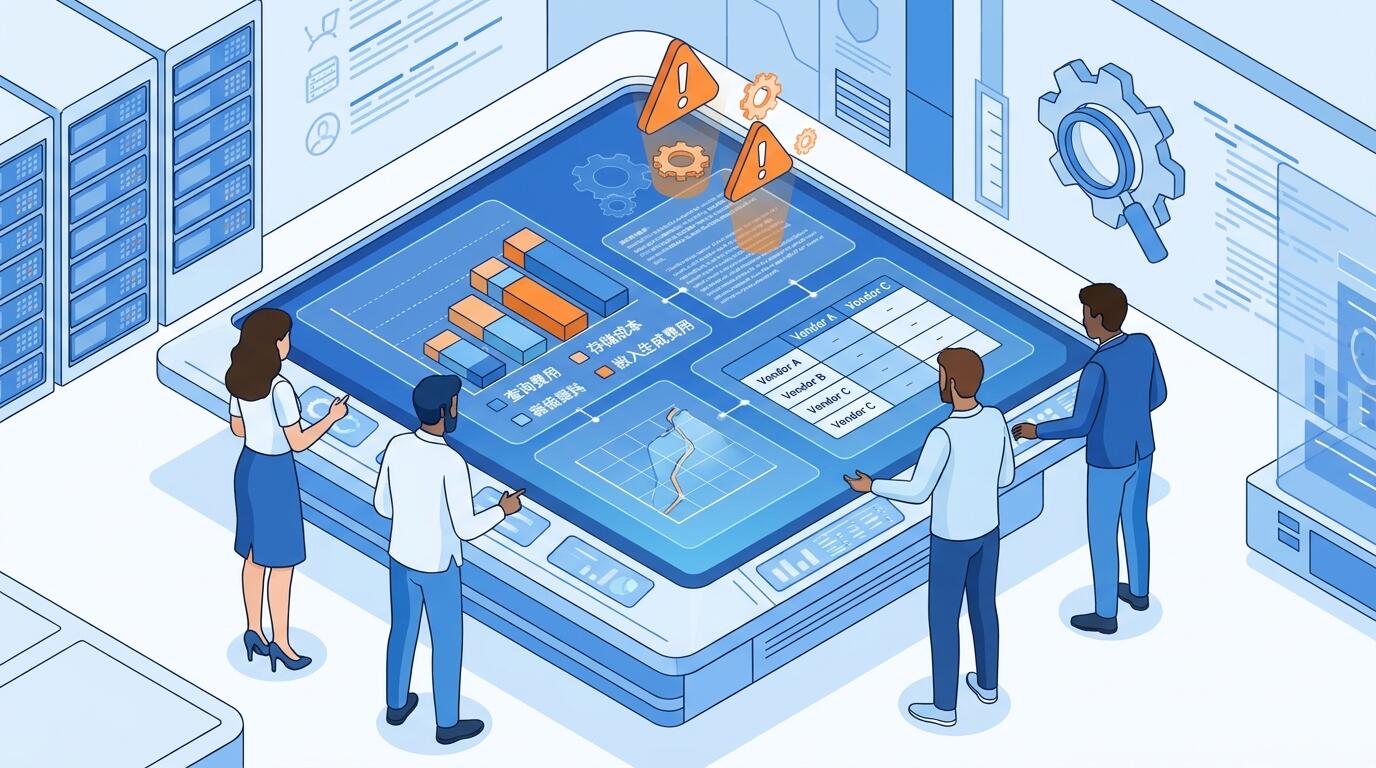
当前市场上主流的计费维度包括:索引文档数量(按存储向量的条数或字节数计费)、查询请求次数(通常按月或按千次计费)、嵌入生成调用次数(如果供应商同时提供 embedding 模型,这是单独一条计费线)、数据入站与出站流量,以及私有部署或专属集群的固定月费。
我们在跟踪多个 AI 产品的运营成本时,反复看到同一个模式:团队只注意到了查询费用,忽视了嵌入生成调用的成本。当文档库需要定期重建索引时,嵌入调用量会在某些月份出现尖峰,这部分费用有时会比查询费用还高。
操作建议: 为每个候选供应商建一张表格,行是计费维度,列是你估算的用量,最后一列是预估月费。不要只看定价页面上的"起步价",那通常是最低档的最优情况。
第二步:辨别免费额度的真实边界
几乎所有供应商都提供免费层(free tier)或试用额度。对小团队来说,这是一个重要的起步窗口,但免费额度的边界设计方式非常影响你后续的迁移成本。
免费额度的常见限制形式有三种:硬性功能限制(例如不支持过滤、不提供访问控制),数量上限(超过某个文档数或查询数自动暂停服务),以及时间限制(试用期结束后即便未超量也需要升级)。
最危险的情况是"功能完整但数量封顶"的免费层。你的团队在免费期内完成了集成和调试,代码和数据结构都已经深度绑定这个供应商的 API,然后在上线前两周发现免费额度不够用,此时议价空间基本为零。
在评估 AI 开发工具时,签约前的关键评估要点之一,就是要在原型阶段结束之前就把付费条款读清楚,而不是等到集成完成之后。
操作建议: 明确问清楚免费层的退出路径。如果超额,服务会暂停还是自动升档计费?有没有过渡期?
第三步:拆解向量存储与查询的分离定价
向量数据库是嵌入式搜索的核心基础设施。当前市场上,部分供应商将向量存储和查询检索分开计费,部分供应商打包计费,还有一些供应商将 embedding 生成、存储、查询三段全部打包。
分开计费的方案在理论上更透明,但有一个常见的坑:按存储的向量维度数计费。高维度的嵌入模型(例如 1536 维或 3072 维)会让存储成本比你用低维模型时高出数倍。如果供应商的定价页面只写"按向量数计费"而没有注明维度假设,你的实际账单可能比预估高很多。
关于向量存储和嵌入成本的实际构成,我之前在一份真实的季度运营账单拆解中有过详细记录,结论是向量维度对存储成本的影响往往比查询量更显著。
操作建议: 询问供应商定价时使用的默认向量维度假设,以及如果你使用高维模型,每条向量的存储成本会如何变化。
第四步:评估超量计费的触发逻辑与速率
超量计费(overage)是让小团队最容易失控的部分。不同供应商的超量逻辑差异很大,主要体现在两个方面:超量单价与套餐内单价的比值,以及超量是按实际用量结算还是按最高峰用量结算。
一个常见但不直观的设计是"预留容量计费":即便你某天的实际查询量很低,但如果你分配了某个容量规格的实例,你就需要按那个规格付费,而不是按实际用量。这种模式在提供专属集群的供应商中尤为常见。
对于流量波动较大的产品,这个问题尤其关键。如果你的搜索请求集中在某几个时段,按峰值预留会造成大量浪费,但按最低档配置又可能在峰值时出现服务降级。
操作建议: 要求供应商给出一个具体场景的账单示例:假设你月均查询量是 X,但某天出现了 3X 的峰值,这个月的账单是多少?如果供应商给不出清晰的答案,这本身就是一个信号。
第五步:核查数据迁移与合同退出的真实成本
锁定效应(vendor lock-in)在嵌入式搜索场景中有其特殊性。迁移成本不只是数据导出的麻烦,还包括重新生成嵌入向量的计算成本。如果你在供应商 A 使用了他们私有的嵌入模型,迁移到供应商 B 时,你的所有向量必须用 B 的模型重新生成,这意味着重新调用嵌入 API 一次,费用可能相当于几个月的存储费用。
合同条款中需要重点核查的条目:最短合同期限与提前终止违约金;数据导出是否有格式限制或速率限制;迁移期间是否提供免费的并行运行窗口。
如果你需要从零开始理解语义搜索的完整技术栈,我们之前整理的一个语义搜索功能从零构建的完整案例可以作为参考,对理解各个环节的成本分布很有帮助。
操作建议: 在合同谈判阶段,明确要求写入数据可携带条款,并确认你的向量可以以通用格式(如标准 JSON 或 Parquet)导出,而不只是供应商私有格式。
第六步:对比自托管开源方案的真实总拥有成本
对于技术能力足够的小团队,自托管开源向量数据库(例如 Weaviate、Milvus、Qdrant 等)是一个值得认真评估的选项。但它的成本并不只是云服务器的费用,还包括工程师的维护时间、高可用配置的额外复杂度,以及出现故障时的排查成本。
一个常见的误判是:拿云服务的月费与自托管的服务器费用做对比,忽略了工程师时间的机会成本。如果你们团队只有两三个人,每个月花十个小时维护基础设施,这十个小时对应的是什么开发进度的损失?
操作建议: 把自托管方案的评估范围扩大到:服务器费用 + 工程师维护时间(按你们团队的时薪折算) + 故障恢复预案的额外复杂度。用这个总数与 SaaS 方案对比,而不是只比服务器成本。
第七步:建立季度性价比复盘机制
定价格局在当前 AI 领域变化相当快。你这个季度签的合同,到下个季度可能已经不是市场上最优的选择。小团队通常没有专职的采购或技术选型人员,容易在初次选定之后就进入"不再回头看"的惰性状态。
建立一个轻量级的季度复盘节奏,不需要每次都走完整的选型流程,只需要在每季度末花两三个小时检查:当前账单的主要构成是否发生了结构性变化;市场上是否出现了值得注意的新供应商或定价调整;你的实际用量是否与当初的假设有显著偏差。
常见误区与排查
| 症状 | 可能原因 | 修复方向 |
|---|---|---|
| 月账单比预期高出数倍 | 忽略了嵌入生成调用是独立计费项 | 把 embedding API 调用量单独统计,检查重建索引的频率 |
| 免费层突然停服 | 触发了数量上限但未收到预警 | 配置用量告警,在达到 80% 阈值时主动介入 |
| 迁移供应商成本远超预期 | 使用了供应商私有嵌入模型,向量无法复用 | 优先选用开放模型生成嵌入,保持向量的可移植性 |
| 峰值期间服务响应变慢 | 配置的并发容量与实际峰值不匹配 | 要求供应商提供弹性扩容选项,或预留更高档配置 |
| 合同续约时价格突然上涨 | 促销价或首年折扣到期,未在合同中锁定续约价格 | 签约时要求写入多年价格保证或续约价格上限条款 |
进阶技巧:超越基础比价的几个判断维度
优先选用对开放嵌入模型友好的供应商。 如果供应商支持你使用自选的嵌入模型(例如 OpenAI 的 text-embedding 系列、或开源的 sentence-transformers),而不是强制使用他们私有的模型,你的迁移成本会大幅降低。这个特性在定价页面上通常不会显著标注,需要主动确认。
把 SLA 折算进总成本。 99.9% 和 99.99% 的可用性承诺对应的年度最大停机时间差了约 9 倍。对于搜索功能是核心体验路径的产品,这个差距直接对应用户流失风险,但两者之间的价格差通常远小于 9 倍。
区分产品定价和企业定价的适用场景。 定价页面上的自助订阅方案,通常没有谈判空间,但如果你的月费超过某个门槛,几乎所有供应商都有销售团队可以谈定制合同。小团队容易错误地认为自己规模不够、没有议价资格,但实际上只要你的用量预期清晰,供应商有足够动机给出更合理的结构。
不要把数据留存期默认当做无限期。 部分供应商对闲置超过一定时间的索引会自动降级或删除。这在文档更新频率低的场景下是一个容易被忽视的风险。
常见误区澄清: 很多团队认为向量数据库的定价主要取决于查询量,因此估算成本时主要关注 DAU 和搜索频率。实际上,在文档规模较大或嵌入维度较高的场景下,存储成本完全可能超过查询成本,两者的比例取决于你的读写模式,而不是单一的用量指标。
常见问题解答
Q1:如何估算我的产品每月需要消耗多少嵌入 API 调用量?
嵌入 API 调用量由两部分组成:初始索引建立时的批量调用,以及后续增量更新时的持续调用。初始调用量等于你的文档总数乘以每文档的分块数。增量调用量取决于你的文档更新频率。如果你的文档库相对静态,嵌入调用的主要成本集中在初始化阶段;如果文档频繁更新,增量调用会形成持续的月度费用。建议先统计过去一个月的文档新增与修改量,以此作为估算基准。
Q2:开源自托管方案适合只有两三人的小团队吗?
自托管方案对小团队是否合适,取决于团队的运维能力和业务阶段。在产品早期,自托管的维护负担可能分散核心开发资源,反而拖慢产品迭代速度。通常建议在用量足够大、SaaS 费用明显高于运维成本时再考虑迁移。如果你们团队有人熟悉 Docker 和基础云运维,可以先用托管方案验证产品,待规模稳定后再评估迁移窗口。
Q3:签约前需要花多少时间做供应商比较?
这个过程通常需要一到两周的实质性工作时间,包括整理自己的用量估算、收集供应商的完整计费说明、搭建小规模的功能验证环境,以及阅读合同条款。跳过任何一个环节都可能导致后续的意外成本。如果你的团队正处于快速迭代期,可以先用一个"够用"的供应商起步,但要确保合同没有长期锁定条款,给自己留下迁移的空间。
核心要点
- 嵌入式搜索的定价结构由多个维度叠加组成,只看查询费用是不够的,存储成本和嵌入生成成本同样需要纳入评估。
- 免费层的边界设计直接影响迁移成本,在深度集成之前必须读清楚超量逻辑和退出路径。
- 向量的可移植性是降低供应商锁定风险的关键,优先选用支持开放嵌入模型的方案。
- 自托管开源方案的真实成本需要把工程师维护时间折算进去,而不只是比较服务器费用。
- 季度性的定价复盘是小团队控制长期成本的低成本手段,值得形成固定习惯。
下一步建议:把你当前候选的供应商逐一套用本文第一步到第七步的框架,先整理出一张完整的计费维度对比表,再进入合同谈判阶段。有了清晰的数字基础,你才有资格在谈判桌上提出有针对性的条款要求。
如果这篇文章对你有帮助,欢迎订阅 Darius(Darius)——这是一份由真正在生产环境中跑着 AI 产品的工程师写给构建者的双语简报,每期精选 5–10 条 AI 要闻,条条附有一手来源与实战解读,帮你把行业噪音过滤成真正可用的判断。直接访问 Darius 网站即可订阅,和数千名同样在一线构建 AI 产品的从业者一起,保持对这个快速演变领域的清醒认知。
参考来源
- IEEE. "IEEE Standards for Artificial Intelligence and Machine Learning Systems."
https://www.ieee.org/ - ACM. "ACM Digital Library — Computing and Information Science Research."
https://www.acm.org/ - NIST. "National Institute of Standards and Technology — AI Risk Management Framework."
https://www.nist.gov/
注:相关标准与行业规范持续更新,建议参考各权威机构最新发布的官方文件。