面向初学者的多模态向量模型入门:召回率实测笔记
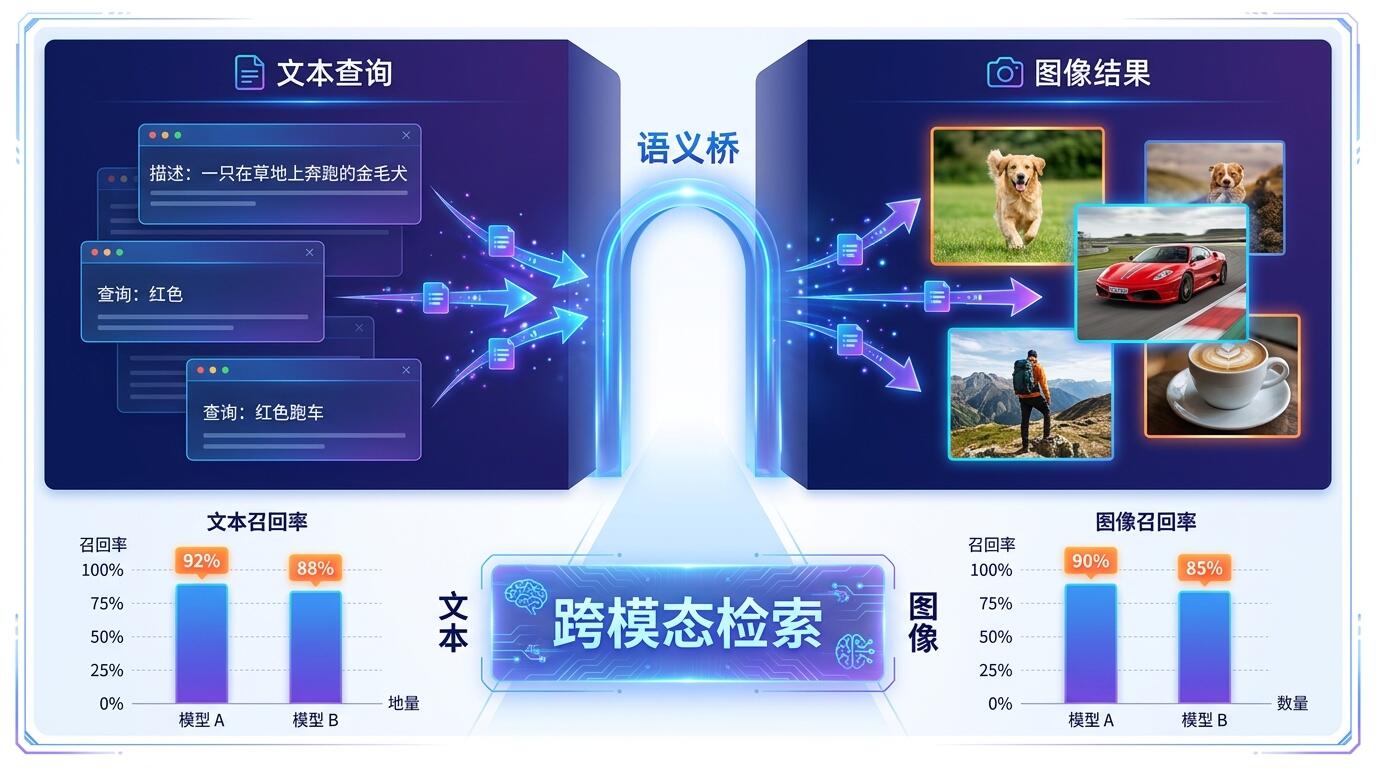
ALT: 多模态向量模型召回率实测笔记,展示文本与图像跨模态检索对比分析示意图
为什么召回率才是多模态检索系统真正的试金石
多模态向量模型(Multimodal Embedding Model)是一类能够将文本、图像、音频等不同类型的数据映射到同一向量空间的模型,从而实现跨模态语义检索。当你第一次把一张照片和一段文字用同一个模型编码,再计算余弦相似度时,会有一种接近魔法的感觉——直到你发现在真实业务场景里,系统的召回率远低于论文里的数字。
这篇文章想做的不是综述,而是把我们在实际运营多款 AI 产品过程中遇到的那些"为什么召回率上不去"的问题拆开来看,给初学者一个可以落地操作的认知框架。核心结论先说:多模态检索的召回率瓶颈,往往不在模型本身,而在数据对齐、索引策略与评测设计之间的系统性失配。
理解这一点,比盲目换更大的模型重要得多。
多模态向量检索的发展脉络与当前现状
多模态向量模型的兴起与大规模对比学习(Contrastive Learning)密不可分。CLIP(Contrastive Language-Image Pre-training)是 OpenAI 在早期发布的代表性工作,它用大量图文对进行训练,让模型学会把语义相近的文本和图像拉到向量空间的近处。这套思路被后续大量工作沿用和扩展,催生了 ALIGN、Florence、ImageBind 等一系列模型。
目前,多模态嵌入模型的应用场景已经相当广泛:电商以图搜图、以文搜图、内容审核、医疗影像报告匹配、多语言跨模态检索……几乎所有涉及"非结构化数据检索"的方向,都会碰到这个问题。
从工程落地角度看,当前的生态有几个明显特征:
- 开源模型质量参差不齐,且评测基准(如 MSCOCO Retrieval、Flickr30K)与业务场景之间存在相当大的分布偏移。
- 向量数据库(Milvus、Weaviate、Qdrant 等)已经相对成熟,但多模态索引策略仍是工程盲区。
- 中文多模态模型的能力与英文模型相比仍有差距,尤其在细粒度语义对齐上。
这意味着:如果你直接拿一个在英文学术基准上 Recall@10 达到 90%+ 的模型,应用到中文电商的以文搜图场景,可能只有 50%~60% 的实际召回表现——这种落差在我们多次亲历的产品集成工作中屡见不鲜。
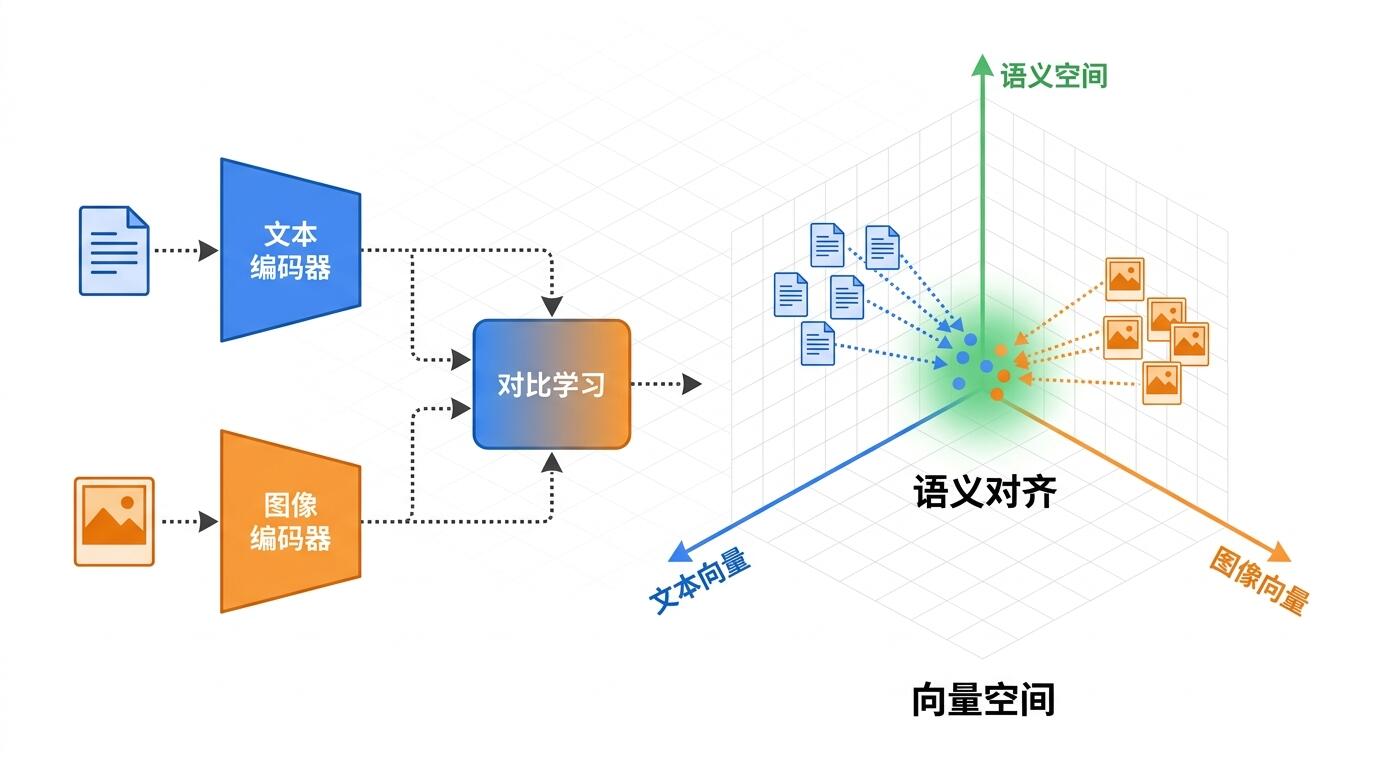
ALT: 多模态向量嵌入空间结构示意图,展示 CLIP 类模型如何将文本与图像特征对齐至统一语义向量空间
召回率为何上不去:机制拆解
召回率(Recall)在检索任务中的定义是:在所有相关文档中,系统成功返回的比例。对于多模态场景,这个指标受到多个层次因素的制约,理解这些机制是优化的前提。
向量空间的模态对齐质量
模态对齐(Cross-modal Alignment)是多模态模型的核心能力,也是召回率的第一层影响因子。即便是质量较好的模型,在特定垂直领域也会出现"语义漂移":模型认为相关的图文对,在业务语义层面并不相关;反之亦然。
以服装电商为例,"宽松版型"这个文本描述,模型可能把它和所有廓形宽大的服装都对齐,但业务上用户想要的可能是特定廓形剪裁。这种细粒度失配,单靠换模型解决不了,需要在数据层做干预。
查询分布与训练分布的偏移
多模态模型的训练数据通常是通用互联网图文对,其分布与业务查询的分布存在明显差异。分布偏移(Distribution Shift)会导致模型在业务场景中的泛化能力下降,表现为:常见物体的检索效果好,垂直领域的长尾查询召回率低。
在我们为某个内容产品做语义检索时,发现模型对用户口语化查询(如"那种很复古感觉的室内照片")的召回效果,远差于结构化关键词查询("vintage indoor photography")。这种差距在中文场景更为突出,因为中文的语义歧义性更高。
索引策略与近似搜索的精度损耗
向量检索通常使用近似最近邻(ANN,Approximate Nearest Neighbor)算法,如 HNSW 或 IVF-PQ。近似搜索的精度损耗是召回率的第二层关键因子。HNSW 在内存充裕时能保持较高的召回率,但 IVF-PQ 在量化压缩后的召回损失有时会超过预期——尤其是当查询向量的分布与建索引时的训练向量分布不匹配时。
常见的工程失误是:用全量数据建 IVF 索引,但只用部分数据训练 quantizer,导致量化中心点偏移,检索精度大幅下降。
评测设计的系统性偏差
很多初学者第一次做召回率评测时,会用"随机负样本"来构建评测集——即从数据库中随机抽取不相关样本作为干扰项。这种做法会严重高估实际的召回效果。真实的检索场景中,干扰项往往是"语义上相近但标签不同"的困难负样本(Hard Negatives),这是模型最容易混淆的区域。
如果评测集没有充分覆盖困难负样本,你得到的 Recall@10 = 85% 可能在业务场景中只对应 60% 的真实表现。这个落差,在我们跟多个团队交流的过程中,是最常见也最容易被忽视的问题。
多角度对比:不同召回优化策略的权衡
提升多模态检索召回率的手段有多种,每种方法的适用场景和代价各不相同。以下是对主流策略的系统对比:
| 优化策略 | 核心优势 | 主要代价 | 最适合的场景 |
|---|---|---|---|
| 微调(Fine-tuning)模型 | 直接提升业务领域的模态对齐质量 | 需要高质量业务标注数据,训练成本高 | 数据充足、垂直领域明确的中大型团队 |
| 困难负样本挖掘(Hard Negative Mining) | 在不改变模型的情况下显著提升区分能力 | 挖掘流程较复杂,需反复迭代 | 已有基础模型、希望低成本提升效果 |
| 重排序(Reranking)层 | 能在粗检索基础上大幅提升精度 | 增加推理延迟,系统复杂度上升 | 对精度要求高、对延迟容忍的场景 |
| 混合检索(Hybrid Search) | 结合稀疏与稠密检索,互补短板 | 索引管理更复杂,需额外工程投入 | 文本查询为主、结构化属性明确的场景 |
| 调整 ANN 索引参数(如 ef_search) | 无需改动模型,工程成本低 | 提升幅度有限,受限于向量质量上限 | 快速验证、预算有限的初期阶段 |
这个表格背后有一个重要认知:召回优化不是单点问题,而是数据、模型、索引、评测四个环节的系统工程。 只在其中一个环节用力,收益往往有限。
关于如何系统性地在数据层做早期验证,在正式开发前用真实用户验证新产品想法这篇文章提供了一套可迁移的方法论,其中的"最小可验证实验"思路同样适用于检索系统的早期评测设计。
从实测角度来看,混合检索(Hybrid Search)是当前性价比最高的起步策略之一:用 BM25 等稀疏检索覆盖精确关键词匹配,再用稠密向量检索覆盖语义相似性,两者融合后的召回率通常比单一策略高出明显幅度,且工程复杂度相对可控。
未来走向与对初学者的实战建议
多模态向量模型的技术演进方向有几条清晰的主线:
统一多模态大模型逐渐从"各模态独立编码再对齐"走向"原生多模态理解"。LLaVA、Gemini 等模型的出现表明,未来的检索系统可能会直接用大模型做重排序,而非训练独立的嵌入模型。这对工程团队的意义是:现在构建的嵌入检索系统,需要预留接入重排序大模型的接口。
评测标准正在向更贴近业务的方向演进。学术界和工业界都在反思"Recall@K on MSCOCO"这类指标的局限性,更细粒度的评测框架(如考虑查询意图、负样本难度分层)正在被更多团队采纳。
对于初学者,以下几点是我们反复见证有效的实践:
第一,先建评测,再建系统。在写第一行检索代码之前,先定义你的评测集构建方式,确保评测集包含困难负样本,且其分布能代表真实业务查询。这一步被跳过的代价,往往在系统上线后才显现。
第二,从最小可行索引开始。不要一开始就追求最复杂的索引结构。用 Flat(精确搜索)建立召回率上界,再逐步引入 HNSW 或 IVF,在每一步测量精度损失,而不是在最后才发现问题。
第三,记录每次实验的完整上下文。模型版本、索引参数、评测集版本、召回率数字,缺一不可。这在快速迭代的早期尤为重要。我们在为自己的产品做语义文件搜索功能时,就曾因为没有记录基线参数,导致优化方向出现混乱,浪费了相当多的排查时间。
多模态检索系统的构建,也是一个典型的检索-验证-发布三阶段流水线——每一阶段都有清晰的质量门控标准,跳过任何一个阶段都会在下一阶段付出加倍的代价。
常见问题解答
Q1:如何为多模态检索系统选择合适的向量模型?
选择向量模型应从业务场景出发,而非单看基准分数。首先确认你的数据语言(中文还是英文)、模态组合(图文、视频文本还是其他),以及领域特点(通用还是垂直)。在开源模型中,CLIP 系列适合快速入门,但中文场景建议优先评估 Chinese-CLIP 或其他本土化模型。任何模型都需要在你自己的业务数据上做评测,不能直接信任论文数字。
Q2:召回率和精确率哪个更重要,需要同时优化吗?
召回率和精确率(Precision)之间存在天然的权衡关系。在检索系统中,通常优先保证召回率(不漏掉相关结果),再通过重排序或过滤提升精确率(减少无关结果)。这两个指标需要结合业务需求来平衡:如果用户容忍度高(如推荐场景),可以更激进地提升召回;如果误召回代价高(如合规审核),则需要在精确率上投入更多。两个指标应该分阶段优化,而非同时追求。
Q3:构建一个基础的多模态检索系统大概需要多少时间和资源?
构建一个最小可验证的多模态检索原型,通常需要数天到数周不等,取决于数据准备的完整程度和团队的工程经验。基础资源需求包括:一个开源嵌入模型(可在消费级 GPU 上运行)、一个向量数据库(Milvus 或 Qdrant 均有免费本地版本)、以及一个覆盖真实查询的评测集。数据准备和评测集构建往往比模型选型耗费更多时间,这一点新手团队常常低估。
总结
多模态向量检索对初学者来说,入门门槛已经大幅降低——开源模型唾手可得,向量数据库文档齐全。但召回率的真正提升,始终是一个系统工程问题,而不是换一个更大的模型就能解决的问题。
三个核心结论:
- 召回率的瓶颈往往不在模型,而在数据对齐质量、索引策略与评测设计之间的系统性失配。
- 困难负样本的评测设计,是区分"实验室好用"和"业务好用"的关键分水岭。
- 混合检索与重排序层的组合,是当前工程实践中性价比最高的优化路径。
下一步的行动建议:先构建你的评测集,明确 Recall@K 的基线数字,再选择优化方向。没有基线就没有优化,这是我们在多款产品迭代中反复验证的第一原则。
如果你正在构建 AI 产品,不想在信息噪音中浪费时间,欢迎订阅 Darius——每期精选 5–10 条真正值得关注的 AI 动态,每一条都附有一手来源与来自实际上线产品的实战解读。中英双语,直达要点,帮你把行业信号转化为真正可用的产品与工程决策。
参考资料与延伸阅读
- IEEE. "IEEE Standards for Artificial Intelligence and Machine Learning".
https://www.ieee.org/ - ACM. "ACM Digital Library — Information Retrieval and Multimodal Learning".
https://www.acm.org/ - arXiv. "arXiv Preprint Server — Computer Vision and Pattern Recognition (cs.CV)".
https://arxiv.org/ - 中国科学院大连化学物理研究所. "智能化工大模型:ChemELLM(大模型技术应用参考)".
https://chemellm.dicp.ac.cn/ - NIST. "National Institute of Standards and Technology — AI Standards and Evaluation".
https://www.nist.gov/
注:相关标准与模型能力持续演进,建议以各官方渠道最新文档为准。