面向创始人的本季度AI云存储选型清单
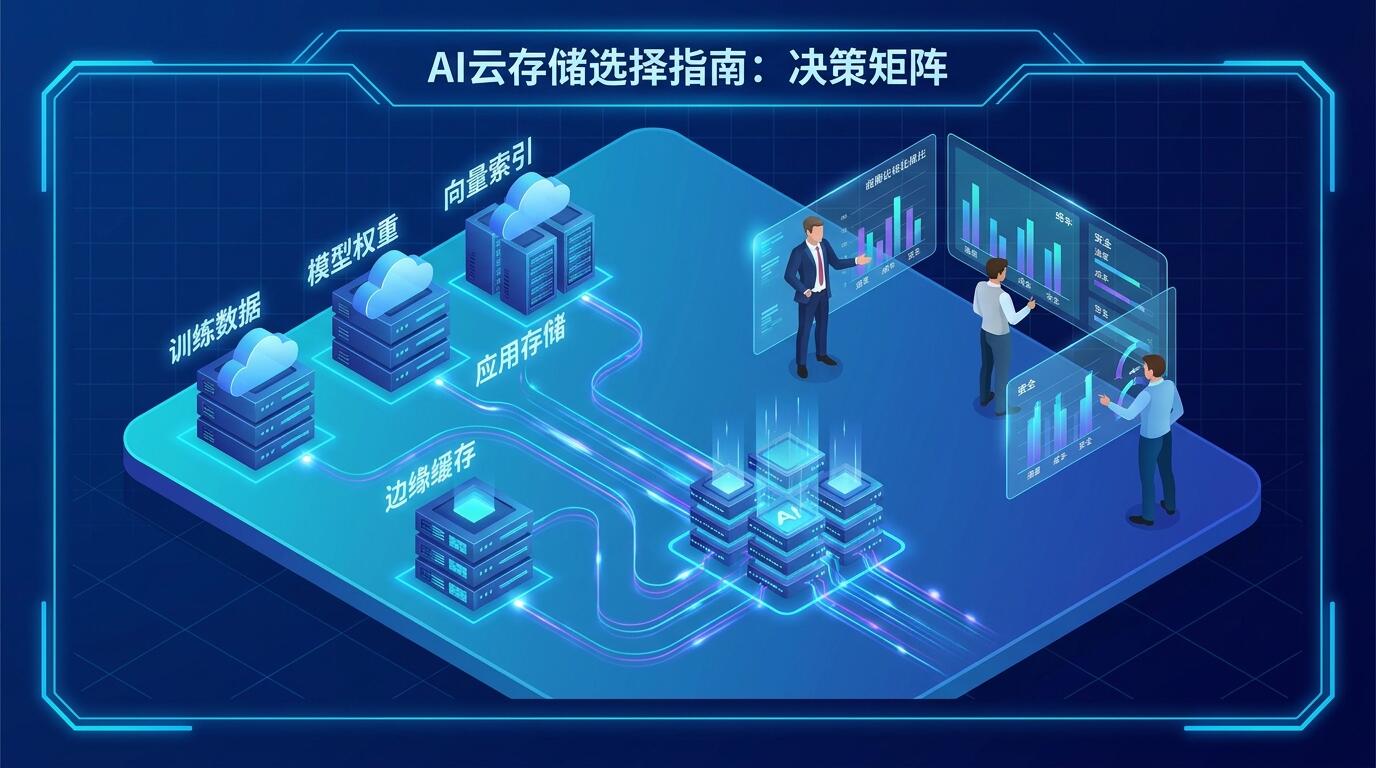
ALT: 面向AI产品创始人的云存储选型清单,对比主流方案帮助团队做出精准决策
AI产品创始人在选型云存储时,最容易犯哪些致命错误
核心结论:AI产品的云存储选型不是一次普通的基础设施决策,它直接影响推理延迟、训练成本、合规风险与长期可扩展性。本文从生产环境中运营AI产品的工程视角出发,梳理本季度主流云存储方案的真实差异,帮助创始人和技术负责人在签约前建立清晰的决策框架,避免因早期选型失误而被迫在中途重构存储层。
AI产品的存储需求与传统SaaS截然不同。训练数据集、向量索引、模型权重、推理日志——这些对象的读写模式、访问频率和规模都与普通业务数据差异悬殊。一个选择错误,可能在六个月后以账单暴涨或系统性能瓶颈的形式找上门来。
我们在实际运营多款AI产品的过程中反复看到同一个模式:早期团队往往以"先用熟悉的方案"为由,用通用云存储凑合处理AI工作负载,直到规模上升后才意识到需要重新设计存储架构。这份选型清单,目的就是让你在动手之前把这些问题想清楚。
这份清单适用于哪些团队
本文面向的读者是正在搭建或已在运营AI产品基础设施的工程团队和技术创始人。以下是更具体的适用边界。
适用场景:
- 正在从零构建AI产品,需要为训练数据、模型权重和向量数据库选择底层存储方案的早期团队
- 已有AI产品但感受到存储成本或延迟压力,考虑迁移或重新分层的中期团队
- 需要在多云或混合云环境中统一管理AI数据生命周期的平台工程师
- 对数据驻留、合规审计有明确要求的企业级AI项目
不适用或需要额外评估的情况:
- 纯边缘推理场景,存储逻辑以设备本地缓存为主,云端需求极为轻量
- 团队尚未确定AI产品的核心技术路线,存储选型过早,决策依据不足
- 受到特定行业监管约束(例如金融、医疗),需要先完成合规评估再做技术选型
为什么AI工作负载对存储提出了不一样的要求
传统云存储选型的核心维度无非是容量、成本和可用性。AI工作负载在这三个维度之外,还额外引入了若干对大多数通用存储方案来说都是"非典型"的需求——正是这些额外需求,让选型变得更复杂。
第一,访问模式高度不均匀。 模型训练阶段对存储的吞吐量要求极高,可能在数小时内密集读取数百GB的训练数据,训练结束后这部分数据可能几周甚至几个月不再被访问。向量搜索场景则完全相反——少量数据被高频随机访问,延迟敏感度极高。用同一个存储层处理这两种模式,几乎必然在成本或性能上出现明显的次优结果。
第二,数据生命周期管理成本不可忽视。 原始训练数据、预处理后的特征数据、模型checkpoint、推理日志,这四类数据的"热度"随时间快速衰减,但衰减节奏各不相同。如果存储方案没有提供细粒度的生命周期策略,或者团队没有主动配置,最终很可能在"冷数据"上持续支付"热存储"的价格。
第三,出口流量费用往往是隐藏杀手。 模型训练时从存储层到计算节点的大规模数据传输,以及跨区域的数据同步,都会产生出口流量费用(egress cost)。在方案对比阶段,这一项经常被低估,却往往在实际账单中占据相当大的比例。
第四,与AI计算服务的集成深度差异显著。 不同云厂商的对象存储与其自身的GPU实例、托管训练服务、向量数据库之间的集成紧密程度差异很大。这种集成深度直接影响数据加载延迟和配置复杂度。
如果你正在评估AI产品的整体技术栈,我们之前在本季度签约前评估AI开发工具的关键要点中详细讨论了如何系统化地审查工具链,存储只是其中一个关键维度。
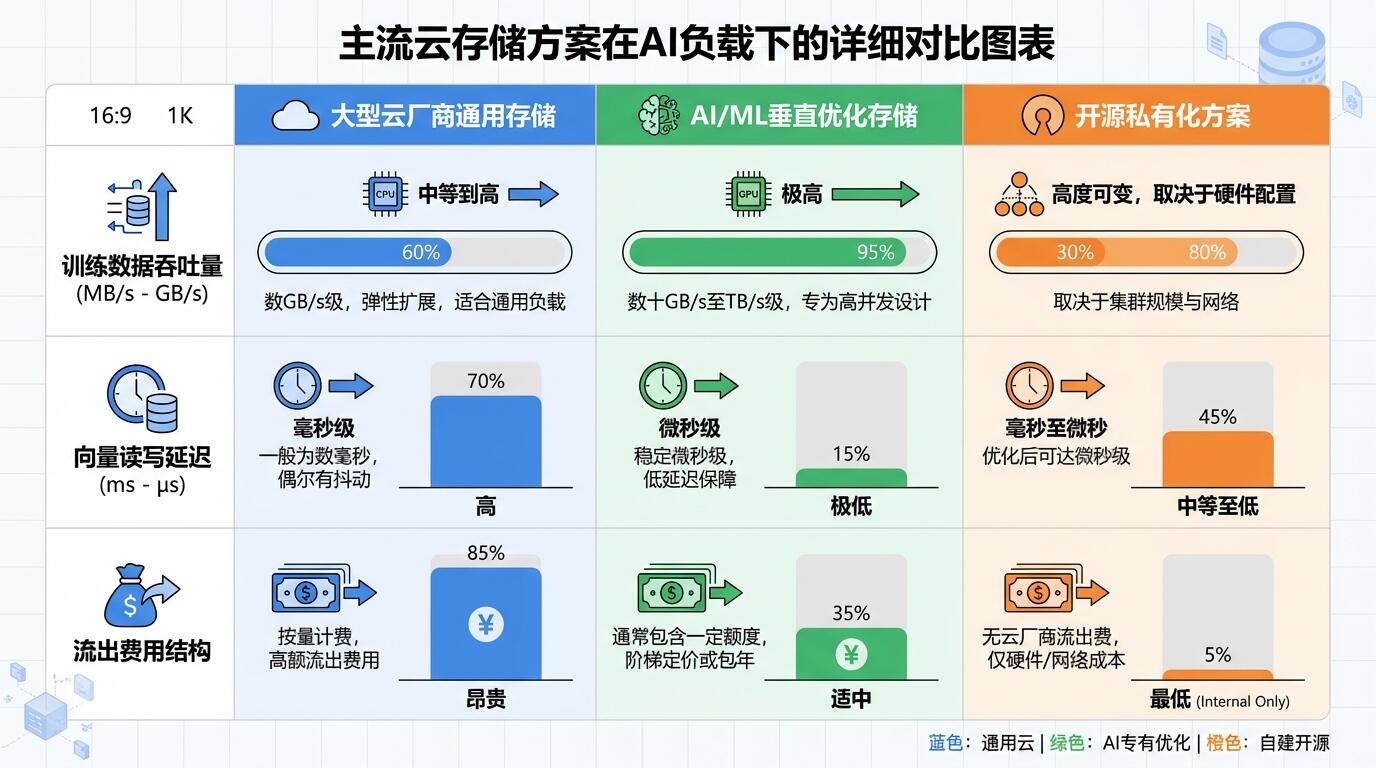
ALT: 主流云存储方案横向对比,涵盖AI训练数据存储、向量数据读写延迟与出口流量成本等关键维度
本季度AI云存储选型的系统化方法
三步建立你的选型框架
第一步:明确你的数据分类与访问模式
在接触任何具体方案之前,先把自己产品的数据资产分类清楚。建议区分四类:训练数据(大体量、批量读取、低频访问)、模型权重(中等体量、按需加载、版本管理需求强)、向量索引(中等体量、高频随机读写、延迟敏感)、推理日志(持续写入、低频读取、有时间衰减需求)。每一类的访问模式不同,对应的存储优化策略也截然不同,混为一谈是最常见的早期错误。
第二步:测算真实的成本结构,而不只是存储单价
存储单价只是成本的一部分。把以下几项全部纳入计算:存储容量费用、请求费用(PUT/GET次数)、出口流量费用(尤其是跨区域)、数据检索费用(针对归档层)、与计算资源的网络传输费用。不同厂商在这几项的定价结构差异很大,只看存储单价会导致严重的成本误判。我们在存储成本与向量成本的真实账单:本季度aipan运营数据公开中公开了实际运营数据,可以作为量级参考。
第三步:验证集成路径与迁移成本
选定方案前,用真实的工作负载跑一次性能测试,而不是依赖厂商提供的基准测试数据。同时评估:如果六个月后需要迁移,数据导出需要多少时间和费用?这一项被忽视的概率极高,但它直接决定了你对某个方案的"锁定"程度。
主流方案横向对比
当前市场上面向AI工作负载的云存储方案,可以大致分为三个类别:大型云厂商的通用对象存储、专为AI/ML优化的垂直存储服务,以及开源或私有化部署方案。以下是主要维度的横向对比:
| 对比维度 | 大型云厂商通用对象存储 | AI/ML垂直优化存储 | 开源/私有化方案 |
|---|---|---|---|
| 与云内计算集成深度 | 高(同厂商生态内) | 中至高(通常提供S3兼容接口) | 低至中(需自行配置网络拓扑) |
| 出口流量费用结构 | 通常较高,按量计费 | 部分方案提供免费出口或包量 | 硬件和带宽成本自担 |
| 大文件批量吞吐性能 | 良好,有优化空间 | 通常针对AI训练场景专项优化 | 取决于硬件配置和网络带宽 |
| 冷数据归档成本 | 有多级存储分层,价格有竞争力 | 部分方案归档能力有限 | 可完全自主控制分层策略 |
| 数据合规与驻留控制 | 主流方案均有区域选择与合规认证 | 需逐一确认合规资质 | 最高级别的自主控制,但合规责任自担 |
| 向量数据原生支持 | 需配合独立向量数据库 | 部分方案开始集成向量检索能力 | 需自行集成,如Milvus/Qdrant等 |
| 运维复杂度 | 低(全托管) | 低至中 | 高(需自行运维) |
| 适合团队阶段 | 早期至大规模均适用 | 中期有明确AI工作负载时切入 | 有专职基础设施工程师的中大型团队 |
这个表格的目的不是给出一个"最优选",而是帮助你根据自身阶段和约束条件找到合理的入手点。早期团队通常优先选择大型云厂商通用方案,原因简单:熟悉、文档完善、集成路径清晰。等到规模上来、成本结构开始压迫利润时,再评估是否迁移到更垂直的方案,这个时序通常是合理的。
几个需要深入评估的关键决策点
数据本地性与计算资源的距离
存储与计算的物理距离(更准确地说是网络拓扑距离)直接决定了模型训练时的数据加载效率。在同一云厂商的同一区域内,对象存储与GPU实例之间的传输通常走内网,速度快且费用低。一旦跨云或跨区域,这个成本和延迟都会急剧上升。如果你的训练集群和存储跨越不同云厂商,务必在正式投入之前测量实际的跨网络传输速率,而不是依赖理论带宽。
关于如何为AI产品搭建具备高效数据检索能力的系统,我如何为个人云盘打造语义文件搜索功能这篇工程实践记录详细描述了存储层与语义检索层的集成方式,值得参考。
多租户隔离与权限粒度
如果你的AI产品涉及多租户(多个客户的数据共用一套存储基础设施),存储层的隔离机制就不只是合规问题,也是产品安全的核心。不同方案在IAM权限粒度、存储桶级别隔离、加密密钥管理上的能力差异很大。评估阶段需要明确:你能否为每个租户配置独立的加密密钥?权限策略的变更是否支持细粒度的审计日志?这些问题如果在选型阶段没有验证,后续补救的成本极高。
数据版本管理与回滚能力
模型迭代过程中,训练数据和模型权重的版本管理往往被低估。存储方案是否原生支持对象版本控制?对于大体量的模型权重文件,版本保留策略如何配置才能在可回滚性和存储成本之间取得平衡?这些问题在早期可能显得不紧迫,但当你第一次需要回滚到三个版本之前的模型,而发现历史权重已被覆盖时,损失就已经发生了。
锁定风险的量化评估
不同存储方案的数据可携带性差异显著。S3兼容的API接口在一定程度上降低了迁移的代码改造成本,但并不意味着零锁定——数据量越大,物理迁移的时间和出口流量费用就越高。在选型阶段,建议明确计算一个"迁移假设成本":如果一年后需要把全部数据迁移到另一个方案,需要付出多少金钱和时间?这个数字会让锁定风险变得具体可见。
进阶考量:超越基础存储层的系统设计
存储分层策略的自动化
多数团队在早期会手动管理数据分层,这在数据量小时可以接受,但会随着规模增长变成一个持续的运维负担。成熟的做法是从一开始就定义好数据生命周期策略,通过云厂商的生命周期管理规则或第三方工具自动将不再活跃的数据从热存储迁移到冷存储,再根据访问频率决定是否归档。这一机制的配置看似简单,但边界条件(如数据被意外触发访问导致提前唤回归档层)往往引发意想不到的成本峰值。
存储与向量检索的协同设计
一个常见的架构误区是把对象存储和向量数据库视为完全独立的层,各自独立选型和优化。但在实际的AI产品中,这两层之间存在密切的数据流动关系:原始文档存储在对象存储中,经过嵌入处理后的向量存储在向量数据库中,检索时需要从向量数据库获取引用、再从对象存储拉取原始内容。这个链路上任何一个环节的延迟都会累加到最终的响应时间中。选型时需要把这个完整链路的端到端延迟纳入评估,而不是只看单个存储层的性能指标。关于智能体如何在检索、验证和发布三个阶段高效处理数据流,我们在智能体流水线深度报告:检索、验证、发布三阶段全解析中有系统性的分析。
一个容易忽视的合规陷阱
GDPR(欧盟《通用数据保护条例》)和各地数据本地化法规对于AI产品的训练数据有明确的管辖范围规定,但许多早期团队在选型时并未将合规审查纳入决策流程。当你的用户数据被用于模型训练时,数据驻留在哪个物理区域、由哪个实体控制,都可能涉及法律义务。选型时需要主动询问:存储方案是否提供数据处理协议(DPA)?数据驻留区域是否支持你的目标市场?这些问题不应该等到法务审查阶段才提出。
常见问题
Q1:如何判断当前的存储方案是否已经成为AI产品的性能瓶颈?
判断存储是否成为瓶颈,最直接的方法是在训练或推理过程中监控GPU利用率。如果GPU利用率在数据加载阶段持续出现明显下跌(即GPU在等待数据),说明存储到计算的数据传输速率已经无法跟上计算需求。另一个信号是对象存储的请求延迟P99分位数持续高于预期。一旦出现这两个信号,需要从数据本地性、存储类型选择和缓存层设计三个维度逐一排查。
Q2:S3兼容API是否真的能实现无缝迁移?
S3兼容API在语法层面确实大幅降低了迁移的代码改造成本,但"无缝"并不准确。不同方案在S3兼容性上的实现深度不同,部分高级功能(如特定的存储类型操作、服务端加密选项、跨区域复制语义)在不同方案之间存在行为差异。更重要的是,API兼容性解决了代码层面的问题,但无法解决数据物理迁移的时间和带宽成本。数据量越大,这个成本就越不可忽视。迁移前务必做一次完整的压力测试和成本估算。
Q3:早期团队应该在什么阶段考虑从通用云存储切换到AI专项存储方案?
从实际观察来看,切换的触发信号通常不是数据量,而是成本结构。当存储和出口流量费用开始在整体云账单中占据显著比例,或者当现有方案的性能特性明显与AI工作负载不匹配时,评估切换是合理的。对于大多数早期团队,在产品验证期保持通用方案的简单性是务实的选择;当月存储账单开始超过可接受阈值,或者出现明显的性能瓶颈时,再启动迁移评估不算晚,但迁移规划需要提前数月进行。
总结
AI产品的云存储选型是一个影响深远但容易被低估的决策。本文梳理了三个核心判断原则:
第一,AI工作负载的存储需求与通用业务截然不同,数据分类和访问模式分析必须先于方案选择。第二,真实的成本结构远比存储单价复杂,出口流量费用和请求费用往往是账单暴涨的根源,必须在选型阶段完整测算。第三,锁定风险需要在早期量化,S3兼容API降低了代码迁移成本,但无法消除数据物理迁移的代价。
下一步行动建议:按照本文提供的三步框架,先对自己的数据资产分类,再对候选方案进行真实工作负载下的性能和成本测试,最后明确计算迁移假设成本,让选型决策建立在可量化的依据上,而不是厂商的营销材料。
如果你正在构建AI产品,或希望每周用最短时间掌握真正值得关注的AI进展,欢迎访问 Darius 双语简报——每一期都由在生产环境中运营多款AI产品的工程总监亲自筛选与解读,帮你跳过噪音、直达对构建者真正有价值的信息。
参考来源
- Amazon Web Services. "Amazon S3 Storage Classes and Lifecycle Policies".
https://aws.amazon.com - Google Cloud. "Cloud Storage for AI and Machine Learning Workloads".
https://cloud.google.com - Microsoft Azure. "Azure Blob Storage and AI Data Management".
https://azure.microsoft.com - European Data Protection Board. "Guidelines on GDPR and Cloud Services Data Residency".
https://edpb.europa.eu - IEEE. "Best Practices for Data Management in Machine Learning Systems".
https://www.ieee.org
注:相关标准与政策可能随时更新,请以各官方机构最新发布文件为准,或咨询专业顾问。