语义搜索小课堂:召回率与精确率对你的文件意味着什么
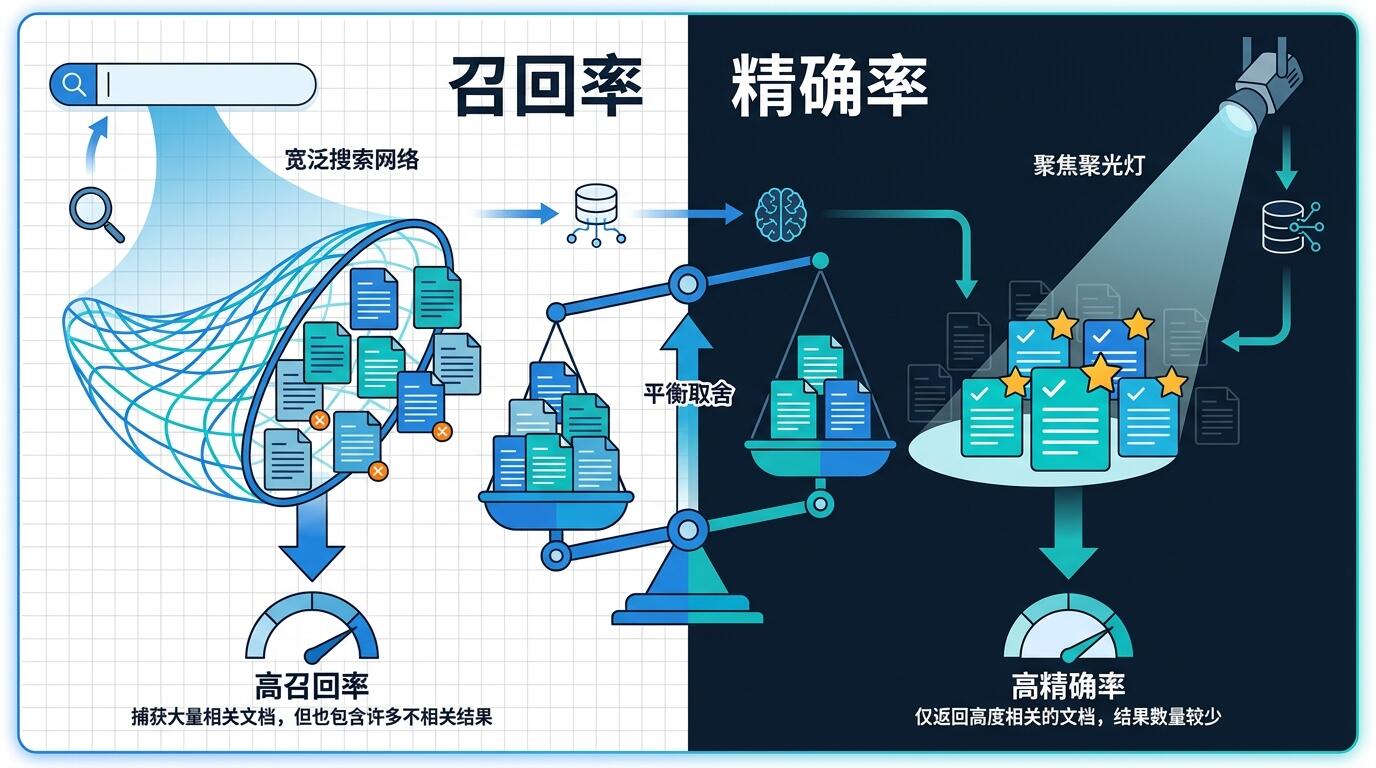
ALT: 语义搜索系统中召回率与精确率权衡示意图,展示文件检索的核心评估指标
为什么你的搜索系统"找到了",但用户却说"没找到"
你的 RAG 系统上线了,向量数据库也接好了,用户输入问题,系统给出了答案。但用户反馈的却是:"明明文档里有这个,怎么搜不到?" 或者相反:"结果太多了,根本不知道哪条有用。" 这两种截然相反的抱怨,实际上指向同一组指标:召回率(Recall)与精确率(Precision)。
理解这两个数字对构建文件搜索功能至关重要。它们不是学术概念,而是你每一次调整 embedding 模型、设定相似度阈值、决定返回多少个 chunk 时,都在隐性操纵的变量。在我们运营 AI 产品的实践中,一个反复出现的规律是:工程师在构建语义搜索时最常犯的错误,不是选错了模型,而是不知道自己在优化哪个方向。
这篇文章是一堂面向实践者的小课堂——不讲公式推导,讲清楚这两个指标在文件搜索场景下到底意味着什么,以及你该如何做取舍。
召回率与精确率:现在的语义搜索为什么需要重新认识它们
传统关键词搜索时代,召回率与精确率的讨论主要停留在信息检索学术圈。语义搜索(Semantic Search)是一种基于语义相似度而非字面匹配来检索文档的技术,它依赖 embedding 模型将文本转换为向量,再通过向量距离计算相关性。
随着 RAG(检索增强生成)架构在 AI 产品中大规模落地,语义搜索成为几乎每个 AI 产品的核心基础设施。但与此同时,一个新的问题出现了:语义搜索"更聪明"了,但工程师反而更难判断它的表现好不好。
为什么?因为关键词搜索的失败很直观——"搜索结果为空"就是没找到。但语义搜索的失败是隐性的:系统可能返回了十条结果,其中七条根本不相关,或者明明有三条关键文档,系统只召回了一条。这两种失败模式,正是精确率低和召回率低的表现。
当前的向量搜索基础设施(Pinecone、Weaviate、Chroma、pgvector 等)已经非常成熟,但它们提供的是"相似度排序"能力,并不自动告诉你精确率和召回率是多少。这个评估工作,需要工程师自己来做,或者在产品层面建立反馈机制。如果你想深入了解检索系统在实际 AI 流水线中的位置,可以参考 智能体流水线深度报告:检索、验证、发布三阶段全解析,那篇文章对检索、验证、发布三个阶段有更完整的拆解。
两个指标的机制:它们在文件搜索里到底衡量什么
召回率:你有没有找到"应该找到的"
召回率(Recall)衡量的是:在所有真正相关的文件中,你的搜索系统实际检索到了多少。用日常语言说,就是"该捞的有没有捞上来"。
举个具体例子。假设你的知识库里有 20 份关于"数据合规"的文档,用户问了一个关于 GDPR 的问题,理论上其中 8 份文档是真正相关的。如果你的系统只返回了 3 份相关文档(不管同时还返回了多少不相关的),那召回率就是 3/8 = 37.5%。
在文件搜索场景下,召回率低意味着:用户要找的答案其实在你的文档库里,但系统没把它找出来。这是最致命的失败模式——用户会失去对系统的信任,认为"这个 AI 根本不懂我的文档"。
召回率受多个因素影响:embedding 模型对领域语义的覆盖程度、chunk 切割策略(过短的 chunk 可能丢失上下文语义)、相似度阈值设定(阈值太高会过滤掉相关但表述不同的文档),以及检索返回的 Top-K 数量。
精确率:你返回的结果有多少是真正有用的
精确率(Precision)衡量的是:在你返回的所有结果中,真正相关的占多大比例。用日常语言说,就是"捞上来的有多少是鱼,有多少是垃圾"。
还是那个例子。系统返回了 10 条结果,其中只有 3 条真正与 GDPR 问题相关,那精确率就是 3/10 = 30%。
精确率低的后果稍微隐性一点,但同样严重。在 RAG 架构里,如果你把大量不相关的 chunk 塞给 LLM,它要么给出混乱的答案,要么因为 context 噪音太多而忽略真正关键的信息。而且,token 是有成本的——低精确率直接意味着更高的推理开销。
精确率受相似度阈值、重排序(reranking)机制、查询改写质量的影响最大。
召回率与精确率的天然张力
召回率与精确率之间存在天然的反向关系——这是信息检索领域的基本规律,在 Google 机器学习工程师文档中有明确描述。想提高召回率,通常需要降低相似度阈值、增加 Top-K 返回数量,这会引入更多不相关结果,精确率下降。反之,收紧条件提升精确率,又容易漏掉表述不同但实际相关的文档。
这个权衡没有统一的最优解,取决于你的业务场景对哪种失败更不可接受。
场景对比:精确率优先还是召回率优先,文件场景的真实取舍
不同的文件检索场景对这两个指标的侧重完全不同。下面是我们在实践中总结的对比框架:
| 场景 / 方法 | 优势 | 代价 | 最适合 |
|---|---|---|---|
| 高召回率优先(低阈值、大 Top-K) | 不漏掉关键文档,覆盖表述多样的查询 | 精确率低,LLM 收到大量噪音,token 成本高 | 合规审计、法律文档检索、不能漏答的场景 |
| 高精确率优先(高阈值、小 Top-K) | 结果干净,LLM 答案质量高,成本低 | 容易漏掉相关但措辞不同的文档 | 问答机器人、FAQ 系统、用户对结果数量敏感的场景 |
| 重排序(Reranking)辅助 | 召回阶段保高覆盖,精排阶段提质量 | 增加延迟和额外模型成本 | 对质量和覆盖率都有要求的企业知识库 |
| 混合检索(Hybrid Search) | 结合关键词精确匹配与语义覆盖 | 系统复杂度更高,调优参数更多 | 专业术语多、缩写多的技术文档场景 |
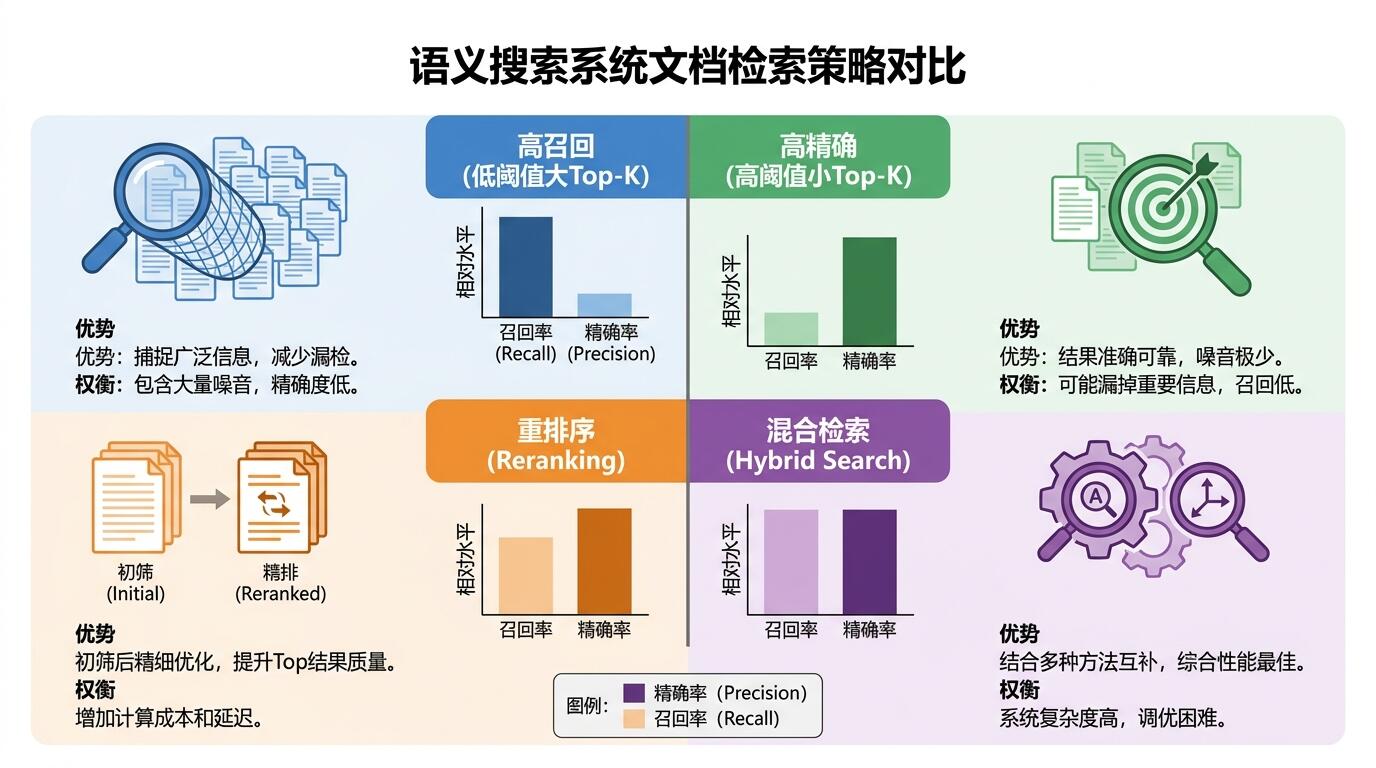
ALT: 文件语义搜索系统中四种检索策略的召回率精确率权衡对比,涵盖重排序与混合检索方案
在我们实际构建个人云盘语义搜索功能的过程中,最初采用的是单纯语义向量检索,在技术文档场景下很快发现:用户输入精确的产品型号或函数名时,语义召回效果明显不如关键词匹配。这类场景的解法不是继续调整 embedding,而是引入混合检索。完整的构建过程可以参考 我如何为个人云盘打造语义文件搜索功能,里面有从选型到上线的完整记录。
对于大多数文件搜索场景,我们观察到一个反复出现的模式:在召回阶段慷慨、在精排阶段严格,是比较稳健的起点。具体来说,用低阈值检索 Top-20 到 Top-50 的候选文档,再用 cross-encoder 重排序模型过滤到最终 3-5 条,既能保证覆盖率,又能控制 LLM 的输入噪音。
你该如何在自己的系统里度量和提升这两个指标
明确目标是提升召回率还是精确率,需要你先建立一套评估基准。以下是在生产环境中切实可行的步骤:
第一步:构建标注测试集。 从你的真实文档库中选取有代表性的查询,人工标注哪些文档是真正相关的。这个集合不需要大,但必须覆盖用户实际使用的查询模式——专业术语、口语化表述、跨语言混合表述都要有。
第二步:量化当前基线。 用现有系统跑测试集,计算每个查询的精确率和召回率,再取平均。这个基线数字是后续一切调优的参照点。没有基线,你无法判断改动是在帮倒忙还是真的有效。
第三步:定位瓶颈在哪一层。 召回率低,先排查 chunk 策略和 embedding 模型——chunk 太小导致语义碎片化,或者模型对你的领域语料不熟悉,都是常见原因。精确率低,先排查阈值设定和重排序是否到位。Microsoft Azure 语言服务的官方文档对文本分类模型的评估指标有系统的讲解,这套思路同样适用于检索场景。
第四步:一次只改一个变量。 工程经验表明,同时调整 chunk 大小、embedding 模型、阈值和 Top-K,会让你完全无法判断哪个变量产生了效果。单变量对照实验,是在搜索系统调优中保持理智的唯一方式。
第五步:建立持续监控机制。 上线后,通过用户行为信号(点击了哪条结果、是否追问、是否表示答案有用)建立隐性反馈数据,定期重新评估精确率和召回率。用户的实际行为比一次性测试集更真实,因为它反映的是生产环境中的查询分布。
精确率与召回率的权衡,本质上是一个持续校准的过程,而不是一次性的架构决策。在 Ultralytics 等机器视觉领域的实践中,这两个指标的权衡方法论同样被广泛应用,其核心原则与文本检索场景高度一致:为你的业务场景定义"哪种错误更不可接受",然后以此为导向调整参数。
常见问题
Q1:如何判断我的语义搜索系统当前的召回率和精确率是否达标?
判断标准取决于你的具体场景,没有通用的"达标线"。实用做法是:先建立一个小型标注测试集(50-100 个查询),人工标注相关文档,然后运行系统计算实际指标。如果你的系统用于不能漏答的场景(如合规、法律),召回率应当是优先保障的指标,通常需要达到较高水平;如果用于面向用户的问答,精确率更重要,因为结果噪音直接影响用户体验和 LLM 的输出质量。Google 机器学习工程文档中对精确率与召回率的场景适用性有详细说明。
Q2:重排序(Reranking)模型真的能同时提升召回率和精确率吗?
重排序本身不改变召回阶段的覆盖范围,因此不会直接提升召回率。它的作用是在已召回的候选集内提升排序质量,从而提升精确率——让真正相关的文档排在前面,让 LLM 优先看到最有价值的内容。正确的组合是:在召回阶段用低阈值保证高覆盖(高召回率),再用重排序模型在候选集内精选(高精确率)。这两步分工明确,是目前生产级 RAG 系统中最常见的架构模式。
Q3:调整 chunk 大小会对召回率和精确率产生多大影响?
Chunk 策略对这两个指标的影响非常显著,但方向不是单一的。Chunk 过小(比如按句子切割)会导致每个向量携带的语义信息不完整,系统可能找不到完整语义匹配的块,召回率下降;Chunk 过大(比如整页切割)会让向量过于"平均",相似度计算的区分度下降,精确率变差。在我们的实践中,针对不同文档类型(结构化表格 vs. 长篇叙述文本)需要分别设定 chunk 策略,没有放之四海而皆准的参数。
总结
语义搜索系统的好坏,不能只凭"能返回结果"来判断。召回率与精确率是衡量文件检索质量的两个核心维度:召回率告诉你有没有把该找的文件捞上来,精确率告诉你捞上来的里面有多少是真正有用的。
三个关键结论:
第一,召回率与精确率之间存在天然张力,提升一个通常会压低另一个,工程师需要根据业务场景明确优先级,而不是盲目追求"都高"。
第二,"召回阶段慷慨、精排阶段严格"是目前生产级 RAG 系统中最经过验证的平衡策略,通过重排序模型分离两个目标。
第三,没有标注测试集和量化基线,任何调优都是在黑暗中摸索。建立评估机制是真正改善检索质量的前提。
下一步建议:从你现有的文档库中选取 50 个有代表性的查询,用人工标注建立基线测试集,运行一次评估,把当前的召回率和精确率数字写下来。有了这个数字,你才知道接下来该动哪个旋钮。
如果你正在构建 AI 产品,不想在信息噪音中浪费时间,欢迎订阅 Darius 简报——每期精选 5–10 条真正值得关注的 AI 动态,每条均附一手来源与来自生产环境的实战解读。由一位同时运营三款 AI 产品的工程总监亲笔撰写,帮你把最新的模型发布、论文与政策变化,直接转化为可执行的产品决策。
参考来源
- Google for Developers. "分类:准确率、召回率、精确率和相关指标 | Machine Learning".
https://developers.google.com/machine-learning/crash-course/classification/accuracy-precision-recall?hl=zh-cn - Ultralytics. "准确率、精确率和召回率:分别适用于什么场景".
https://www.ultralytics.com/zh/blog/accuracy-precision-recall - Microsoft. "自定义文本分类模型概念 - Foundry Tools".
https://learn.microsoft.com/zh-cn/azure/ai-services/language-service/custom-text-classification/concepts/evaluation-metrics - IEEE. 信息检索与机器学习相关标准与文献.
https://www.ieee.org/ - ACM Digital Library. 信息检索(IR)领域核心学术文献.
https://www.acm.org/
注:相关标准与技术规范持续更新,建议参阅各权威机构最新官方文档或咨询专业顾问。