生产级应用上线后的运营与维护完整清单
ALT: 生产级应用上线后运营与维护完整清单,涵盖监控、告警、部署、安全与日志管理
上线只是开始:为什么生产级应用的运维清单至关重要
核心结论:生产级应用正式上线后,真正的工程挑战才刚刚开始。缺乏系统化运维清单的团队,往往在事故响应、性能劣化、安全漏洞和依赖腐化等问题上付出高昂代价。一份结构化的运营与维护清单,是将"跑起来的产品"转变为"可持续交付价值的系统"的关键基础设施。
许多团队在产品上线的那一刻长舒一口气,误以为最难的阶段已经过去。但在实际工程实践中,我们反复看到同一个规律:上线之前的构建工作,决定了产品能否运行;上线之后的运维体系,决定了产品能否持续创造价值。没有完整运维清单支撑的生产系统,是一颗定时炸弹,而不是一个成熟产品。
生产级系统的现状:从"能跑"到"可靠运行"的鸿沟
生产级应用(Production Application)是指已经部署到真实环境、面向真实用户提供服务的软件系统。与开发环境或测试环境不同,生产系统的每一次故障都直接影响用户体验、业务收入乃至品牌信誉。
当前技术环境下,系统复杂度持续攀升。微服务架构、云原生部署、AI 推理服务的引入,使得生产系统的依赖链条比五年前复杂数倍。与此同时,用户对系统可用性的期望却只增不减——任何超过几分钟的服务中断,都可能引发用户流失和口碑损耗。
按照 IEEE 软件工程标准的相关指导原则,软件生命周期中的运维阶段(Operations & Maintenance Phase)往往占据整个生命周期总成本的绝大部分。这意味着,上线只是软件生命周期的起点,而非终点。
中国证监会发布的《证券期货业研发运营一体化体系建设指南》明确指出,研发与运营的一体化(DevOps)是保障生产系统稳定性的核心机制,强调监控、变更管理与事故响应流程的规范化。这一要求在金融领域已有明文规定,对其他行业的工程团队同样具有重要参考价值。
对于初创团队和快速成长的技术组织而言,最常见的陷阱是:把所有精力投入到功能开发,把运维当作"以后再说"的事项。结果是,当系统规模扩大后,运维债务与技术债务叠加,往往需要付出数倍的代价来补救。
完整清单的核心机制:六大支柱逐一拆解
一套完整的生产级运维清单,应当覆盖以下六个核心领域。每个领域都有其独特的风险点和最佳实践,缺一不可。
可观测性:监控、日志与追踪
可观测性(Observability)是指通过系统外部输出来推断系统内部状态的能力,通常由指标(Metrics)、日志(Logs)和链路追踪(Traces)三个维度构成。
指标监控层面,需要覆盖基础设施指标(CPU、内存、磁盘、网络)、应用层指标(请求量、响应时间、错误率)以及业务层指标(用户转化率、核心业务流程完成率)。仅仅监控服务器资源是远远不够的——我们在实际项目中发现,许多故障在基础设施指标正常时,已经悄悄侵蚀了业务层的关键指标。
日志管理需要解决的核心问题是:日志要能被检索、要有结构化格式(JSON 而非纯文本)、要有合理的保留策略。未结构化的日志在问题排查时几乎没有实用价值,这是初级团队最常犯的错误之一。
链路追踪对于微服务架构尤为重要。当一个请求经过多个服务时,如果没有分布式追踪,定位问题的根源会耗费大量时间。OpenTelemetry 是目前业界广泛采用的开放标准,值得优先考虑。
告警与事故响应
告警体系的核心原则是:告警应当可操作(Actionable),而非制造噪音。我们见过太多团队因为告警规则设置过于宽松,导致工程师对告警产生疲劳,真正的问题反而被淹没在噪音中。
一套健康的告警体系需要定义清晰的告警级别(P0/P1/P2/P3),并为每个级别配备对应的响应流程(Runbook)。On-call 轮班机制、升级路径(Escalation Path)、事后回顾(Post-mortem)文化,是事故响应能力成熟的三个标志。
事故发生后的 Post-mortem 不是追责,而是系统性改进的起点。每一次生产事故都是一次免费的压力测试,记录下来并转化为系统改进,才是正确的处理方式。
部署与变更管理
持续交付(Continuous Delivery)是指能够随时将代码安全部署到生产环境的工程能力。这不仅仅是 CI/CD 流水线的问题,更是整个变更管理体系的问题。
生产环境的每一次变更,都应当是可追溯、可回滚的。蓝绿部署(Blue-Green Deployment)、金丝雀发布(Canary Release)、功能开关(Feature Flag)是控制变更风险的三种常用机制,根据团队规模和系统复杂度选择合适的策略。
变更管理中最常见的风险是"凌晨紧急热修复":在没有充分测试的情况下,直接修改生产环境。这种操作引发二次事故的概率远高于常规发布,应当通过流程约束来尽量避免。
安全运营
生产安全是一个持续过程,而非一次性检查。上线后的安全运营清单应当包括:依赖库的定期漏洞扫描(CVE 跟踪)、访问权限的最小化原则(Least Privilege)、密钥与凭证的轮换机制、以及安全审计日志的独立存储。
AI 推理服务在生产环境中还面临额外的安全挑战:模型版本管理、输入验证(防止 Prompt Injection)、以及推理结果的审计追踪,都是传统 Web 应用中不存在的新课题。这是当前许多团队容易忽视的盲区。
容量规划与性能优化
容量规划(Capacity Planning)是指基于现有流量趋势,提前预测并配置系统所需资源的过程。反应式扩容(故障发生后才扩容)是不成熟运维的典型特征;主动式容量管理才是可靠系统的标志。
性能基准测试(Baseline Performance Testing)应当在上线后持续进行,而不只是上线前做一次。系统的性能特征会随着数据量增长、用户行为变化而改变,定期的性能回归测试是发现劣化趋势的有效手段。
数据备份与灾难恢复
灾难恢复(Disaster Recovery)体系的核心指标是 RTO(Recovery Time Objective,最大可接受恢复时间)和 RPO(Recovery Point Objective,最大可接受数据丢失量)。这两个指标必须在上线前与业务方对齐,并通过定期演练来验证。
备份策略应当遵循 3-2-1 原则:至少三份副本、存储在两种不同介质上、其中一份在异地。更关键的是,备份必须定期做恢复演练——从未验证过的备份,在真正需要时极可能无法使用。
不同运维策略的对比与权衡
不同规模的团队在面对运维体系建设时,往往面临资源投入与保障能力之间的权衡。以下是几种常见策略的对比分析:
| 策略 / 视角 | 优势 | 权衡 | 最适合 |
|---|---|---|---|
| 全自动化 SRE 体系 | 人工干预最少,响应速度快,可扩展性强 | 前期建设成本高,需要专职 SRE 团队 | 中大型团队,用户规模较大的产品 |
| 轻量 DevOps(开发者自运维) | 灵活,响应链路短,成本低 | 对个人能力依赖高,On-call 负担重 | 早期初创团队,功能快速迭代阶段 |
| 托管服务优先(Managed Services) | 降低基础设施运维负担,可靠性有保障 | 供应商锁定风险,定制化能力受限 | 非技术核心业务,需要快速上线的产品 |
| 混合模式(核心自建 + 边缘托管) | 平衡控制力与成本,灵活组合 | 架构复杂度增加,需要清晰的边界划分 | 有一定技术深度、追求性价比的成长期团队 |
在我们参与的实际项目交付中,最常推荐成长期团队采用混合模式:将核心业务逻辑和数据层自主掌控,将监控、日志、CI/CD 等工程基础设施优先选用成熟的托管方案。这一策略能够在有限的工程资源下,快速建立起体面的运维能力基线。
正如 从三个产品想法到全部落地上线的工程实践 中所总结的,技术选型的务实性——在正确的时机用正确的工具——往往比追求完美架构更能决定产品的最终成败。
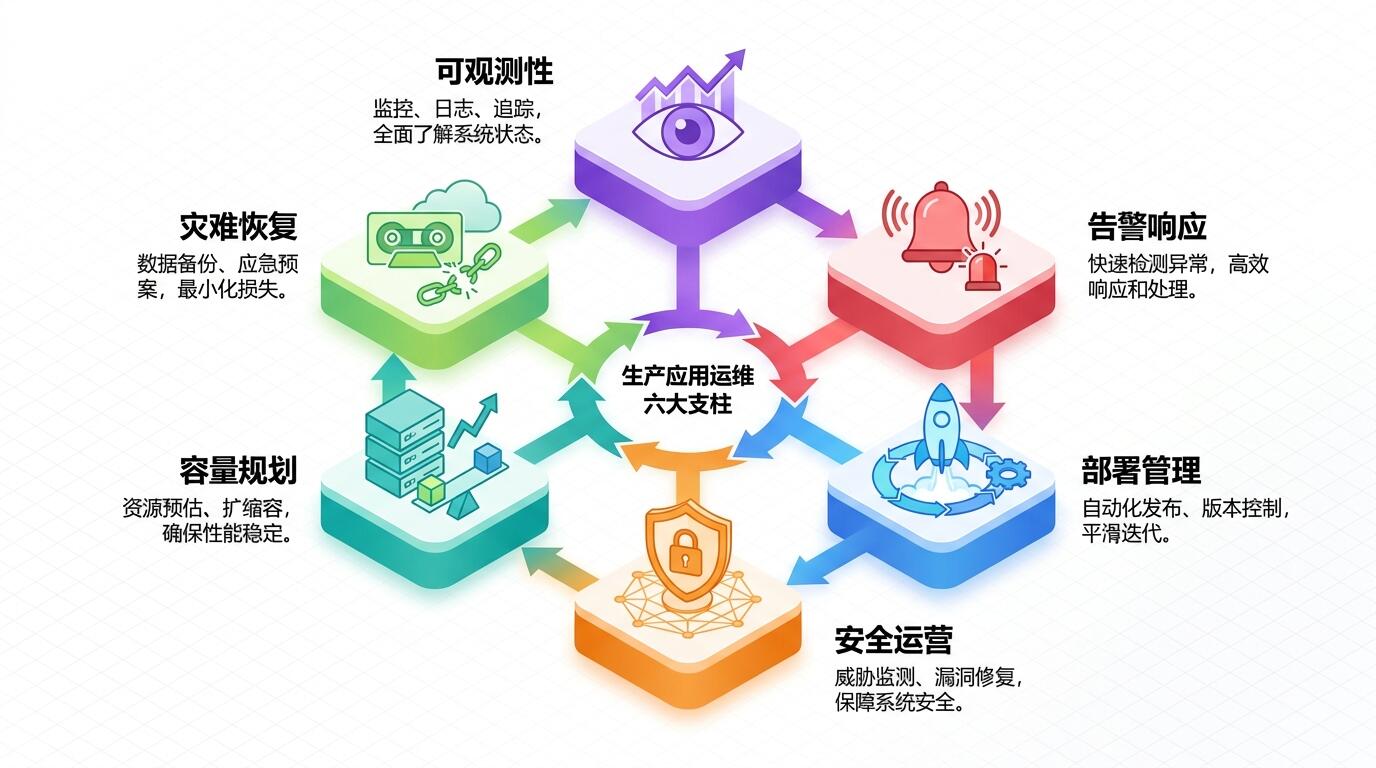
ALT: 生产级应用运营维护六大支柱:可观测性、告警响应、部署管理、安全运营、容量规划与灾难恢复
趋势与行动方向:运维清单如何随系统演进
当前,随着 AI 推理服务被大量集成进生产系统,运维清单正在经历一次重要扩展。传统 Web 应用的运维框架需要增加模型版本漂移(Model Drift)监控、推理延迟分级告警、向量数据库的健康检查等新维度。这是当前技术环境下运维工程师面临的新课题。
基础设施即代码(Infrastructure as Code)的普及,使得运维配置本身也纳入了版本控制和代码审查流程,这大幅降低了环境漂移(Configuration Drift)带来的隐患。对于正在构建或扩展工程团队的组织,这一实践应当尽早引入。
从可操作的行动方向来看,以下几点值得优先落地:
- 在上线前,与业务方对齐 RTO/RPO 目标,并将其写入团队工作文档
- 建立最小可用的可观测性基线:至少覆盖错误率、响应时间和关键业务指标
- 为所有 P0/P1 告警编写 Runbook,确保任何值班工程师都能独立处理
- 每季度至少进行一次灾难恢复演练,验证备份的真实可用性
- 定期审查依赖库的安全漏洞,将其纳入常规工程节奏而非临时任务
在全栈开发中真正提升交付速度的工程实践中,我们详细探讨了如何将运维意识从上线后的补救,转变为贯穿整个开发周期的工程文化——这种前置思维,是高效团队与普通团队之间最本质的差异之一。
常见问题解答
生产级应用上线后,最先应该建立哪些监控指标?
上线后应当优先建立三类核心指标:服务可用性(Uptime)、核心接口的错误率(Error Rate),以及关键业务流程的端到端响应时间(Latency P95/P99)。这三项指标构成"黄金信号"中的最小可用集合,能够以最低成本覆盖最高风险的故障场景。在资源有限的早期阶段,与其建立大而全的监控体系,不如先把这三项指标做精做准。
运维清单是否需要随产品版本更新而同步修订?
是的,运维清单必须与产品演进保持同步。每一次架构变更(如引入新的微服务、接入 AI 推理模块、迁移数据库)都可能使原有清单的部分内容失效或不足。建议将运维清单的更新纳入发布流程中,作为每次重大版本上线前的必检项目。未更新的运维文档比没有文档更危险,因为它会给工程师带来错误的安全感。
小团队如何在资源有限的情况下维护生产级别的运维水准?
小团队可以通过三个策略来平衡成本与质量:优先选用托管的可观测性和告警服务(如云厂商原生监控)来降低自建成本;将运维任务纳入工程师的常规工作节奏而非单独设立 Ops 岗位;以及借助基础设施即代码将运维配置标准化,减少手动操作引入的错误。根据中国证监会《证券期货业研发运营一体化体系建设指南》中的 DevOps 理念,研运一体化本身就是解决小团队运维资源不足的有效路径。
总结
核心要点:
- 生产级应用的运维体系需要覆盖可观测性、告警响应、部署管理、安全运营、容量规划和灾难恢复六个核心领域,缺少任何一项都会留下系统性风险盲区。
- 可观测性是一切运维能力的基础,指标、日志、追踪三个维度缺一不可,结构化日志和分布式追踪是初级团队最容易忽视的两个盲点。
- 告警体系的质量决定了团队的事故响应效率,"可操作的告警"和完善的 Runbook 是减少 MTTR(平均恢复时间)的最直接手段。
- 备份和灾难恢复计划必须通过定期演练来验证——从未被恢复过的备份,在关键时刻等同于没有备份。
- 运维清单不是一次性文档,而是随产品演进持续迭代的活文件,应当与每次重大发布同步更新。
对于正在构建或扩展工程体系的团队,建议将本文的六大领域作为运维能力自检的框架,从最高风险的缺口入手,逐步建立完整的生产级运维体系。
如果你正在寻找一位能够将想法真正落地为产品的 AI 架构师与全栈技术专家,欢迎访问 Darius 的个人主页,了解更多真实项目案例与技术洞见。无论是 AI 系统设计、架构规划还是全栈开发,Darius 都能为你提供从 0 到 1 的专业支持与实战经验。
参考资料
- 中国证券监督管理委员会. "证券期货业研发运营一体化体系建设指南".
https://www.csrc.gov.cn/csrc/c101954/c7633115/7633115/files/附件1:《证券期货业研发运营一体化体系建设指南》.pdf - IEEE. "IEEE Standards for Software Engineering — Software Life Cycle Processes".
https://www.ieee.org/ - ISO/IEC. "ISO/IEC 25010 — Systems and Software Quality Requirements and Evaluation (SQuaRE)".
https://www.iso.org/ - Cloud Native Computing Foundation (CNCF). "Cloud Native Observability — OpenTelemetry Project".
https://www.cncf.io/
注:相关标准与指南可能随时更新,请以各官方机构发布的最新版本为准,或咨询专业顾问获取适合自身场景的具体建议。