智能体 vs 普通工作流:本季度独立开发者的选择指南
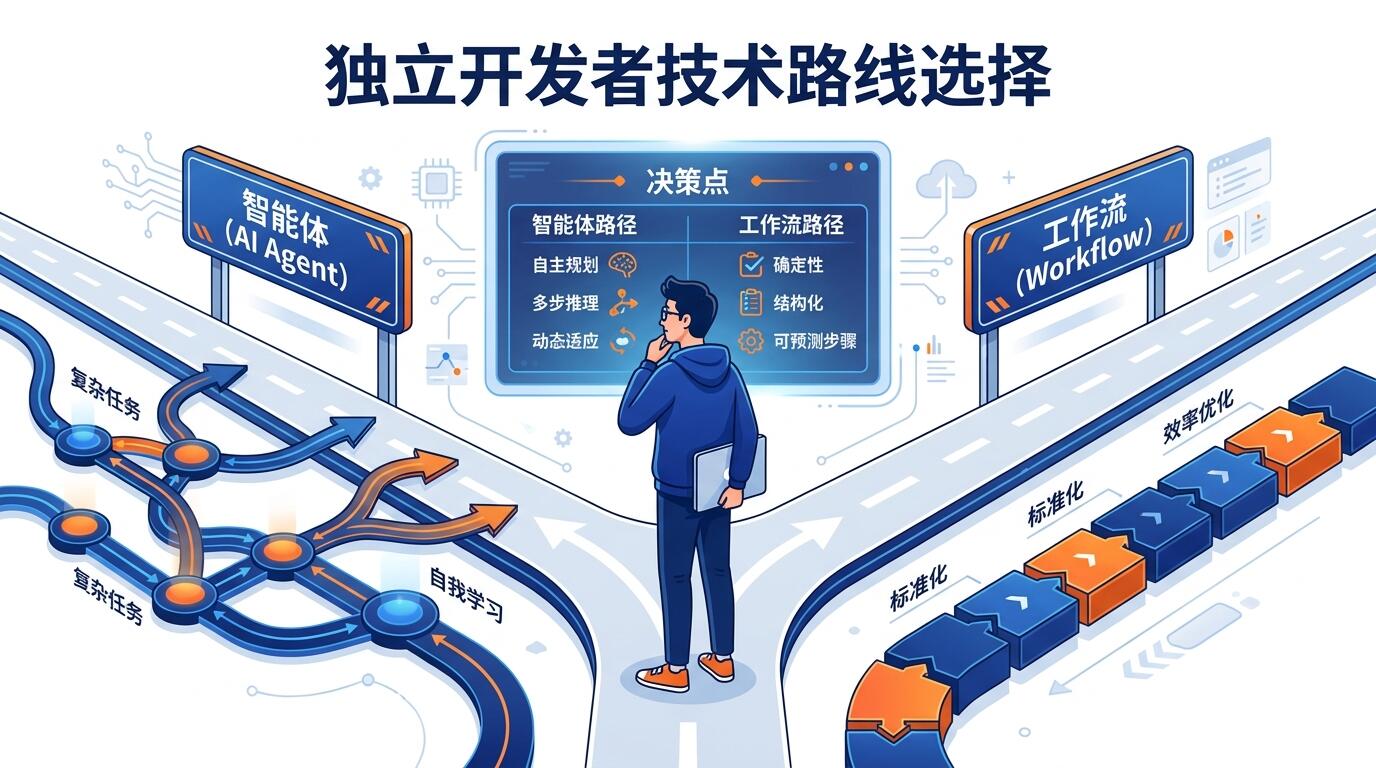
ALT: 独立开发者在选择 AI 智能体与普通工作流之间权衡决策的示意图
智能体还是工作流?帮独立开发者厘清本季度最值得关注的架构选择
AI 产品开发进入了一个微妙的分岔口:一方面,智能体(AI Agent)框架层出不穷,各类工具链和编排库竞相涌现;另一方面,大量独立开发者在实际落地时发现,过度复杂的智能体架构带来的调试成本、延迟问题和不可预测性,远超预期。本指南不讨论哪个"更先进",而是从工程实践角度出发,帮你在真实的项目约束下做出可落地的架构选择。
这篇文章面向正在构建第一个或第二个 AI 产品的独立开发者、小型技术团队负责人,以及想把 AI 能力集成进现有工具的产品工程师。如果你对"到底用不用 Agent"这个问题还没有答案,读完这篇文章你应该有一套可操作的判断框架。
开始之前:你需要明确的前提条件
在做架构选型之前,你需要先诚实地回答几个工程问题,而不是被"智能体更智能"这类叙事带跑。这一步通常被忽略,但在我们实际运营 AI 产品的过程中,它是避免过度工程化的第一道防线。
需要提前厘清的基本问题:
- 你的任务输入是结构化的还是开放式的?结构化输入(固定格式的表单、数据库查询、预定义的操作序列)天然适合工作流;开放式输入(用户自然语言请求、多意图混合场景)才是智能体擅长的地方。
- 你的容错空间有多大?工作流的每一步都是可预期的,出错路径容易定位;智能体的决策链路不透明,在生产环境中排查问题的成本显著更高。
- 你有没有足够的评估手段?部署智能体而没有完善的 evaluation pipeline,等于在盲飞。
- 你的预算压力来自哪里?智能体往往意味着更多的 LLM 调用(多轮推理、工具调用、自我修正),这直接影响每次请求的成本。
准备好进入选型流程的标志:
- 已经明确核心用例,并且能用 2-3 句话描述它的边界
- 有基础的日志和监控能力(哪怕是 console log + 手动检查)
- 清楚你的用户对响应延迟的容忍上限
- 读过或了解过你打算使用的框架的基本工作原理
时间投入方面,完整走完这套选型流程(包括小规模验证)通常需要数天到数周不等,具体取决于你的用例复杂度和现有代码库状态。
手把手选型:从需求到架构决策的完整路径
Step 1:定义你的任务边界,区分"确定性任务"与"探索性任务"
智能体(AI Agent)是一种能够感知环境、自主规划并调用工具来完成目标的 AI 系统,其核心特征是自主决策和多步推理。普通工作流(Workflow)是指预先定义好执行路径的自动化流程,每一步的输入和输出都是确定的。
判断你的任务属于哪一类,最直接的方法是问:"如果我来写这个逻辑的伪代码,我能写出完整的 if-else 树吗?"
如果答案是肯定的,你的任务基本上是确定性的,工作流足够应对。典型例子包括:从 RSS 抓取内容、调用 API 转换格式、触发邮件通知、生成固定模板的报告。
如果答案是否定的——因为用户的意图可能多样,或者你需要根据中间结果动态调整下一步——那才是智能体真正有价值的场景。典型例子包括:开放式的研究助手、能够自主决定搜索还是直接回答的对话系统、需要跨多个工具协调操作的复杂自动化任务。
Tip: 在实际项目中,我们见过最多的误判是:任务表面上看起来复杂(用户说的话很多样),但核心逻辑其实只有 3-5 条分支。这种情况用工作流配合一个分类步骤就能处理,不需要完整的智能体架构。
Step 2:评估不确定性的来源——任务的还是数据的?
即便确认了任务是"探索性"的,也不意味着你一定需要一个完整的 Agent 框架。不确定性有两种来源,处理方式截然不同:
任务不确定性:执行路径本身不固定,需要根据上下文动态选择工具或策略。这是真正适合智能体的场景。
数据不确定性:任务路径是固定的,但输入数据的格式或内容多变。这通常用健壮的解析逻辑 + LLM 做结构化抽取就能解决,不需要 Agent。
在我们构建 AI 简报的工程实践中,有一类典型的数据不确定性场景:抓取不同来源的文章,格式各异,但处理流程始终是「抓取 → 清洗 → 摘要 → 入库」。这个流程用确定性工作流处理完全够用,引入 Agent 只会增加不必要的复杂度。你可以在 智能体流水线深度报告:检索、验证、发布三阶段全解析 中看到这种架构分层的具体拆解。
Tip: 一个有效的测试方法是把你的 10-20 个真实输入案例列出来,看看这些案例的处理路径有多少是完全相同的。如果相似度高,工作流就够了。
Step 3:量化你的成本与延迟约束
这是很多开发者在早期跳过的步骤,但在生产环境中它会成为卡脖子问题。
智能体架构意味着:
- 每次用户请求可能触发多次 LLM 调用(规划、工具调用、结果验证、自我修正)
- 总延迟是各步骤延迟的累加,加上工具调用的网络延迟
- 如果引入了 ReAct 循环或自我反思机制,调用次数在极端情况下可能成倍增长
普通工作流意味着:
- LLM 调用次数固定且可预测
- 每次请求的成本上限明确
- 可以精确地做容量规划
如果你的产品需要低延迟响应(比如实时对话场景),或者你的 token 预算有严格上限,工作流的可控性是真实的竞争优势。关于实际运营成本的量化方式,本季度的智能体账单拆解 提供了一个具体的参考框架,可以对照你自己的用例估算。
Tip: 先用固定流程跑通 MVP,记录下每次请求的实际 token 消耗。有了基准数据,再评估是否值得引入 Agent 的额外复杂度。
Step 4:评估你的调试与可观测性能力
这是独立开发者最容易低估的维度。智能体的决策过程是概率性的,同样的输入在不同运行中可能产生不同的中间步骤,这让调试变得非常棘手。
生产级智能体至少需要以下可观测性基础:
- 完整的 trace 记录(每一步的输入、输出、调用的工具、耗时)
- 异常情况的自动告警
- 可以回放特定请求的能力
如果你目前还没有这些基础设施,有两个选择:一是先建设这些能力再引入 Agent,二是先用工作流上线,等产品稳定后再迭代。
在 AWS 发布的企业生产级智能体开发部署指南中,特别强调了可观测性是生产部署的前置条件,而不是后期优化项。这一点对独立开发者同样成立,规模小并不等于可以跳过监控。
Tip: 如果你使用 LangSmith、Langfuse 或类似工具,确保在开发阶段就接入,而不是等到出问题再补。
Step 5:识别你的场景是否真正需要自主规划
智能体最核心的能力是自主规划:在没有明确指令的情况下,自己决定下一步做什么。但在大多数独立开发者的场景中,这种能力是不必要的,甚至是有害的。
需要自主规划的真实场景特征:
- 目标模糊,执行路径需要根据探索结果动态调整
- 任务步骤之间存在强依赖,且依赖关系不能提前确定
- 用户期望系统能"主动发现问题"而非"被动执行指令"
不需要自主规划的场景特征:
- 用户明确知道他们要什么(哪怕表达方式不同)
- 任务的成功标准是明确可测量的
- 错误情况有限且可以枚举
在判断是否需要 Agent 时,一个实用的原则是:先用最简单的方法解决问题,只有当简单方法达到瓶颈时,才升级到更复杂的架构。
Tip: "RAG + 工作流编排"在很多被误判为需要 Agent 的场景中已经足够。不要为了技术上的新颖感引入不必要的复杂度。
Step 6:原型验证——用最低成本测试你的判断
在真正做架构决策之前,用小规模原型验证你的假设。具体方法:
针对你认为需要 Agent 的场景,先用硬编码的工作流模拟它——手动定义 2-3 个可能的执行路径,看看覆盖率能达到多少。如果覆盖了 80% 以上的真实案例,工作流就够了。
针对你认为工作流足够的场景,列出边界案例,看看是否有系统性的处理失败。如果有,分析失败的根本原因是路径不足(需要 Agent)还是输入解析不足(加强预处理就能解决)。
在正式开发前用真实用户验证新产品想法这篇文章中,有一套与此类似的验证逻辑,可以并行参考——架构选型的验证思路和产品想法的验证思路,在方法论上是相通的。
Tip: 原型阶段不要追求完美,追求的是快速获得真实数据。有数据的决策,远优于有直觉的决策。
Step 7:做出决策并定义迭代路径
综合以上步骤的评估结果,按照以下决策矩阵做最终选择:
| 任务特征 | 推荐架构 |
|---|---|
| 路径确定、输入结构化、成本敏感 | 普通工作流 |
| 路径确定、输入多样、有少量分支 | 工作流 + LLM 分类/提取 |
| 路径半确定、需要工具调用但步骤有限 | 轻量 Agent(单层规划) |
| 路径不确定、目标模糊、允许多步探索 | 完整 Agent 架构 |
定义迭代路径同样重要:先上线最简架构,收集真实用户数据,再根据实际的瓶颈决定是否升级。过早引入 Agent 的代价是调试成本和运营复杂度;过晚引入的代价是功能天花板。关键是知道你现在在矩阵的哪个格子里,以及什么信号会触发你向右移动。
常见误判与排查指南
| 症状 | 可能原因 | 修复方向 |
|---|---|---|
| 智能体频繁进入无限循环或超出步骤上限 | 任务目标定义模糊,Agent 无法判断何时完成 | 明确终止条件,为每类任务设置最大步骤数和 fallback 策略 |
| 工作流覆盖率不足,大量边缘输入处理失败 | 分支枚举不完整,或输入解析层太脆 | 增加 LLM 辅助的意图分类步骤,或用 few-shot 提示强化解析能力 |
| Agent 调用成本远超预期 | ReAct 循环触发次数失控,工具调用效率低 | 引入调用次数上限,优化工具描述,减少 Agent 的搜索空间 |
| 生产环境结果不稳定,同样输入产生不同输出 | Agent 规划层对上下文长度或顺序敏感 | 固定 system prompt 结构,减少 prompt 中的歧义,引入输出校验层 |
| 调试困难,无法定位失败发生在哪一步 | 缺乏 trace 级别的可观测性 | 接入结构化日志,记录每步的输入输出;使用专门的 LLM observability 工具 |
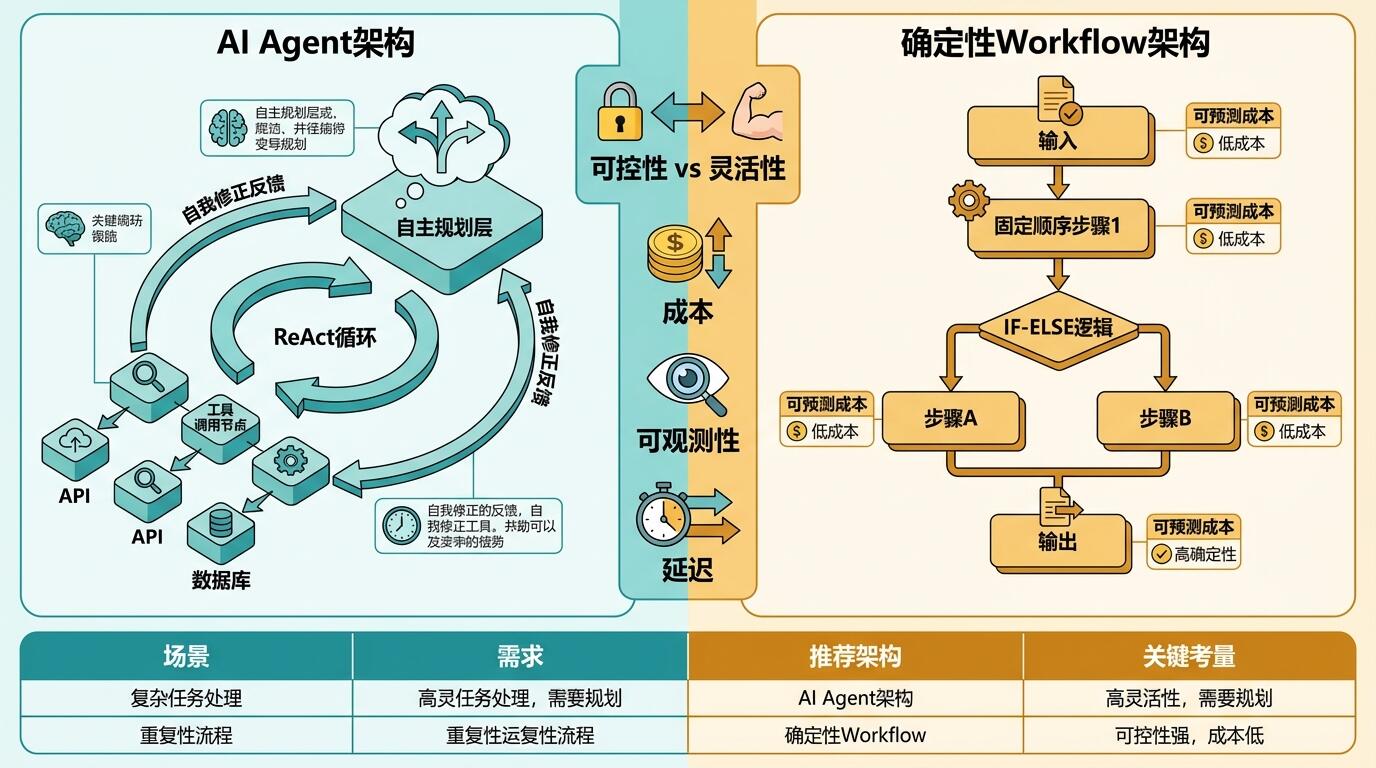
ALT: AI 智能体与普通工作流的架构对比图,展示独立开发者在实际项目中的选型决策路径与关键权衡点
超越基础选型:进阶思考与常见认知误区
混合架构是更务实的选择。 生产级 AI 产品很少是纯粹的"全 Agent"或"纯工作流"。更常见的模式是:用确定性工作流处理高频、低风险的核心路径,用 Agent 处理低频但需要灵活性的边缘场景。这种分层架构让你可以对不同路径独立优化成本和可靠性。
工具调用的质量比 Agent 框架的选择更重要。 很多开发者把时间花在比较 LangChain vs AutoGen vs CrewAI 上,但实际上,工具描述的质量、工具的错误处理、工具返回结果的格式,对 Agent 整体表现的影响远超框架本身的差异。
"Agent 总是比工作流更强"是错误的认知。 Agent 的优势是灵活性,代价是可控性。在容错空间小、用户对一致性要求高的场景(比如金融数据处理、医疗信息查询),工作流的可预期性是真正的竞争优势,而不是技术保守主义。
状态管理是 Agent 复杂度的真正来源。 多步骤 Agent 需要在步骤之间传递上下文状态,这引入了额外的工程复杂度。如果你没有清晰的状态管理策略(哪些状态需要持久化、哪些可以丢弃、如何处理状态冲突),Agent 的故障排查会变得非常痛苦。
评估框架先于架构选型。 如果你还没有办法系统地评估你的 AI 产品输出质量,那么无论选择 Agent 还是工作流,你都在盲目迭代。建立评估体系是架构决策之前必须完成的基础工作。在评估 AI 开发工具时,这一点同样适用——可以参考本季度签约前评估 AI 开发工具的关键要点中的评估框架来检验你自己的工具链选择。
常见问题
Q1:如何判断我的场景是否真的需要多步推理?
判断多步推理是否必要,核心标准是:单次 LLM 调用能否在不访问外部信息的情况下生成可用的输出。如果你的任务需要先查询数据、根据查询结果决定下一步动作、再执行操作,那才是真正需要多步推理的场景。如果只是输入复杂但推理路径单一,用结构化提示配合单次调用通常就够了,不需要引入完整的 Agent 规划层。
Q2:开源 Agent 框架与自己实现的工作流,哪种更适合独立开发者?
开源 Agent 框架降低了启动门槛,但引入了框架本身的依赖和学习成本。对于简单的自动化场景,自己实现一个轻量工作流(几百行代码)在可控性和调试效率上往往优于重量级框架。对于复杂的多工具协调场景,成熟框架的工具生态和社区支持能节省大量重复建设。选择标准是你的核心瓶颈在哪里,而不是哪个框架更流行。
Q3:从工作流升级到智能体架构,需要投入多大的改造成本?
升级成本主要来自三个方面:现有代码结构的重构、可观测性基础设施的补建、以及评估体系的扩展。如果你的工作流设计时就保持了模块化,升级成本会显著降低。从工程实践角度,建议在工作流阶段就将各功能模块封装为工具(Tool)接口,这样在后续需要时,直接被 Agent 调用无需大规模改写。整体来看,改造周期从数天到数周不等,具体取决于现有代码的可维护性。
核心要点
智能体与普通工作流的选择,本质上是可控性与灵活性之间的权衡,而不是技术先进程度的比较。
三个值得记住的判断原则:
第一,从任务边界出发,而不是从技术趋势出发。能用确定性流程解决的问题,用工作流更可靠、更经济。只有当任务的执行路径本身不可预先定义时,Agent 的自主规划能力才真正有价值。
第二,可观测性是 Agent 部署的前置条件,不是后期优化项。没有完善的 trace 和监控,智能体在生产环境中的失败会非常难以定位。
第三,混合架构在实践中往往比纯粹的"全 Agent"或"纯工作流"更实用。用工作流守住核心路径,用 Agent 处理需要灵活性的边缘场景,是当前阶段最具性价比的架构策略。
下一步行动建议:列出你当前产品的核心用例,对照本文的决策矩阵逐一评估,先从最高频的用例开始做架构验证,不要试图一次性为所有场景选定架构。
订阅 Darius 简报——每期精选 5–10 条真正值得关注的 AI 动态,每条均附一手来源与来自生产环境的实战解读。由一位同时运营多款 AI 产品的工程负责人亲笔撰写,帮你把最新的模型发布、论文与政策变化,直接转化为可执行的产品决策。
参考资料
- 中国信通院. "智能体技术和应用研究报告".
https://www.lib.szu.edu.cn/sites/szulib/files/2025-07/%E4%B8%AD%E5%9B%BD%E4%BF%A1%E9%80%9A%E9%99%A2%EF%BC%9A%E6%99%BA%E8%83%BD%E4%BD%93%E6%8A%80%E6%9C%AF%E5%92%8C%E5%BA%94%E7%94%A8%E7%A0%94%E7%A9%B6%E6%8A%A5%E5%91%8A.pdf - Amazon Web Services. "企业生产级智能体 - 开发部署指南".
https://d1.awsstatic.com/onedam/marketing-channels/website/aws/zh_CN/events/approved/pdf/summit-2026/guide-to-developing-and-deploying-production-ready-enterprise-ai-agents.pdf - Jimmy Song. "Agentic Design Patterns(智能体设计模式)".
https://assets.jimmysong.io/books/agentic-design-patterns-zh-20251208.pdf
注:上述资料内容随领域发展可能持续更新,建议查阅最新版本或咨询相关领域专业人士。